4. 프롬프트 엔지니어링과 컨텍스트 엔지니어링
모델이 보는 입력이 곧 모델이 내는 출력을 결정하므로, 프로토타입 단계의 품질은 모델 선택보다 프롬프트 한 줄과 컨텍스트 전체를 어떻게 설계하느냐에서 갈립니다. FDE가 고객의 "답이 이상하다", "비용이 너무 든다"는 말을 모델 탓이 아니라 입력 설계 문제로 먼저 진단하는 언어가 여기서 나옵니다.
학습 동기: 이 장을 읽으면 다단계 문제에 사고의 연쇄, 프롬프트 체이닝, 생각의 나무 중 무엇을 쓸지 고를 수 있고, 긴 대화와 반복 호출에서 컨텍스트를 어떻게 구성·압축·캐싱할지 비용 숫자와 함께 설명할 수 있습니다.
선행 가정: LLM이 토큰을 하나씩 이어 쓰는 자기회귀 방식이라는 점(2.3, 2.4)과 컨텍스트 윈도우의 한계(2.16, 2.17)를 알고 있으면 충분합니다. 4.1은 추론 모델(3.2)을, 4.6은 KV 캐시(10.3)를 이미 안다고 가정하지 않고 필요한 만큼 설명하며, 코드는 짧은 파이썬 몇 줄만 읽을 수 있으면 됩니다.
4.1 사고의 연쇄 프롬프팅(Chain-of-Thought, CoT)
원문: How does Chain-of-Thought (CoT) Prompting work?
LLM에게 답만 요구하면 다단계 문제에서 틀리기 쉽고, 풀이 과정을 먼저 쓰게 하면 정확도가 오릅니다. 이 절은 그 한 줄짜리 기법이 왜 듣는지와 어디까지 믿을 수 있는지를 다룹니다(2026년 7월 글 기준).
4.1.1 바로 답하려 할 때의 문제
**프롬프트(prompt)**는 모델에게 주는 텍스트 지시이며, LLM은 방대한 텍스트를 읽고 다음 단어를 예측하도록 학습된 모델입니다(2.2 참조). LLM은 답 전체를 한 번에 보지 않고 단어를 하나씩 이어 쓰는 자기회귀(autoregression) 방식으로 답을 만듭니다(2.3 참조). 사람이 문장을 말할 때 한 단어씩 내뱉는 것과 같습니다.
다음 문제를 보겠습니다.
가게에 사과 12개가 있습니다. 오전에 5개를 팔고 저녁에 8개를 들여왔습니다. 지금 사과는 몇 개입니까?
정답은 15개이며, 12 - 5 = 7, 7 + 8 = 15의 두 단계로 나옵니다. 그런데 "최종 숫자만 답하라"고 요구하면 모델은 중간 계산 없이 최종 숫자를 곧바로 예측해야 합니다.
- 쉬운 문제는 맞히지만, 단계가 늘어나면 엉뚱한 숫자로 건너뛰는 경우가 늘어납니다.
- 단어를 하나씩 쓰는 구조라서 최종 숫자를 너무 일찍 확정하면 되돌아가 고칠 기회가 없습니다.
- 원인은 모델의 지능 부족이 아니라 생각할 공간을 주지 않은 입력 방식에 있습니다.
고객이 "답만 짧게 나오게 해 달라"고 요구했는데 계산·판단이 섞인 업무라면, 정확도가 떨어지는 원인이 이 제약일 수 있다는 점부터 확인합니다.
4.1.2 Zero-shot CoT vs Few-shot CoT
사고의 연쇄(Chain-of-Thought, CoT) 프롬프팅은 최종 답 전에 추론 단계를 글로 쓰게 하는 기법입니다. **생각(thought)**은 추론의 작은 한 걸음이고, **연쇄(chain)**는 그 걸음들이 앞뒤로 이어진 것입니다. 사과 문제의 연쇄는 "12개로 시작 → 5개 판매로 7개 → 8개 입고로 15개 → 최종 15"입니다.
flowchart LR
  Q1[질문] --> A1["최종 숫자 추측"] --> R1["답 (자주 틀림)"]
  Q2[질문] --> T1["생각 1: 12개로 시작"] --> T2["생각 2: 12-5=7"] --> T3["생각 3: 7+8=15"] --> R2["최종 답 15"]
그림 4.1.2 — CoT 없이는 질문에서 답으로 한 번에 건너뛰고, CoT에서는 작은 생각을 거쳐 마지막 생각이 답이 됩니다.
CoT를 일으키는 방법은 두 가지입니다.
- Zero-shot CoT: 예시를 하나도 주지 않고 "단계별로 생각해 봅시다(Let's think step by step)" 같은 한 줄만 덧붙입니다. 이 한 줄이 방아쇠가 되어 모델이 스스로 단계를 씁니다. 예: "기차가 1시간에 60km를 가면 3시간에 몇 km입니까? 단계별로 생각해 봅시다."
- Few-shot CoT: 풀이 과정까지 적은 문제를 한두 개 먼저 보여 준 뒤 진짜 질문을 던집니다. 모델은 예시의 풀이 문체를 따라 합니다.
Few-shot CoT 프롬프트의 모양은 다음과 같습니다. 핵심은 예시의 답에 결과만 아니라 과정이 들어 있다는 점입니다.
Q: 상자에 펜 4개가 있다. 3개를 더한다. 몇 개인가?
A: 4개로 시작한다. 3개를 더하면 4 + 3 = 7. 답은 7이다.

Q: 병에 사탕 10개가 있다. 6개를 먹는다. 몇 개인가?
A: 10개로 시작한다. 6개를 먹으면 10 - 6 = 4. 답은 4이다.

Q: 선반에 책 8권이 있다. 5권을 더한다. 몇 권인가?
A:
앞의 두 예시를 본 모델은 세 번째 질문에 "8권으로 시작한다. 5권을 더하면 8 + 5 = 13. 답은 13이다."로 답합니다.
| 항목 | Zero-shot CoT | Few-shot CoT |
|---|---|---|
| 주는 예시 | 없음 | 풀이가 달린 예시 몇 개 |
| 추론 유도 방식 | "단계별로 생각해 봅시다" 같은 한 줄 | 단계가 보이는 풀이 예시 |
| 프롬프트 길이 | 짧음 | 김 |
| 작성 노력 | 적음 | 예시를 직접 써야 해서 큼 |
| 적합한 경우 | 빠르게 풀 흔한 문제 | 어렵거나 형식이 특이한 문제 |
표 4.1.2 — 한 줄 지시로 시작하고, 출력 형식이 특이하거나 어려우면 풀이 예시를 추가합니다.
먼저 Zero-shot CoT를 시도하고, 답의 형식이나 추론 방식이 고객 도메인과 어긋날 때만 풀이 예시를 붙이는 순서가 비용 면에서 합리적입니다.
4.1.3 추론 체인 단계별 예제
조금 더 큰 문제로 연쇄가 이어지는 모양을 보겠습니다.
반에 학생이 30명입니다. 12명이 축구를 합니다. 나머지 학생의 절반이 크리켓을 합니다. 크리켓을 하는 학생은 몇 명입니까?
- 단계 1: 전체는 30명입니다.
- 단계 2: 축구를 하는 12명을 빼면 남은 학생은
30 - 12 = 18명입니다. - 단계 3: 남은 18명의 절반이 크리켓을 하므로
18 / 2 = 9명입니다. - 단계 4: 최종 답은 9명입니다.
flowchart LR
  S1["단계 1: 전체 = 30"] --> S2["단계 2: 남은 수 = 30-12 = 18"] --> S3["단계 3: 크리켓 = 18/2 = 9"] --> S4["최종 답 = 9"]
그림 4.1.3 — 각 단계가 앞 단계의 결과를 입력으로 받아 연쇄를 이룹니다.
- 단계 2는 단계 1의 전체 인원을, 단계 3은 단계 2의 남은 인원을 사용합니다. 이 의존 관계가 "연쇄"라는 이름의 근거입니다.
- 한 번에
9를 추측하면 쉽게 어긋나지만, 단계마다 검산하며 가면 궤도를 유지합니다. - 단계 하나가 틀리면 뒤 단계가 모두 틀어지므로, 중요한 업무에서는 중간 값을 로그로 남겨 사람이 점검할 수 있게 합니다.
연쇄가 눈에 보인다는 것은 오류가 난 단계를 찾아낼 수 있다는 뜻이며, 이 점이 감사(audit)가 필요한 고객 업무에서 CoT를 쓰는 실용적 이유가 됩니다.
4.1.4 CoT가 작동하는 이유와 유용한 곳
자기회귀 모델은 이미 쓴 단어를 다음 단어의 입력으로 읽습니다. 추론 문장을 쓰면 그 문장이 다음 계산의 입력에 포함되므로, 모델은 아무것도 없는 상태에서 추측하는 대신 눈앞에 적힌 올바른 단계 위에서 답을 짓습니다. 암산이 어려운 사람이 종이에 중간 계산을 적는 것과 같습니다.
- 큰 문제를 쪼개면 각 단계가 쉬워지고, 모델은 작고 단순한 단계를 잘합니다.
- 모델이 더 똑똑해지는 것이 아니라, 구조화된 생각의 공간을 얻는 것입니다.
- 일부 최신 모델은 이런 추론을 프롬프트 없이 스스로 생성하도록 학습되어 있습니다(3.2 참조). 그 경우 "단계별로 생각해 봅시다"를 덧붙이는 효과는 작아지고, 추론 모델에는 오히려 불필요할 수 있습니다.
CoT가 어울리는 업무는 답이 단일 사실이 아니라 여러 단계를 거쳐 나오는 경우입니다.
- 수학 문장제처럼 작은 계산이 여러 개 필요한 문제
- 한 단계만 틀려도 답 전체가 깨지는 논리 퍼즐
- 앞선 사실에 뒤의 답이 의존하는 다단계 질문
- 몇 가지 선택지를 저울질해야 하는 의사결정
- 지문의 여러 부분을 연결해야 하는 독해
한 번의 잘못된 첫걸음이 전체를 무너뜨리는 문제에는 여러 경로를 시도하고 평가해 되돌아가는 방식이 따로 있습니다(4.3 참조).
주의할 점도 세 가지입니다.
- 단순 질문에는 불필요합니다. "프랑스의 수도는?"은 단일 사실이라 쪼갤 단계가 없습니다.
- 쓰인 추론을 그대로 믿으면 안 됩니다. 그럴듯해 보이는 단계가 틀린 답으로 이어질 수 있으므로, 중요한 업무는 단계를 사람이나 검증 로직이 확인합니다.
- 비용과 지연이 늘어납니다. 단계를 쓰는 만큼 출력 토큰이 늘고 시간과 요금이 더 듭니다. 대부분은 정확도 상승으로 상쇄되지만 업무별로 따져 봅니다.
고객 현장에서는 "이 업무가 다단계 판단인가, 단일 사실 조회인가"를 먼저 물어 CoT 적용 여부를 정하고, 적용할 때는 출력 토큰 증가분을 월 비용에 반영해 견적에 포함합니다.
4.2 프롬프트 체이닝(Prompt Chaining)
원문: How does Prompt Chaining work?
큰 작업을 한 프롬프트에 몰아넣으면 어디서 틀렸는지 알 수 없고, 작은 프롬프트로 나눠 앞 출력을 뒤 입력으로 넘기면 단계별로 점검할 수 있습니다. 이 절은 그 분해 방식과 비용·오류 전파의 대가를 다룹니다(2026년 7월 글 기준).
4.2.1 필요한 이유
**프롬프트 체이닝(Prompt Chaining)**은 하나의 큰 작업을 여러 개의 작은 프롬프트로 쪼개고, 한 프롬프트의 출력을 다음 프롬프트의 입력으로 넘기는 방식입니다. 프롬프트(Prompt)에 사슬처럼 이어 붙인다(Chaining)는 말이 더해진 이름입니다. 입력(프롬프트)을 넣으면 출력(응답, response)이 나오는 호출 한 번을 한 고리로 보고, 고리를 이어 붙이는 셈입니다.
용어 주의: CoT(4.1 참조)는 모델 하나가 한 프롬프트 안에서 단계별로 추론하는 기법이고, 프롬프트 체이닝은 서로 별개의 프롬프트 여러 개를 이어 붙이는 기법입니다. 한쪽은 한 호출의 내부, 다른 쪽은 호출과 호출 사이의 구조입니다.
다음 작업으로 두 접근을 비교해 보겠습니다. "긴 고객 후기를 읽고, 고객이 만족했는지 화났는지 판단한 뒤, 정중한 답장을 쓰라"는 작업입니다.
| 접근 | 구성 | 결과 |
|---|---|---|
| 접근 1: 큰 프롬프트 하나 | 후기 읽기, 감정 판단, 답장 작성을 한 번에 요구 | 감정 판단이 틀릴 수 있고 답장이 어수선해짐. 틀려도 어느 부분 탓인지 찾기 어려움 |
| 접근 2: 프롬프트 체이닝 | 단계 1은 후기를 읽고 감정(만족/화남)만 출력, 단계 2는 그 감정에 맞는 답장 작성 | 각 프롬프트가 일 하나만 담당. 문제가 생긴 단계를 바로 특정 |
표 4.2.1 — 한 프롬프트가 여러 일을 맡으면 오류를 찾고 고치기 어렵고, 나누면 단계별로 점검할 수 있습니다.
프롬프트 체이닝이 주는 이점은 다섯 가지입니다.
- 단계가 단순합니다. 프롬프트마다 작은 일 하나만 맡으므로 답의 품질이 올라갑니다.
- 오류를 고치기 쉽습니다. 최종 답이 틀리면 단계마다 확인해 문제가 시작된 곳을 짚습니다.
- 재사용이 쉽습니다. 같은 작은 프롬프트를 여러 체인에서 씁니다.
- 통제가 좋습니다. 각 단계의 출력을 확인하고, 다음 단계로 넘기기 전에 고칠 수도 있습니다.
- 사고 순서가 분명해집니다. 큰 작업을 작은 단계로 나누면 모델도 사람처럼 순서대로 일합니다.
짧은 프롬프트는 한 가지 이점을 더 줍니다. 중요한 내용이 긴 컨텍스트의 한가운데에 묻히지 않습니다(2.17 참조).
고객이 "프롬프트 하나에 요구사항을 서른 줄 적었는데 가끔 이상한 답이 나온다"고 말하면, 요구사항을 역할별로 쪼갤 수 있는지부터 점검합니다.
4.2.2 단계별 동작과 코드 예제
동작 원리는 단순합니다. 단계 1의 출력(Output 1)을 단계 2의 프롬프트 안에 넣고, 단계 2의 출력(Output 2)을 단계 3의 프롬프트 안에 넣어 마지막 출력이 최종 답이 됩니다.
flowchart LR
  P1["프롬프트 단계 1"] -- "출력 1" --> P2["프롬프트 단계 2"] -- "출력 2" --> P3["프롬프트 단계 3"] --> F["최종 답"]
그림 4.2.2 — 각 단계의 출력이 다음 단계의 입력이 되는 것이 프롬프트 체이닝의 핵심입니다.
공장 라인에 비유하면 이렇습니다.
| 프롬프트 체이닝 | 현실 비유 |
|---|---|
| 전체 작업 | 팀이 받은 프로젝트 |
| 작은 프롬프트 하나 | 팀원 한 명이 맡은 일 하나 |
| 앞으로 넘기는 출력 | 앞 팀원이 다음 팀원에게 넘기는 결과물 |
| 최종 답 | 완성된 프로젝트 |
실제 예로, 블로그 운영자가 긴 기사를 짧은 소셜 미디어 게시글로 바꾸는 체인을 보겠습니다.
- 요약: "다음 기사를 짧은 문장 3개로 요약하라"고 요청하면 3문장 요약(출력 1)이 나옵니다.
- 게시글화: 출력 1을 넣고 "다음 요약을 짧고 눈길을 끄는 소셜 게시글로 바꿔라"고 요청합니다. 모델은 긴 기사를 다시 보지 않고 요약만 보며, 결과가 출력 2입니다.
- 해시태그: 출력 2를 넣고 "이 게시글 끝에 관련 해시태그 3개를 붙여라"고 요청하면 게시 가능한 최종 답이 나옵니다.
같은 체인을 Python으로 쓰면 다음과 같습니다. ask_ai는 프롬프트를 모델에 보내고 응답을 돌려주는 가상의 도우미 함수입니다.
article = "<긴 기사 본문>"

summary    = ask_ai("Summarize this article in 3 short sentences: " + article)
post       = ask_ai("Turn this summary into a catchy social media post: " + summary)
final_post = ask_ai("Add 3 relevant hashtags to this post: " + post)- 단계 1은
article을 받아summary를 돌려줍니다. - 단계 2는
article이 아니라summary만 받아post를 돌려줍니다. - 단계 3은
post를 받아final_post를 돌려줍니다. - 변수에 답을 담아 다음 프롬프트에 붙이는 평범한 코드이므로 LangChain 같은 프레임워크 없이도 짤 수 있고, 프레임워크는 이 배선을 단계마다 손으로 쓰지 않게 해 줍니다(7.4 참조).
체인의 단계 사이에 변수가 있다는 것은 그 지점에 검증 코드나 로깅을 끼울 수 있다는 뜻이므로, 고객 시스템에서는 이 접점을 감사 로그와 사람 승인 지점으로 씁니다.
4.2.3 흔한 체이닝 패턴
체인은 모양에 따라 세 가지 패턴으로 나뉘며, 작업 성격에 맞춰 고릅니다.
| 패턴 | 흐름 | 예 |
|---|---|---|
| 직선형(straight chain) | 단계 1 → 2 → 3으로 갈래도 되돌아감도 없이 일직선 | 위의 요약 → 게시글 → 해시태그 체인 |
| 추출 후 실행(extract, then act) | 텍스트에서 핵심 정보를 뽑고, 그 정보로 다음 일을 함 | 메시지에서 이름과 이메일을 뽑고, 그 이름을 써서 개인화 답장을 작성 |
| 생성 후 점검(generate, then check) | 먼저 쓰고, 다음 프롬프트에서 스스로 검토해 오류를 고침 | 코드를 작성한 뒤 모델이 리뷰하여 버그를 수정 |
표 4.2.3 — 세 패턴은 모두 앞 단계의 출력을 뒤 단계의 입력으로 넘기는 구조를 공유합니다.
- 직선형은 분기와 되돌아감이 없는 가장 단순한 형태이며, 분기나 되돌아감이 필요해지면 그래프로 설계하는 영역에 들어섭니다(7.3 참조).
- 생성 후 점검은 모델이 자기 출력을 검토하고 개선하는 Reflection 에이전트의 원리와 같습니다(6.6 참조).
- 추출 후 실행은 뽑은 값이 틀리면 뒤 단계가 모두 틀리므로, 추출 단계의 출력은 형식과 값 범위를 코드로 검사하기 좋은 후보입니다.
고객 업무가 어느 패턴에 해당하는지 확인하면 단계 수와 검증 위치를 바로 정할 수 있습니다.
4.2.4 주의할 점
체인은 강력하지만 대가가 있습니다. 세 가지를 지켜야 합니다.
- 호출 수만큼 시간과 비용이 늘어납니다. 단계마다 모델 호출이 한 번씩 추가되므로 5단계 체인은 5번 호출합니다. 체인은 필요한 만큼만 길게 둡니다.
- 오류가 아래로 번집니다. 단계 1이 틀린 출력을 내면 단계 2는 그 틀린 출력 위에서 일하고, 실수가 체인 전체로 전파됩니다. 앞쪽 단계가 맞는지 확인한 뒤에 다음으로 넘어가도록 설계합니다.
- 다음 단계에 필요한 정보만 넘깁니다. 위 예에서 단계 2는 긴 기사 전체가 아니라 짧은 요약만 받았습니다. 프롬프트가 작고 빠르고 초점이 분명하게 유지됩니다.
"체인을 짧게 유지하고, 앞 단계를 검증하고, 필요한 것만 넘긴다"가 세 가지 주의의 요약입니다. 고객에게 체인 설계를 설명할 때는 단계 수에 비례해 지연과 요금이 늘어난다는 점을 견적과 응답 시간 목표에 같이 적습니다.
4.2.5 사용 시점
작업이 크거나 안에 뚜렷한 단계가 여럿 있으면 체인을 씁니다.
- 문서를 읽은 뒤 그 문서에 대한 질문에 답하기
- 텍스트를 번역한 뒤 더 정중한 문체로 다듬기
- 양식에서 데이터를 뽑은 뒤 깨끗한 형식으로 저장하기
- 초안 작성 후 개선하고, 다시 오류를 점검하기
한 덩어리 지시문 안에 여러 부분이 얽혀 있는 느낌이 든다면 체인으로 쪼개라는 강한 신호입니다. 반대로 작업이 단순하고 작으면 프롬프트 하나로 충분하며, 체인을 쓰면 호출 수만 늘어납니다. 여러 호출을 묶어 조율하는 상위 구조는 오케스트레이션으로 이어집니다(6.15 참조).
고객 요청을 받았을 때 "이 지시문을 사람 세 명에게 나눠 맡기겠는가"를 묻고, 그렇다면 체인, 아니라면 단일 프롬프트로 시작하는 것이 판단 기준입니다.
4.3 생각의 나무(Tree of Thoughts)
원문: How does Tree of Thoughts work?
CoT는 한 줄로만 걷기 때문에 첫걸음이 틀리면 되돌릴 수 없고, 생각의 나무는 여러 갈래를 시도해 평가하고 막히면 되돌아갑니다. 이 절은 그 구조와 Game of 24 예제, 그리고 비용이라는 대가를 다룹니다(2026년 10월 글 기준).
4.3.1 CoT의 한계
LLM은 토큰(token)(단어 또는 단어의 일부)을 왼쪽에서 오른쪽으로 하나씩 이어 쓰며, 한 번 쓴 토큰은 고치지 않고 앞으로만 나아갑니다(2.4 참조). 퍼즐을 푸는 친구에게 "모든 단계를 소리 내어 말하되 '잠깐, 다른 방법으로 해 볼게'는 절대 말하지 말라"고 제한을 건 것과 같습니다. 초반에 한 걸음을 잘못 디디면 답 전체가 틀어집니다.
CoT(4.1 참조)는 "단계별로 생각해 봅시다"로 추론 과정을 쓰게 합니다. 예를 들어 "사과 23개에서 20개를 팔고 6개를 들여오면?"에는 23 - 20 = 3, 3 + 6 = 9로 단계를 적어 9를 얻습니다. 그러나 CoT는 여전히 사슬 하나입니다.
flowchart TD
  S[시작] --> A[단계 1] --> B[단계 2] --> C[단계 3] --> D[답]
그림 4.3.1 — CoT는 첫 단계를 하나 고르면 뒤를 모두 그 위에 쌓고 돌아보지 않습니다.
- 단계 1이 나쁜 선택이면 뒤의 모든 단계가 나쁜 토대 위에 세워집니다.
- "이 길은 안 되니 단계 1부터 다시 고르자"고 말할 수단이 없습니다.
- 사람은 스도쿠나 미로에서 하나를 시도해 막다른 길이면 돌아오고, 몇 가지 선택지를 머릿속에서 비교한 뒤 고릅니다. 즉 탐색합니다. CoT는 직선으로만 걷습니다.
첫 수의 선택이 결과를 좌우하는 업무(일정 계획, 조합 탐색, 제약 충족 문제)에서 CoT 정확도가 낮다면 한계는 프롬프트 문구가 아니라 직선 구조일 수 있습니다.
4.3.2 생각(thought) 단위 분해·생성·평가
**생각의 나무(Tree of Thoughts, ToT)**는 LLM이 가능한 추론 경로를 나무 모양으로 여러 개 만들고, 각 경로가 얼마나 유망한지 판단하고, 탐색으로 좋은 경로만 남기고 나쁜 경로는 버리는 방법입니다. 2023년 Princeton 대학과 Google DeepMind 소속 Shunyu Yao 등이 낸 논문 "Tree of Thoughts: Deliberate Problem Solving with Large Language Models"에서 제안되었습니다. 네 부분으로 이루어집니다.
flowchart TD
  P[문제] --> A[생각 A]
  P --> B[생각 B]
  P --> C["생각 C (버림)"]
  A --> A1["A1"] --> ANS[답]
  A --> A2["A2 (버림)"]
  B --> B1["B1"] --> B2["B2"]
그림 4.3.2 — 첫 생각을 셋 시도해 C와 A2를 버리고 A1이 답에 도달합니다.
**생각(thought)**은 문제를 푸는 길 위의 의미 있는 중간 걸음 하나입니다. 토큰 하나보다 크고 전체 답보다 작으며, 크기는 문제에 따라 달라집니다.
- 수학 퍼즐에서는
4 + 9 = 13같은 식 하나입니다. - 크로스워드에서는 격자에 채우는 낱말 하나입니다.
- 창작에서는 이야기의 짧은 계획입니다.
- **상태(state)**는 지금까지의 전부, 즉 원문제와 현재 경로의 모든 생각입니다. 나무의 각 상자가 상태입니다.
네 부분은 다음과 같습니다.
- 문제를 생각으로 나누기. 생각이 너무 작으면(낱말 하나) 좋고 나쁨을 판단할 수 없고, 너무 크면(전체 답) 서로 다른 선택지를 여럿 만들 수 없습니다. 선택지를 몇 개 만들고 판단도 할 수 있는 크기를 시스템 설계자가 용도에 맞춰 정합니다.
- 생각 생성(thought generator). 각 상태에서 다음 생각 후보를 몇 개 만듭니다. 두 방식이 있습니다.
- Sample: 같은 질문을 여러 번 따로 던져 매번 조금씩 다른 생각을 받습니다. 열린 선택지가 많은 창작에 맞습니다.
- Propose: 한 번의 답변에서 서로 다른 후보를 여럿 나열하게 합니다. 선택지가 작고 한정된 수학 퍼즐에 맞고, 같은 생각이 반복되는 것을 피합니다.
- 생각 평가(state evaluator). 나무는 빠르게 자라 모든 가지를 따라갈 수 없으므로, 같은 LLM이 각 상태의 유망함을 판단합니다.
- Value: 상태 하나를 보여 주고 평가시킵니다. 예컨대 목표에 닿는 것이 확실함(sure), 가능성 있음(likely), 불가능(impossible)으로 라벨을 달고 이를 점수로 바꿉니다.
- Vote: 모든 상태를 한꺼번에 보여 주고 "가장 유망한 것은?"을 물어 투표하게 합니다. 투표를 몇 번 반복해 집계합니다.
- 탐색(search algorithm). 나무를 어떻게 걸을지 정합니다(4.3.3 참조).
평가의 예로 "남은 숫자 4, 4, 10" 상태는 10 - 4 = 6, 6 * 4 = 24이므로 sure이고, "남은 숫자 1, 1, 2" 상태는 만들 수 있는 최대가 (1 + 1) * 2 = 4이므로 impossible입니다. 체스 선수가 끝까지 두지 않고 판을 보고 "이기는 판" 또는 "지는 판"이라고 말하는 것과 같은 어림 판단입니다.
- 판단을 안정시키려면 같은 평가 질문을 여러 번 던져 점수를 합산합니다. sure에는 큰 점수, likely에는 작은 점수, impossible에는 0에 가까운 점수를 줍니다.
- 판단은 완벽할 필요는 없고 탐색을 이끌 만큼만 좋으면 됩니다.
- LLM이 LLM의 결과를 채점하는 방식은 별도로 정리됩니다(8.2 참조).
FDE 관점에서는 생각의 크기, 후보 생성 방식(Sample 또는 Propose), 평가 방식(Value 또는 Vote)이 모두 고객 문제마다 새로 설계해야 하는 변수라는 점이 비용 견적의 전제가 됩니다.
4.3.3 BFS vs DFS 탐색
논문은 잘 알려진 두 탐색을 씁니다.
**너비 우선 탐색(Breadth-First Search, BFS)**은 층마다 생성·평가한 뒤 가장 좋은 몇 개만 남기고 나머지를 버리며 한 층씩 내려갑니다. 층마다 남기는 상태의 수를 너비 제한(breadth limit) b라 하며, 예를 들어 b = 5이면 매 층에서 상위 5개만 다음 층으로 갑니다. 여러 라운드의 오디션에서 라운드마다 상위 5명만 올라가는 것과 같습니다. 단계 수가 작고 고정된 문제, 예컨대 항상 정확히 3단계가 필요한 수학 퍼즐에 맞습니다.
**깊이 우선 탐색(Depth-First Search, DFS)**은 가장 유망한 경로를 먼저 깊이 따라가다가, 상태가 가망 없다고 판단되면 직전 상태로 돌아가 다음 선택지를 시도합니다. 이렇게 돌아가는 일을 **백트래킹(backtracking)**이라 합니다. 미로에서 복도 하나를 끝까지 걸어 벽에 닿으면 마지막 갈림길로 돌아와 다른 복도를 택하는 것과 같습니다.
flowchart TD
  P[문제] --> A
  A --> A1["A1: impossible, A로 되돌아감"]
  A --> A2 --> A2a --> ANS[답]
그림 4.3.3 — DFS는 A1이 불가능으로 판정되면 A로 돌아가 A2 쪽을 따라갑니다.
| 항목 | BFS | DFS |
|---|---|---|
| 진행 방식 | 층마다 상위 b개만 남기고 한 층씩 |
유망한 경로를 먼저 깊이, 막히면 되돌아감 |
| 잘 맞는 문제 | 단계 수가 작고 고정된 문제(3단계 수학 퍼즐) | 경로가 길고 단계가 많은 문제 |
| 논문의 사례 | Game of 24 | 5x5 크로스워드(낱말 하나씩 채우고, 격자를 깨는 낱말이면 되돌아감) |
표 4.3.3 — 탐색 방식은 문제의 단계 수와 길이에 맞춰 고릅니다.
CoT는 되돌아갈 수 없고 ToT는 되돌아갈 수 있습니다. 고객 문제의 단계 수가 고정이면 BFS, 길고 가변이면 DFS로 시작하는 것이 판단의 출발점입니다.
4.3.4 Game of 24 예제
Game of 24는 숫자 네 개를 각각 정확히 한 번씩 써서 +, -, *, /로 24를 만드는 퍼즐입니다. 숫자는 4, 9, 10, 13입니다.
- 1) 분해: 생각은 숫자 두 개를 합치는 식 하나입니다. 숫자 4개가 1개가 되려면 생각이 정확히 3개 필요합니다.
- 2) 레벨 1 생성: LLM이 첫 수를 제안합니다.
| 후보 | 식 | 남은 숫자 | 평가 |
|---|---|---|---|
| (a) | 4 + 9 = 13 |
10, 13, 13 | impossible |
| (b) | 10 - 4 = 6 |
6, 9, 13 | sure |
| (c) | 13 - 9 = 4 |
4, 4, 10 | sure |
| (d) | 9 * 4 = 36 |
10, 13, 36 | impossible |
표 4.3.4 — 레벨 1의 후보 네 개 중 (b)와 (c)만 유망합니다.
- 3) 평가와 탐색: BFS로 (c)와 (b)를 남기고 (a)와 (d)를 버립니다. 이 설명에서는 후보가 4개뿐이어서
b를 2로 두어 가지치기를 보여 주는 것이며, 논문의 설정은b = 5입니다. - 4) 레벨 2: (c)의 "4, 4, 10"에서
10 - 4 = 6을 제안하면 남는 숫자는 4, 6이고4 * 6 = 24이므로 sure입니다.4 + 4 = 8이면 남는 숫자가 8, 10이라 impossible입니다. (b)도 같은 방식으로 확장되지만 설명을 위해 (c)의 경로만 따라갑니다. - 5) 레벨 3: "4, 6"에서
4 * 6 = 24로 목표에 도달합니다.
뿌리부터 경로를 읽으면 13 - 9 = 4, 10 - 4 = 6, 4 * 6 = 24이며 합치면 (10 - (13 - 9)) * 4 = 24입니다. 위 표의 남은 숫자 평가를 python3 -I로 완전 탐색해 다시 확인했을 때 (a), (d)는 24를 만들 수 없고 (b), (c)는 만들 수 있었습니다.
논문 결과로 GPT-4에 CoT를 쓰면 이 퍼즐의 4%만 풀었고, b = 5의 ToT를 쓰면 74%를 풀었습니다(2026년 10월 글이 인용한 2023년 논문 수치). CoT에서는 첫 식이 (a)였으면 답 전체가 실패하지만, ToT에서는 (a)가 impossible로 판정되어 일찍 버려집니다.
이 구조를 코드로 줄이면 다음과 같습니다. llm_propose와 llm_judge는 프롬프트를 보내고 답을 읽는 도우미 함수입니다.
def tree_of_thoughts(problem, steps=3, keep=5):
    states = [problem]
    for level in range(steps):
        candidates = [s + "\n" + t for s in states for t in llm_propose(s)]  # 생성
        scored = sorted(((llm_judge(c), c) for c in candidates), reverse=True)  # 평가
        states = [c for _, c in scored[:keep]]                                # 상위 keep개만 유지
return states[0]states는 지금 유지 중인 경로 목록이며 처음에는 문제만 있습니다.- 층마다 각 상태에 새 생각을 붙이는 것이 생각 생성기, 점수를 매기는 것이 상태 평가기, 상위
keep개만 남기는 것이 너비 제한b의 BFS입니다. - 마지막 층 뒤에 가장 좋은 경로를 돌려줍니다.
요구한 호출 수는 층 수 × 상태 수 × 후보 수에 비례하므로, 고객이 ToT를 요청하면 steps, keep, 후보 수로 호출 횟수를 먼저 추정해 비용을 알려 줍니다.
4.3.5 CoT vs ToT, 잘되는 곳과 실패하는 곳
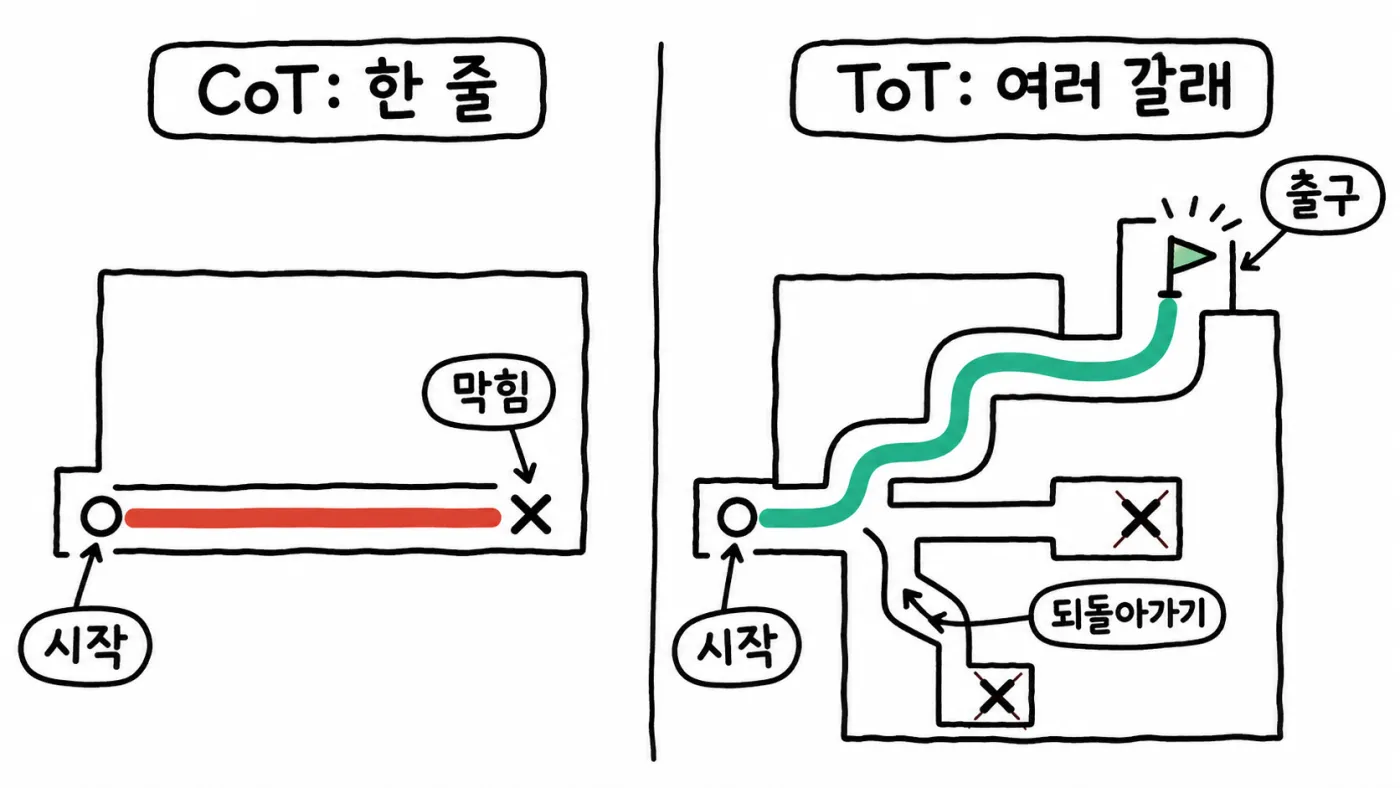
| 항목 | CoT | ToT |
|---|---|---|
| 추론의 모양 | 곧은 사슬 하나 | 여러 가지로 뻗은 나무 |
| 단계마다 선택지 | 하나 | 여러 개 |
| 자기 단계 평가 | 하지 않음 | 함 |
| 실수 후 되돌아감 | 불가 | 백트래킹으로 가능 |
| LLM 호출 수 | 한 번 | 많음, 수십 번 이상인 경우가 흔함 |
| 비용과 시간 | 낮음 | 높음 |
| 적합한 문제 | 단순한 단계별 문제 | 시도하고 검증해야 하는 어려운 문제 |
표 4.3.5 — ToT는 정확도를 얻는 대신 호출 수와 비용을 지불합니다.
잘되는 곳
- 퍼즐, 계획, 크로스워드처럼 첫 수가 결과를 크게 좌우하는 문제를 풉니다.
- 나쁜 걸음을 버리거나 되돌아가 복구할 수 있습니다.
- 추가 학습이 필요 없으며 기존 LLM이면 어떤 것에든 작동합니다.
- 너비 제한, 생각의 크기, 탐색 알고리즘을 조정할 수 있습니다.
실패하는 곳
- 비쌉니다. 질문 하나에 LLM 호출이 많이 들어 돈과 시간이 더 듭니다.
- 판단이 틀릴 수 있습니다. 좋은 경로를 impossible로 판정하면 그 경로는 영영 버려집니다.
- 문제 유형마다 생각의 크기, 프롬프트, 탐색을 새로 설계해야 합니다.
- 쉬운 질문에는 낭비입니다. CoT로 충분합니다.
최신 추론 모델은 긴 추론 안에서 스스로 탐색하고 검사하고 되돌아가도록 학습되어 있습니다(3.2 참조). 그래도 시도하는 경로 수와 판단 방식을 명확히 통제해야 하는 직접 만든 에이전트에서는 ToT의 발상이 여전히 유용합니다(6.1 참조).
고객 현장에서는 "첫 수를 잘못 고르면 전체가 무너지는 문제인가, 호출 수십 배의 비용을 감당할 가치가 있는가"를 먼저 묻고, 아니라면 CoT 또는 추론 모델로 충분하다고 판단합니다.
4.4 컨텍스트 엔지니어링(Context Engineering)
원문: What is Context Engineering?
LLM의 출력은 컨텍스트에 들어 있는 것으로 결정되므로, 신뢰할 만한 AI 애플리케이션의 병목은 모델 선택이 아니라 컨텍스트 설계로 옮겨 왔습니다. 이 절은 무엇을 넣고 어떻게 배치하고 언제 넣을지를 정하는 일을 다룹니다(2026년 5월 글 기준).
4.4.1 프롬프트 엔지니어링 vs 컨텍스트 엔지니어링
**컨텍스트 엔지니어링(Context Engineering)**은 LLM의 컨텍스트 윈도우에 들어가는 모든 것을 설계·구성·관리해 모델이 작업을 신뢰성 있게 수행하게 하는 일입니다. 어떤 정보를 줄지, 어떻게 조직할지, 언제 넣을지를 정하는 일이라고 바꿔 말할 수 있습니다(2.16 참조).
이 일이 중요한 이유는 LLM이 **무상태(stateless)**이기 때문입니다. 호출과 호출 사이에 아무것도 기억하지 못하고, 요청마다 처음부터 시작하며, 모델이 우리 작업에 대해 아는 것은 컨텍스트 윈도우에 넣은 것뿐입니다. 비유하면 똑똑하고 일이 빠르지만 지난 논의를 전혀 기억하지 못하는 신입 동료에게 매번 한 장짜리 브리핑을 주는 것과 같습니다. 브리핑에는 맡을 역할, 작업 내용, 읽어야 할 배경 문서, 비슷한 과거 작업 예시, 쓸 수 있는 도구, 원하는 답의 형식이 들어가야 하며, 빠뜨린 것은 동료가 짐작할 수 없습니다. LLM이 동료, 컨텍스트 윈도우가 브리핑, 컨텍스트 엔지니어링이 그 브리핑을 잘 쓰는 기술입니다.
여기서 세 가지가 따라 나옵니다.
- LLM의 출력은 입력 컨텍스트로 전적으로 결정됩니다.
- 훌륭한 컨텍스트를 받은 약한 모델이 부실한 컨텍스트를 받은 강한 모델을 이길 수 있습니다.
- 단순 채팅에서 RAG, 에이전트, 다단계 워크플로로 갈수록 애플리케이션의 복잡도는 모델이 아니라 컨텍스트에 있습니다.
두 용어는 자주 섞이므로 선을 긋겠습니다. **프롬프트 엔지니어링(Prompt Engineering)**은 단일 지시의 문구를 잘 쓰는 기술입니다. "이 기사를 요약해"와 "비전문가가 읽을 수 있게 불릿 세 개로 요약해"는 같은 작업이지만 문구가 결과를 바꿉니다. 컨텍스트 엔지니어링은 시스템 지시, 검색된 문서, 예시, 도구 출력, 메모리, 대화 이력, 출력 형식까지 모델이 보는 정보 환경 전체를 설계합니다.
| 항목 | 프롬프트 엔지니어링 | 컨텍스트 엔지니어링 |
|---|---|---|
| 범위 | 한 번에 지시 하나 | 컨텍스트 윈도우 전체 |
| 관심사 | 프롬프트 하나의 문구·표현·구조 | 시스템 프롬프트, RAG, 도구, 예시, 메모리, 이력 등 모델이 보는 모든 것 |
| 특히 중요한 때 | 단순한 원샷 작업 | RAG, 에이전트, 다단계 워크플로, 운영 시스템 |
| 실패 양상 | 나쁜 문구가 나쁜 답을 낳음 | 빠졌거나 틀린 컨텍스트가 오답, 환각(2.18 참조), 잘못된 도구 사용을 낳음 |
| 고치는 예 | 프롬프트 문장 다시 쓰기 | 검색 문서 추가, 메모리 조정, 시스템 프롬프트 순서 재배열 |
표 4.4.1 — 프롬프트 엔지니어링은 컨텍스트 엔지니어링의 부분집합입니다.
flowchart TB
  subgraph W["컨텍스트 윈도우 (컨텍스트 엔지니어링의 범위)"]
    direction TB
    SP[시스템 프롬프트] --- EX[예시] --- DOC[검색 문서] --- TL[도구 설명] --- MEM[메모리] --- HIS[대화 이력] --- TR[도구 결과]
    subgraph PR["프롬프트 (프롬프트 엔지니어링의 범위)"]
      Q["이 기사를 비전문가용 불릿 세 개로 요약해 주세요"]
    end
  end
그림 4.4.1 — 프롬프트는 컨텍스트라는 큰 상자 안의 작은 상자입니다.
고객이 "프롬프트를 더 잘 써 달라"고 요청하면 문구 문제인지, 모델에게 필요한 정보가 컨텍스트에 아예 없는 문제인지부터 가르는 것이 첫 진단입니다.
4.4.2 컨텍스트의 구성 요소
실제 LLM 애플리케이션의 컨텍스트는 프롬프트 하나가 아니라 역할이 다른 조각을 쌓은 구조입니다. 여덟 조각이 있습니다.
| 번호 | 구성 요소 | 내용 | 브리핑 비유 |
|---|---|---|---|
| 1 | 시스템 프롬프트(system prompt) | 역할, 규칙, 페르소나, 출력 형식. "너는 X이고, Y를 하고 Z는 하지 말며, 이 형식으로 답하라" | 동료에게 건네는 직무 |
| 2 | 예시(few-shot) | 원하는 패턴을 보여 주는 입력-출력 샘플. 좋은 예시 하나만으로도 출력이 크게 좋아지며 인컨텍스트 학습(in-context learning)이라고도 부름 | 가리켜 주는 과거 작업 |
| 3 | 검색된 문서(RAG) | 답이 외부 지식(지식 베이스, 문서 사이트, DB)에 달려 있을 때 가져온 관련 조각(5.14 참조) | 배경 자료 바인더 |
| 4 | 도구와 도구 설명 | 에이전트가 쓸 수 있는 도구의 함수명, 설명, 파라미터 스키마. 모델이 할 수 있는 일을 알려 줌(6.2 참조) | 쓸 수 있는 장비 |
| 5 | 메모리(memory) | 사용자에 대한 장기 사실, 과거 대화, 학습된 선호(6.7 참조) | 지난 회의에서 알게 된 것 |
| 6 | 대화 이력(conversation history) | 현재 세션의 이전 턴. 채팅의 연속성을 줌 | 지금 진행 중인 회의 |
| 7 | 도구 결과(tool results) | 모델이 도구를 추천하고 런타임이 실행한 결과가 다음 턴 컨텍스트로 돌아옴 | 장비를 돌려 받은 답 |
| 8 | 현재 사용자 메시지 | 방금 들어온 질문이나 지시 | 사용자가 방금 한 말 |
표 4.4.2 — 컨텍스트는 여덟 조각이 한 윈도우를 두고 경쟁하는 구조입니다.
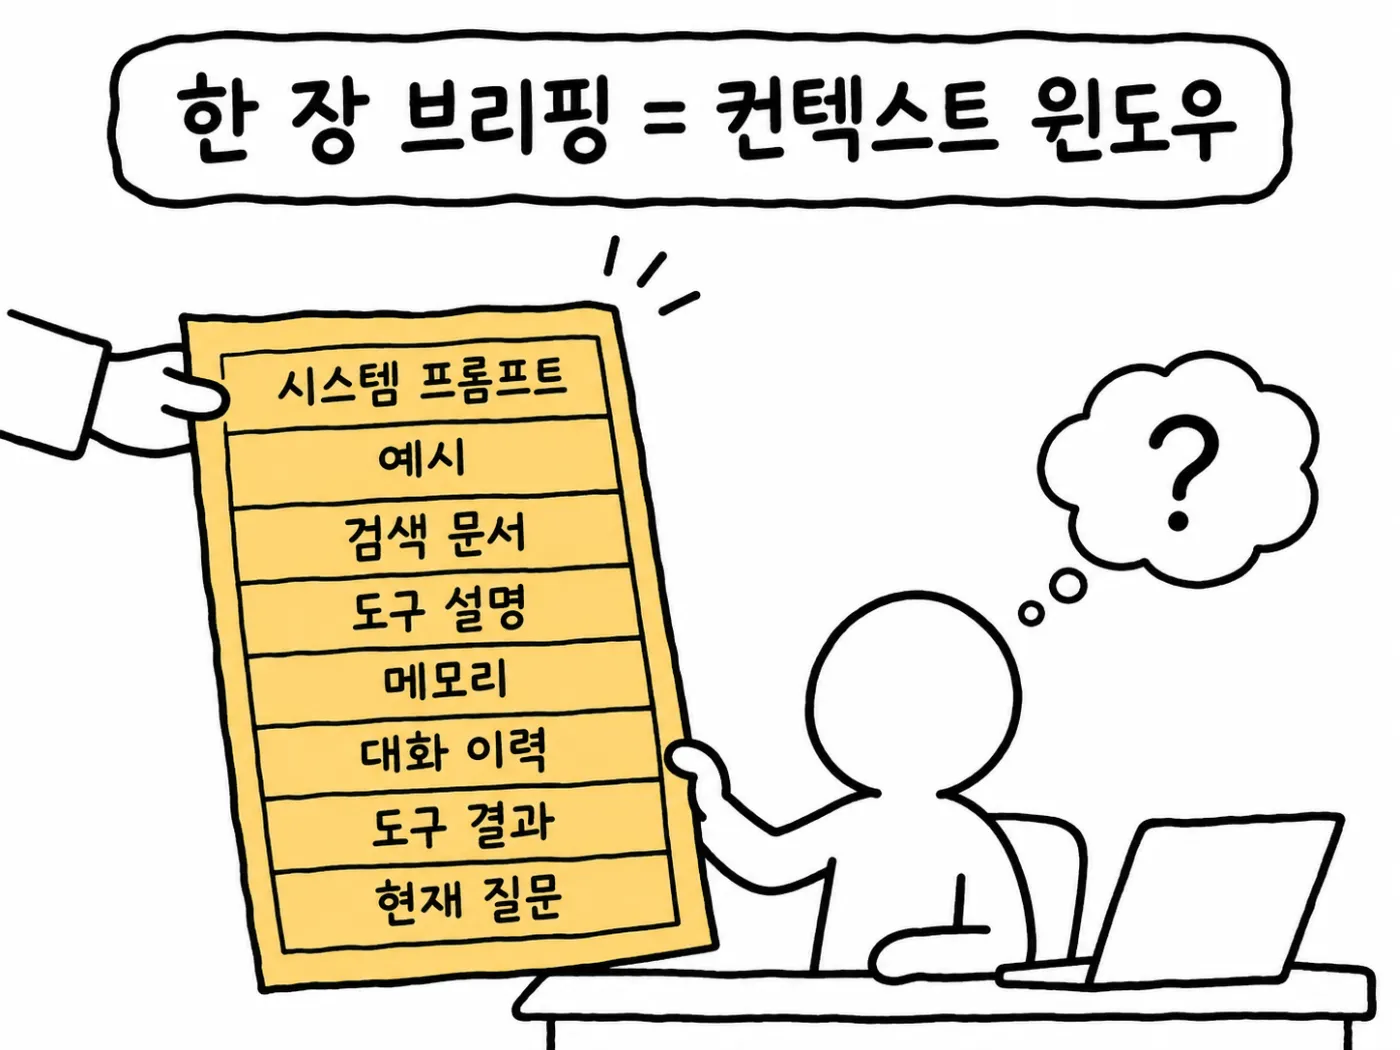
- 여덟 조각은 모두 같은 유한한 윈도우를 나눠 씁니다. 무엇을 넣을지, 어떤 순서로, 얼마나 큰 크기로 넣을지 정하는 일이 컨텍스트 엔지니어링입니다.
- 브리핑은 한 장에 들어가야 하며, 그 한 장이 컨텍스트 윈도우입니다.
고객 시스템을 처음 받으면 이 여덟 칸 각각이 현재 무엇으로 채워지는지, 어느 칸이 윈도우의 대부분을 차지하는지 표로 그려 보는 것이 실사(due diligence)의 출발점입니다.
4.4.3 흔한 패턴
컨텍스트는 어딘가에 저장되어 있는 것이 아니라 매 턴마다 처음부터 다시 조립됩니다. 시스템 프롬프트, 메모리 저장소, RAG 검색 결과, 예시, 도구 목록, 도구 결과, 대화 이력, 최신 사용자 메시지라는 소스에서 조각을 끌어와 이번 호출 하나를 위한 새 컨텍스트로 합칩니다. 따라서 컨텍스트 엔지니어링은 한 번의 초기 설정이 아니라 턴마다의 결정입니다.
flowchart TD
  S1[시스템 프롬프트] --> ASM
  S2[메모리 저장소] --> ASM
  S3[RAG 검색] --> ASM
  S4[예시] --> ASM
  S5[도구 목록] --> ASM
  S6[도구 결과] --> ASM
  S7[대화 이력] --> ASM
  S8[최신 사용자 메시지] --> ASM
  ASM[조립된 컨텍스트] --> LLM[LLM 출력] --> NEXT["다음 턴에 처음부터 다시 조립"]
그림 4.4.3 — 매 턴 소스에서 조각을 모아 컨텍스트를 새로 만듭니다.
여덟 가지 패턴은 이 소스 칸을 잘 채우는 도구입니다.
- RAG(Retrieval-Augmented Generation). 지식 베이스 전체를 넣지 않고 가장 관련된 조각만 검색해 주입해 컨텍스트를 작고 집중되게 유지합니다. 맞는 조각이 들어오게 하려면 청킹(5.6 참조), 임베딩 기반 검색(5.1 참조), 리랭킹(5.5 참조)을 함께 씁니다.
- few-shot 예시. 입력과 원하는 출력의 쌍을 몇 개 넣습니다(2~5개가 시작 범위이며 최적은 작업마다 다름). 모델이 패턴을 배워 따라가며 품질을 올리는 가장 값싼 방법의 하나입니다.
- 도구 호출(tool calling). 모델이 직접 다 하지 않고 도구를 쓰도록 하고, 필요할 때 어느 도구를 쓸지 추천하게 합니다. 런타임이 추천된 도구를 실행하며, 도구 정의와 결과가 모두 컨텍스트에 들어갑니다. 에이전트의 토대이며(6.1 참조), 에이전트가 도는 루프·도구·컨텍스트 전체 설계인 하네스 엔지니어링(7.1 참조), 반복 주기 자체의 설계인 루프 엔지니어링(7.2 참조)과 겹칩니다.
- 메모리 주입. 중요한 사실을 따로 저장하고 새 턴마다 관련된 조각만 주입합니다. 메모리 전체를 매번 넣지 않습니다.
- 대화 이력 관리. 긴 채팅은 이력이 윈도우를 넘으므로 요약, 슬라이딩 윈도우, 선택적 포함으로 예산 안에 둡니다(4.5 참조).
- 출력 형식 지정. JSON, 특정 스키마, 마크다운 표, 구조화된 양식처럼 정확한 출력 형식을 알려 줍니다. 형식 요구를 컨텍스트에 두면 다운스트림 파싱이 안정됩니다. 파싱의 신뢰성이 필수여야 하면 대부분의 최신 모델 제공자가 지원하는 구조화 출력 API와 JSON 스키마 제약이 프롬프트만으로 형식을 지정하는 것보다 강합니다. 프롬프트는 형식을 요청하고 스키마가 강제합니다.
- 컨텍스트 압축. 원본이 너무 길면 요약, 핵심 사실 추출, 구조적 재작성으로 의미는 유지하고 토큰 수를 줄입니다(4.5 참조).
- 스텝마다 컨텍스트 재구성(에이전트). 에이전트 루프의 매 스텝은 새로 조립한 컨텍스트로 하는 새 LLM 호출입니다(6.3 참조). 스텝 사이에 상태가 바뀌므로(새 도구 결과, 끝난 하위 작업, 수정된 계획) 지금 필요한 것, 즉 현재 하위 작업, 최신 도구 결과, 메모리의 관련 사실만으로 다음 컨텍스트를 만들고 모든 것을 끝없이 덧붙이지 않습니다. 이를 잘하는 에이전트는 초점을 유지하고, 못하는 에이전트는 오래된 쓸모없는 정보에 묻혀 작업에 실패합니다.
고객이 에이전트를 장시간 돌린다면 스텝마다 컨텍스트에 무엇이 남고 무엇이 빠지는지를 로그로 확인할 수 있어야 합니다.
4.4.4 흔한 실수
LLM 애플리케이션 실패의 상당수는 컨텍스트 엔지니어링 실패입니다. 여섯 가지가 대표적입니다.
| 실수 | 증상 | 해법 |
|---|---|---|
| 1. 전부 쑤셔 넣기 | 모델이 산만해지고 느려지며 비용이 늘고 답이 나빠짐. 필요 이상으로 커진 컨텍스트에서 답 품질이 서서히 떨어지는 현상을 컨텍스트 부패(context rot) 또는 컨텍스트 저하(context degradation)라 부름 | 이번 턴에 필요한 것만 넣음 |
| 2. 너무 적게 넣기 | 모델은 보지 못한 것을 짐작할 수 없음. 환불 정책을 알기를 기대하면 그 정책이 컨텍스트에 있어야 함 | "내가 이 일을 한다면 무엇을 알아야 하는가, 그게 다 컨텍스트에 있는가"를 자문 |
| 3. 나쁜 순서 | 모델은 처음(시스템 프롬프트 영역)과 끝(최근 메시지)에 더 주의를 기울이고 긴 컨텍스트 한가운데는 덜 봄. "중간 소실(lost in the middle)"이라는 잘 연구된 현상(2.17 참조) | 규칙과 지시는 처음에, 현재 작업은 끝에 둠 |
| 4. 낡은 컨텍스트 | 더는 관련 없는 오래된 이력, 도구 결과, 검색 문서가 컨텍스트를 어지럽히고 모델을 혼란스럽게 함 | 적극적으로 가지치기. 현재 스텝과 무관하면 제거 |
| 5. 구조 없음 | 헤더·구분자·라벨 없이 글 덩어리를 붙이면 파싱이 어려움. LLM은 비정형 텍스트도 읽지만 구조가 집중을 도움 | 명확한 섹션 표지, 헤더, 일관된 서식 |
| 6. 모순된 지시 | 시스템 프롬프트와 사용자 메시지가 다른 말을 하거나 검색된 두 문서가 상충하면 모델이 짐작으로 고름 | "지금 모델이 무엇을 해야 하는가"의 답이 하나로 나오게 설계 |
표 4.4.4 — 여섯 실수는 모두 컨텍스트에 무엇을 얼마나 어떻게 넣었는지의 문제입니다.
실수 2에는 더 어려운 면이 있습니다. 필요한 지식이 대개 사람 머릿속, 위키, 코드 주석에 있어서 컨텍스트에 넣을 문서가 애초에 없는 경우입니다. 이 지식을 에이전트가 읽을 수 있는 평문 마크다운으로 기록하는 개방형 표준이 OKF입니다(6.11 참조).
고객 장애 보고를 받으면 모델 교체를 논하기 전에 "실패한 순간의 컨텍스트에 무엇이 있었는가"를 먼저 요청하고, 위 여섯 가지를 체크리스트로 훑습니다.
4.4.5 모범 사례
경험 많은 팀이 따르는 여덟 가지 모범 사례입니다.
- 컨텍스트를 예산으로 다룹니다. 토큰 하나하나가 돈과 주의를 씁니다. 시스템 프롬프트, 검색, 이력, 현재 작업에 각각 얼마를 줄지 미리 정하고 지킵니다.
- 현재 작업에 집중합니다. 호출마다 "모델이 이 작업 하나를 하는 데 실제로 필요한 것이 무엇인가"를 묻고 그만큼만 넣습니다. 에이전트 스킬은 이 규칙을 지시문에 적용한 사례로, 각 절차의 한 줄 설명만 상시 로드하고 요청이 일치할 때만 전체 단계를 읽습니다(6.10 참조).
- 가장 안정적인 것에서 가장 최신인 것 순으로 배치합니다. 맨 위에 시스템 프롬프트(안정적이고 거의 안 바뀜), 그다음 예시, 검색 지식, 메모리, 대화 이력, 맨 끝에 현재 메시지를 둡니다. 안정적인 앞부분은 캐싱해 재사용할 수 있어 캐싱과도 맞물립니다(4.6 참조).
- 명확한 섹션 표지를 씁니다. 헤더·구분선·라벨로 각 조각의 시작과 끝을 알려 줍니다. 예:
### SYSTEM,### EXAMPLES,### RETRIEVED DOCUMENTS,### CONVERSATION,### CURRENT TASK. - 모델만이 아니라 컨텍스트를 테스트합니다. 문제가 생기면 첫 질문은 "실패했을 때 컨텍스트에 무엇이 있었나"여야 합니다. 실패한 호출의 전체 컨텍스트를 로그로 남깁니다. 버그는 대개 모델이 아니라 거기에 있습니다.
- 컨텍스트를 소프트웨어처럼 반복 개선합니다. 버전을 매기고 diff를 보고 A/B 테스트하며, 실제 작업에서의 성능을 재는 평가를 만듭니다. 즉흥 자유 텍스트가 아니라 일급 엔지니어링 산출물로 취급합니다.
- 압축은 하되 조심합니다. 요약과 압축은 토큰을 줄이지만 정보도 잃습니다. 나중에 자세히 필요하지 않을 것이 확실한 부분만 압축합니다.
- 최악의 경우를 위해 만듭니다. 운영에서는 긴 대화, 큰 검색 문서, 반복되는 도구 호출 때문에 컨텍스트가 예상 밖으로 커집니다. 평균이 아니라 최악의 경우에도 우아하게 동작하도록 설계합니다(6.2 참조).
모델은 엔진이고 컨텍스트는 연료이며, 평범한 컨텍스트와 훌륭한 모델의 조합보다 훌륭한 컨텍스트와 평범한 모델의 조합이 이기는 경우가 많습니다. 그러므로 AI 애플리케이션이 말을 듣지 않을 때 첫 질문은 "모델이 틀렸는가"가 아니라 "컨텍스트가 맞는가"입니다. 고객에게는 예산 배분표, 섹션 표지가 있는 템플릿, 실패 컨텍스트 로깅의 세 가지를 도입 첫 주의 필수 산출물로 요청합니다.
4.5 컨텍스트 압축(Context Compaction)
원문: How does context compaction work?
긴 대화는 고정 크기의 컨텍스트 윈도우를 반드시 넘치게 하고, 오래된 메시지를 지우면 그 안의 사실도 함께 사라집니다. 이 절은 오래된 부분을 짧은 요약으로 바꿔 사실은 남기고 공간만 되찾는 방법을 다룹니다(2026년 7월 글 기준).
4.5.1 긴 대화의 문제와 단순 잘라내기가 실패하는 이유
모델이 한 번에 붙들 수 있는 토큰 수에는 상한이 있고, 이것이 컨텍스트 윈도우입니다(2.16 참조). 윈도우는 작은 화이트보드와 같아서 가득 차면 무언가를 지우기 전에는 한 글자도 더 쓸 수 없습니다. **컨텍스트(context)**는 한 번에 모델에 보내는 모든 텍스트이며, 채팅에서는 시스템 지시, 지금까지의 모든 메시지, 방금 한 질문을 합친 것입니다. 모델은 답하기 전마다 이 기록 전체를 다시 읽습니다. 윈도우가 상자이고 컨텍스트가 그 안에 담는 내용물입니다.
챗봇이나 AI 코딩 어시스턴트를 몇 시간씩 쓰면 보낸 메시지와 받은 답이 모두 컨텍스트에 쌓입니다. 상자 크기는 고정인데 대화는 멈추지 않으므로 언젠가 가득 찹니다. 예를 들어 8개 메시지가 들어가는 상자는 초반에 여유가 있다가, msg8에서 가득 차고, msg9가 오면 들어갈 자리가 없습니다.
넘칠 때 세 가지 문제가 생깁니다.
- 새 메시지가 들어가지 못해 오류가 나거나 오래된 텍스트가 잘립니다.
- 컨텍스트가 클수록 매 턴 더 많은 토큰을 읽으므로 모델이 느려지고 비용이 늘어납니다.
- 낡은 텍스트가 많으면 모델이 혼란스러워져 무엇이 중요한지 놓칩니다.
가득 차기 전에도 문제가 있습니다. 모델은 긴 컨텍스트의 처음과 끝은 잘 읽고 가운데는 놓칩니다(2.17 참조).
가장 먼저 떠오르는 해법은 슬라이딩 윈도우(sliding window), 즉 상자가 차면 가장 오래된 메시지부터 버리고 최근 것만 남기는 방식입니다. 달리는 기차 창밖에서 오래된 풍경이 뒤로 흘러가는 모양입니다. 상자가 4개 메시지를 담는다면 msg5가 올 때 msg1을, msg6이 올 때 msg2를 버려 항상 최근 4개만 유지합니다.
- 실패 사례: msg1이 "제 이름은 Amit이고 Kotlin으로 안드로이드 앱을 만들고 있어요"였다면, 몇 시간 뒤 "내가 쓰는 언어가 뭐였죠?"라는 질문에 모델은 답을 알 수 없고 틀리게 짐작하거나 모른다고 합니다. 사실이 영영 사라진 것입니다.
- 원인: 오래된 메시지를 버리면 그 안에 숨어 있던 중요한 사실도 함께 버려집니다. 단어만이 아니라 기억을 잃습니다.
- 모델 내부 관점에서도 가장 앞의 토큰을 윈도우에서 빼는 것은 위험합니다. 처음 토큰들은 떨어져 나가면 안 되는 위치로 알려져 있습니다(어텐션 싱크, attention sink).
단순 잘라내기는 윈도우 문제를 풀지만 기억 문제를 새로 만든다고 설명하면 고객도 바로 이해합니다. "오래된 대화를 그냥 버리는 방식인가, 요약해 남기는 방식인가"가 장기 대화 제품을 평가할 때 던질 첫 질문입니다.
4.5.2 요약 기반 압축
**컨텍스트 압축(context compaction)**은 오래된 대화를 짧은 요약으로 줄여 중요한 사실은 남기고 상자에 빈 공간을 되찾는 기법입니다. 삭제하지 않고 쥐어짠다는 점이 핵심입니다. 길게 쌓인 옛 텍스트를 핵심 사실만 담은 작은 메모로 바꾸므로, 상자는 비워지고 기억은 살아남습니다.
20쪽짜리 일기를 생각해 보겠습니다. 내일 20쪽이 전부 필요하지는 않으므로 중요한 사건만 담은 반 쪽 요약을 쓰고 20쪽을 버립니다. 사소한 디테일은 잃지만 이야기는 지킵니다. 이 반 쪽이 압축된 컨텍스트입니다. 가방 싸기에 비유하면 다음과 같습니다.
| 가방 싸기 | 컨텍스트 압축 |
|---|---|
| 가방 | 컨텍스트 윈도우(고정 크기) |
| 모든 옷 | 전체 대화 이력 |
| 넘치는 옷 | 가득 찬 컨텍스트 |
| 옷을 접고 진공 포장 | 오래된 메시지 요약 |
| 깔끔히 싼 가방 | 압축되어 작아진 컨텍스트 |
| 쓰레기는 버리고 옷은 남김 | 군더더기는 버리고 핵심 사실은 유지 |
표 4.5.2 — 가방이 차도 옷을 버리지 않고 접어 공간을 만들듯, 압축은 말을 버리지 않고 줄입니다.
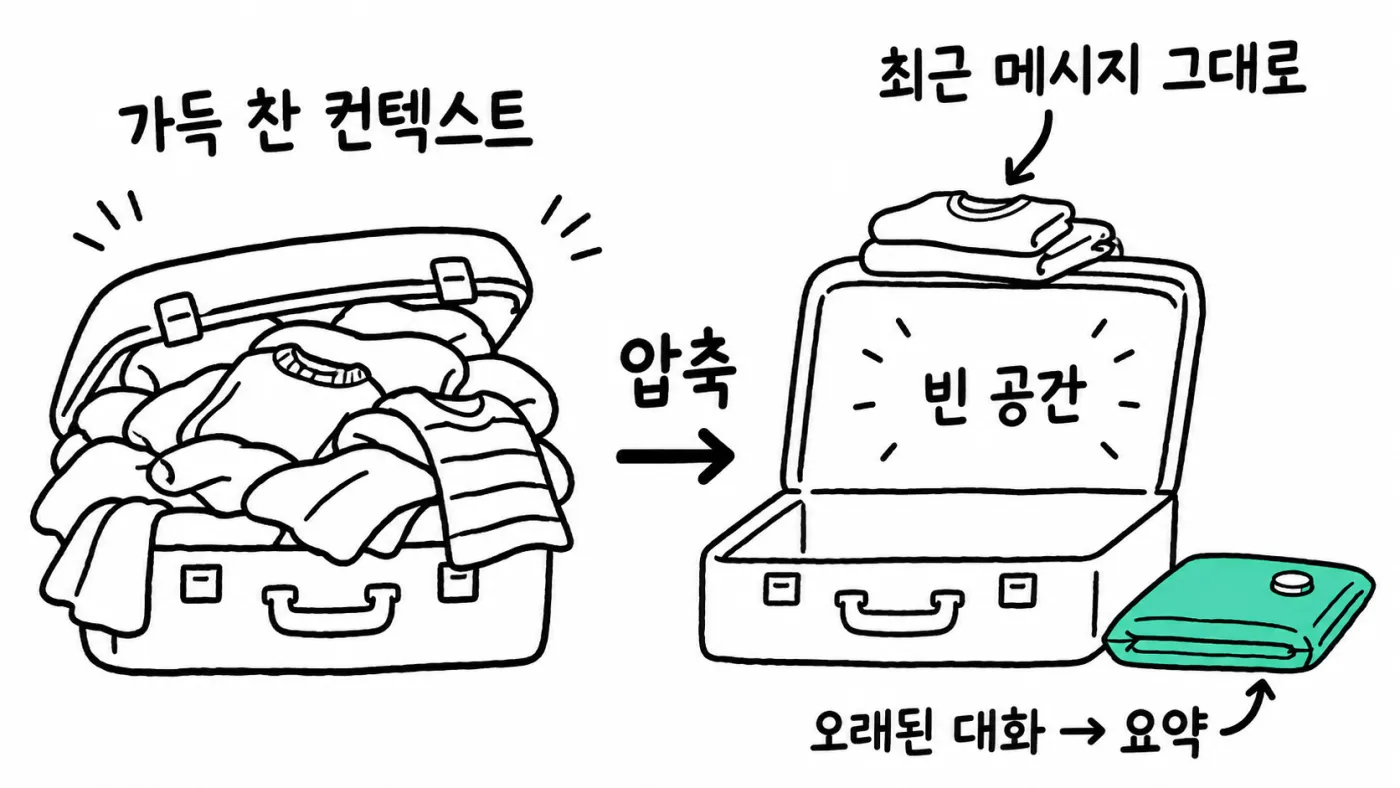
오래된 텍스트를 줄이는 엔진은 요약(summarization), 곧 모델 스스로 옛 메시지를 읽고 핵심만 담은 짧은 메모를 쓰게 하는 것입니다. 질문에 답하는 같은 LLM이 요약도 잘하므로 두 일에 모두 씁니다.
- 옛 메시지가 3000 토큰이라면 모델에 넘겨 요약을 받고, 사용자의 이름·프로젝트·언어·지금까지의 결정을 담은 200 토큰 메모가 돌아옵니다.
- 원본 3000 토큰을 버리고 메모 200 토큰만 남기면 2800 토큰의 공간이 생기고 중요한 사실은 잃지 않습니다.
- 다음에 상자가 찰 때는 새로 오래된 메시지와 이전 요약을 함께 더 짧은 새 요약으로 만들 수 있어, 압축은 가득 찰 때마다 반복됩니다.
flowchart LR
  OLD["옛 메시지 (3000 토큰)"] --> M["모델 (요약기)"] --> SUM["짧은 요약 (200 토큰)"]
그림 4.5.2b — 요약이 엔진이고 압축은 그 결과입니다.
요약은 정보를 잃을 수 있는 변환이므로, 고객에게는 무엇이 보존 대상이고 무엇이 버려도 되는 군더더기인지를 업무 기준으로 먼저 정하도록 요청합니다.
4.5.3 단계별 워크스루와 코드
숫자를 따라가 보겠습니다. 컨텍스트 윈도우가 1000 토큰이고, 컨텍스트가 800 토큰(윈도우의 80%)을 넘으면 압축하는 규칙이 있습니다.
| 단계 | 일어나는 일 | 토큰 |
|---|---|---|
| 1 | 오래된 메시지 700 + 최근 메시지 150 = 850이 되어 800선을 넘음. 압축 시점 | 850 |
| 2 | 오래된 메시지 700 토큰을 모델에 요약시켜 120 토큰 요약을 받음(이름, 프로젝트 목표, 핵심 결정 포함) | 요약 120 |
| 3 | 오래된 700을 버리고 요약 120으로 대체. 최근 메시지 150은 신선하고 세부가 필요하므로 그대로 유지 | 120 + 150 = 270 |
| 4 | 대화 계속. 모델은 작은 요약과 최근 메시지를 읽으며 이름과 프로젝트를 여전히 앎. 다음에 찰 때 다시 압축 | 270부터 재성장 |
표 4.5.3 — 850 토큰이 270 토큰으로 줄어 580 토큰의 여유가 생기고, 최근 메시지는 원문 그대로 남습니다.
python3 -I로 재계산하면 700 + 150 = 850, 120 + 150 = 270, 850 - 270 = 580이 맞습니다. 앞의 3000 토큰 요약 예도 3000 - 200 = 2800입니다.
코드로 비교해 보겠습니다. 먼저 잊어버리는 단순 슬라이딩 윈도우입니다.
def naive_sliding_window(messages, max_messages):
    return messages[-max_messages:]   # 오래된 메시지가 통째로 사라짐
삭제 대신 압축하는 버전은 다음과 같습니다.
def compact_context(messages, recent_count, summarize):
    old = messages[:-recent_count]       # 오래된 부분
    recent = messages[-recent_count:]    # 최근 부분
    summary = summarize(old)             # 모델에게 요약시킴
return [summary] + recent # 요약 먼저, 최근 메시지 뒤old와 마지막recent_count개의recent로 이력을 나눕니다.summarize(old)가 모델에게 오래된 메시지를 짧은 메모로 줄이게 합니다.- 짧은
summary뒤에 세부가 살아 있는recent를 이어 붙여 컨텍스트를 다시 만듭니다. - 실무에서는 메시지마다 압축하지 않고 윈도우의 80% 같은 임계치를 넘을 때만 압축합니다. 그래야 요약 호출 비용이 낮게 유지됩니다.
임계치는 튜닝 변수입니다. 너무 낮으면 요약 호출이 잦아 비용이 늘고, 너무 높으면 요약 작업 자체가 윈도우를 넘길 위험이 커집니다. 고객 환경의 윈도우 크기와 평균 턴 길이를 받아 임계치를 같이 정합니다.
4.5.4 실제 에이전트의 컴팩션
AI 에이전트는 LLM으로 파일 읽기, 명령 실행, 코드 수정처럼 여러 단계를 연달아 수행하는 프로그램이며(6.1 참조), 각 단계가 컨텍스트에 텍스트를 더하므로 긴 작업에서는 컨텍스트가 엄청나게 커집니다. 언제 압축하고 그 반복 주기가 무엇을 통제해야 하는지를 설계하는 일이 루프 엔지니어링입니다(7.2 참조).
한 시간 동안 일한 코딩 어시스턴트를 예로 들겠습니다. 파일 수십 개를 읽고 명령을 여러 번 실행했으니 원본 이력은 방대하고 상자는 거의 찼습니다. 압축이 없다면 어시스턴트는 작업의 초기 목표를 잊습니다. 그래서 백그라운드에서 압축을 돌려 오래된 단계들을 "목표: 로그인 버그 수정. auth.py와 login.py를 이미 수정함. 테스트 통과 중" 같은 짧은 메모로 줄이고, 이 메모와 최신 단계를 가지고 계속 일합니다(7.6 참조).
좋은 컴팩션은 요약으로 지워서는 안 되는 것을 원문 그대로 보호합니다.
- 원래의 시스템 지시
- 사용자의 핵심 목표
- 가장 최근의 메시지
압축 대상은 어수선한 가운데 부분뿐입니다.
현대 에이전트는 컴팩션(컨텍스트 압축을 에이전트 현장에서 부르는 말)을 사후 땜질이 아니라 계획된 기능으로 다룹니다. 가장 중요한 부분은 보호하고 나머지를 쥐어짜서, 몇 시간 동안 이야기의 줄거리를 잃지 않고 일하게 합니다. 이 효과는 다음 네 가지입니다.
- 챗봇과 에이전트가 윈도우를 넘치게 하지 않고 몇 시간씩 돕니다.
- 군더더기만 버리고 중요한 사실은 살립니다.
- 모델이 턴마다 읽는 토큰이 줄어 비용과 속도를 통제합니다.
- 딱딱한 메모리 한계를 끊기지 않는 대화로 바꿉니다.
컴팩션이 정보를 잃을 수 있다는 점은 짚어 두어야 합니다. 잃는 것은 사소한 디테일이어야 하며, 고객에게는 압축 전후 이력을 로그로 남기고 보호 대상(시스템 지시, 핵심 목표, 최신 메시지)을 명시한 설계를 요구합니다. 컨텍스트 전체의 구성은 컨텍스트 엔지니어링의 범위입니다(4.4 참조).
4.6 프롬프트 캐싱(Prompt Caching)
원문: How does Prompt Caching work?
매 요청마다 똑같이 반복되는 긴 지시문과 문서를 모델이 처음부터 다시 읽는 것은 시간과 돈의 낭비입니다. 이 절은 반복되는 앞부분의 계산을 저장해 재사용하는 API 수준의 접두 재사용과, 그것이 깨지는 조건을 다룹니다(2026년 6월 글 기준).
4.6.1 정확한 접두(prefix) 일치 규칙
배경부터 짚겠습니다. LLM은 프롬프트를 단어가 아니라 **토큰(token)**이라는 작은 조각으로 쪼개 읽습니다(2.4 참조). 응답의 첫 글자를 쓰기 전에 프롬프트 전체를 토큰마다 처리하는 첫 단계가 Prefill입니다(10.2 참조). Prefill 동안 모델은 토큰마다 내부 값을 계산해 저장하며, 이 값의 모음이 KV 캐시입니다. 토큰마다 "앞의 모든 것에 비추어 이 토큰이 무슨 뜻인지"를 적은 메모 한 세트가 있고, 모델은 응답을 쓰는 동안 이 메모를 다시 씁니다(10.3 참조). 긴 프롬프트의 KV 캐시를 만드는 일은 토큰마다 무거운 계산을 해야 하므로, 프롬프트가 5,000 토큰이면 한 글자를 쓰기 전에 5,000 토큰 분량의 일을 하고, 길수록 Prefill의 시간과 비용이 늘어납니다.
**프롬프트 캐싱(Prompt Caching)**은 프롬프트에서 반복되는 부분에 대해 모델이 이미 한 계산(KV 캐시)을 저장했다가, 다음에 같은 시작 부분이 오면 저장분을 불러와 재계산을 건너뛰는 기법입니다. "무거운 일은 한 번만 하고 재사용한다"가 요점입니다. 캐시(cache)는 나중에 빨리 꺼내 쓰려고 저장해 둔 곳을 뜻합니다. 모델이 응답 전체를 재사용하는 것이 아니라 내부 계산을 재사용한다는 점에서, 의미가 같은 새 질문에 마지막 답을 돌려주는 시맨틱 캐싱과 다릅니다. 프롬프트 캐싱에서는 모델이 새 부분을 읽고 새 응답을 씁니다.
가장 중요한 규칙은 **정확한 접두 일치(exact-prefix)**입니다. **접두(prefix)**는 어떤 것의 시작 부분이며, 프롬프트에서는 사용자 질문 앞에 오는 부분입니다. 캐시는 새 프롬프트의 시작 부분이 캐시된 프롬프트의 시작 부분과 글자 하나까지 같은 동안만 재사용되고, 달라지는 지점부터는 소용이 없습니다.
캐시된 프롬프트:  You are a polite support agent. Return window is 30 days.
새 프롬프트:      You are a polite support agent. Return window is 45 days.
                  |------------- 정확히 일치: 캐시에서 읽음 -------------|
                                                        ^ 여기부터 다름: 이후는 다시 계산
그림 4.6.1 — 처음으로 달라지는 토큰부터 그 뒤 전체를 다시 계산합니다.
- 초반의 한 글자가 바뀌면 그 뒤 전체의 캐시가 깨집니다.
- 실패 사례: 지시문 맨 위에 "오늘 날짜는 2026-06-07입니다" 한 줄을 넣으면 접두가 매일 달라지고, 어제 만든 캐시를 오늘 쓸 수 없어 모델이 모든 일을 다시 합니다.
- 흔한 실수는 날짜, 무작위 ID, 사용자 이름처럼 변하는 값을 프롬프트 상단 근처에 무심코 두는 것입니다. 이 작은 변동 하나가 캐시 전체를 조용히 깹니다.
- 해법: 안정적인 부분을 앞에, 변하는 부분을 뒤에 둡니다(4.4 참조).
캐시 적중률이 낮다는 문의를 받으면 모델이나 설정보다 프롬프트 맨 위쪽에 매 요청마다 달라지는 문자열이 있는지부터 확인합니다.
4.6.2 캐시 쓰기·읽기와 TTL
**캐시 쓰기(cache write)**는 처음에 반복되는 부분을 처리해 그 KV 캐시를 저장하는 일이고, **캐시 읽기(cache read)**는 이후 요청이 저장된 KV 캐시를 재계산 없이 재사용하는 일입니다. 쓰기는 계산도 하고 결과도 저장하므로 정상 처리보다 조금 비싸서 대략 그 부분 정가의 1.25배이고, 읽기는 정가의 약 10분의 1로 반복되는 부분에서 약 90% 절감입니다(2026년 6월 글 기준). Anthropic 공식 문서는 5분 TTL 쓰기를 1.25배, 1시간 TTL 쓰기를 2배, 읽기를 대부분의 모델에서 0.1배로 안내하며, 일부 최신 모델의 읽기 요율은 이보다 낮습니다. 제공자와 모델마다 요율이 다르므로 계약 전에 현재 가격표로 다시 계산합니다.
flowchart TD
  R1["요청 1: 안정적 부분 처리 후 저장 (캐시 쓰기, 약 1.25배)"] --> C[(캐시)]
  C --> R2["요청 2: 캐시 읽기, 약 0.1배"]
  C --> R3["요청 3: 캐시 읽기, 약 0.1배"]
  C --> R4["요청 4: 캐시 읽기, 약 0.1배"]
그림 4.6.2 — 첫 요청만 무거운 일을 하고 이후 요청은 읽기만 합니다.
위 요율로 앞의 예(고정 5,000 토큰 + 질문 50 토큰)를 python3 -I로 계산했습니다. 정가를 토큰당 1로 두고 입력 쪽만 비교한 것이며 출력 비용은 제외했습니다.
| 요청 수 | 캐시 없음 | 캐시 사용 | 캐시 사용 비용 / 캐시 없음 |
|---|---|---|---|
| 1회 | 5,050 | 6,300 | 약 1.25배 (손해) |
| 2회 | 10,100 | 6,850 | 약 0.68배 |
| 10회 | 50,500 | 11,250 | 약 0.22배 |
| 100회 | 505,000 | 60,750 | 약 0.12배 |
표 4.6.2 — 계산식은 첫 요청
5000 × 1.25 + 50, 이후 요청5000 × 0.1 + 50입니다. 두 번째 요청부터 이득입니다.
- 첫 요청은 쓰기 비용을 추가로 내고, 이후 요청부터 훨씬 싸므로 재사용 횟수가 많을수록 절감이 커집니다.
- 캐시는 영원하지 않으며 TTL(Time To Live, 생존 시간) 동안만 살아 있다가 만료되어 삭제됩니다. Anthropic의 기본 TTL은 5분이고 1시간 옵션이 있으며, OpenAI는 모델에 따라 기본 보존 시간이 다르고 더 긴 옵션을 제공합니다.
- TTL 안에 같은 접두의 요청이 오면 캐시를 읽고, TTL 안에 요청이 없으면 만료되어 다음 요청이 캐시 쓰기를 다시 해야 합니다.
- 긴 TTL은 요청이 드문드문 올 때 유리하지만 그 캐시 쓰기는 더 비쌉니다(Anthropic 1시간 TTL은 정가의 2배). 용도에 맞춰 고릅니다.
- 결과적으로 프롬프트 캐싱은 같은 시작 부분을 공유하는 요청이 시간상 가깝게 몰려 올 때 가장 도움이 됩니다.
트래픽이 하루에 몇 번뿐인 야간 배치 업무는 TTL이 만료되어 매번 쓰기 비용만 내므로 캐싱이 오히려 손해일 수 있습니다. 고객의 요청 간격 분포를 먼저 확인합니다.
4.6.3 캐시에 넣을 내용
캐시에 넣을 것은 여러 요청에 걸쳐 같은 부분이고, 앞에 둡니다. 변하는 부분은 맨 뒤에 둡니다.
| 위치 | 항목 | 내용 | 비고 |
|---|---|---|---|
| 앞(캐시할 안정적 부분) | 도구 정의 | 모델에게 알려 주는 각 도구의 설명 | 보통 고정 |
| 앞 | 시스템 지시 | "당신은 신발 가게의 정중한 상담원입니다" 같은 행동 지침 | 모든 사용자에게 같음 |
| 앞 | 큰 문서 | 반품 정책 전문, 제품 매뉴얼, 지식 베이스 글 | 길고 반복적이라 캐싱 효과가 큼 |
| 앞 | few-shot 예시 | 원하는 스타일을 가르치는 예시 질문과 답 | 매번 같음 |
| 뒤(캐시하지 않는 변하는 부분) | 사용자의 질문 | 요청마다 다름 | 모든 캐시 부분 뒤에 둠 |
표 4.6.3 — 안정적 블록은 앞에서 캐시되고 변하는 질문은 뒤에 있어 캐시를 깨지 않습니다.
- 신발 가게 상담 어시스턴트의 지시문과 반품 정책은 모든 사용자에게 같고 질문만 달라집니다. 이것이 프롬프트 캐싱의 핵심 동기입니다.
- 이 예에서 지시문과 정책은 5,000 토큰, 질문은 50 토큰이므로 매 질문마다 5,050 토큰을 Prefill하는데 그중 5,000 토큰은 지난번과 완전히 같습니다. 이 낭비가 지연(5,000 토큰을 반복 처리하는 시간)과 비용(같은 일에 매번 요금 부과) 두 문제를 만듭니다.
- 첫 요청에서 모델은 5,050 토큰 전체를 Prefill하고, 캐시하도록 표시해 둔 앞 5,000 토큰의 KV 캐시를 저장합니다. 두 번째 사용자의 다른 질문이 오면 5,000 토큰은 저장된 KV 캐시를 불러오고 새 50 토큰에만 새 계산을 합니다.
- 프롬프트에 무엇을 어떤 순서로 넣을지 정하는 일은 컨텍스트 엔지니어링의 영역입니다(4.4 참조).
고객의 프롬프트 템플릿을 받으면 도구 정의, 시스템 지시, 문서, 예시, 질문의 순서인지 확인하고, 사이에 끼어 있는 변동 값(날짜, 사용자 ID)을 맨 뒤로 옮길 수 있는지 먼저 봅니다.
4.6.4 비용·지연 이점
프롬프트 캐싱의 이점은 두 가지입니다.
- 지연 감소. 반복되는 부분을 다시 처리하지 않으므로 사용자가 응답을 받기까지의 지연이 줄고 응답 시작이 빨라집니다.
- 비용 감소. 캐시된 토큰은 정가의 약 10분의 1로 읽히므로, 같은 큰 텍스트 블록을 반복해서 보내는 서비스에서는 절감이 크게 쌓입니다.
- 답의 품질은 바뀌지 않습니다. 모델은 여전히 전체 프롬프트를 보고, 이미 한 일을 다시 하지 않을 뿐입니다.
실제 제공자 수준에서 보면 다음과 같습니다.
- Anthropic(Claude)과 OpenAI(GPT)를 비롯한 주요 AI 제공자가 프롬프트 캐싱을 내장 기능으로 지원합니다(2026년 6월 글 기준). Anthropic은 캐시할 부분을 표시하는 방식이고, OpenAI는 지원 모델에서 기본으로 켜져 있습니다. 저장과 재사용은 제공자가 처리합니다.
- 응답에서 캐시에 쓰인 토큰 수와 캐시에서 읽힌 토큰 수를 확인할 수 있으므로, 캐싱이 실제로 작동하는지 검증할 수 있습니다. 이후 요청에서 읽힌 토큰 수가 보이면 작동하는 것입니다.
- RAG에서는 검색된 문서를 사용자 질문과 함께 모델에 보내는데, 고정 지시문과 반복 전송되는 텍스트가 크고 반복적이므로 캐싱이 비용과 지연을 줄입니다(5.14 참조). 청크마다 같은 전체 문서를 모델에 보내 청크별 맥락 메모를 쓰게 하는 Contextual Retrieval 방식도 같은 방법으로 감당할 만한 비용이 됩니다. 앞 단계의 문서 임베딩도 캐시할 수 있어 쿼리마다 재계산을 피합니다.
- 에이전트 시스템에서는 같은 큰 지시문, 도구 정의, 앞선 텍스트가 매 스텝마다 전송되고 스텝이 많으므로 같은 시작 부분이 엄청나게 많이 재사용됩니다(6.1 참조). 캐시된 접두가 반복해서 읽히는 이 상황이 프롬프트 캐싱이 가장 빛나는 곳입니다.
- 추론 엔진 쪽에서도 같은 접두를 요청 사이에 공유합니다. vLLM은 동일한 접두를 요청 간에 공유하고(10.12 참조), SGLang은 RadixAttention으로 공유 접두의 KV 캐시를 재사용하며, 원문은 이를 기수 트리(radix tree)로 더 정밀하게 찾는다고 설명합니다(10.13 참조), NVIDIA의 TensorRT-LLM은 접두 재사용(prefix reuse)이라는 이름으로 같은 일을 합니다(10.14 참조).
용어를 하나 구분하겠습니다.
용어 주의: 프롬프트 캐싱은 내부 계산(KV 캐시)을 재사용하고 응답은 새로 씁니다. 시맨틱 캐싱은 의미가 같은 질문에 이전 최종 답을 그대로 돌려줍니다. 둘은 다른 기법입니다.
고객 현장에서는 캐시 읽기/쓰기 토큰 수 지표를 대시보드에 올려 적중이 실제로 나오는지 검증하게 하고, 고정 접두의 크기와 요청 간격으로 월 절감액을 추정해 도입 효과를 설명합니다.
4.7 고객이 내일 묻는다면
각 질문에 소리 내어 답해보고, 막히면 표시된 절로 돌아가십시오. 로드맵이 제시한 통과 기준은 "내일 고객이 물어도 설명하고 결정할 수 있는가"입니다.
- "저희 모델이 계산이 섞인 문제에서 자꾸 엉뚱한 숫자를 내요. 답만 짧게 나오게 해 놓았는데요." 무엇을 의심하고 어떻게 고칩니까? (4.1.1, 4.1.2)
- "추론 과정을 쓰게 하면 정확해진다는데, 그 과정을 그대로 믿어도 되나요? 비용은요?" 어떻게 답합니까? (4.1.4)
- "요구사항 서른 줄을 프롬프트 하나에 적었는데 가끔 이상한 답이 나옵니다." 어떻게 쪼개고 어디서 점검합니까? (4.2.1, 4.2.2)
- "5단계 체인으로 만들었더니 최종 답이 틀리고 어디가 문제인지 모르겠어요." 어떤 위험이 있고 무엇을 설계에 넣습니까? (4.2.4)
- "체인 대신 프롬프트 하나로 해도 되는 경우는 언제인가요?" 무엇으로 판단합니까? (4.2.5)
- "일정 계획 문제에서 CoT가 첫 수를 잘못 잡으면 끝까지 틀립니다. 생각의 나무를 쓰면 되나요?" 무엇이 달라지고 무엇을 감당해야 합니까? (4.3.1, 4.3.5)
- "생각의 나무를 쓰면 호출이 얼마나 늘어나나요?" 어떤 변수로 추정합니까? 단계 수가 고정일 때와 길고 가변일 때 탐색을 어떻게 고릅니까? (4.3.3, 4.3.4)
- "프롬프트를 더 잘 써 달라고 했는데 개선이 없습니다." 문구 문제와 컨텍스트 문제를 어떻게 가릅니까? (4.4.1, 4.4.4)
- "RAG와 도구, 메모리를 다 붙였더니 오히려 답이 나빠졌어요." 컨텍스트의 어느 조각을 점검하고 어떤 실수를 의심합니까? (4.4.2, 4.4.4)
- "상담 챗봇이 몇 시간 지나면 처음에 말한 사용자 이름과 목표를 잊어요." 왜 그렇고, 오래된 대화를 버리는 방식과 요약하는 방식은 무엇이 다릅니까? (4.5.1, 4.5.2)
- "요약으로 줄이면 중요한 내용이 사라지지 않나요?" 임계치와 보호 대상을 어떻게 설계합니까? (4.5.3, 4.5.4)
- "같은 5,000토큰짜리 지시문을 매번 보내는데 비용을 줄일 수 있나요? 캐시를 켰는데 적중이 안 나와요." 무엇을 확인합니까? (4.6.1, 4.6.3)
- "요청이 하루에 몇 번뿐인 배치 업무인데 캐싱이 이득인가요?" 어떤 숫자로 판단합니까? (4.6.2, 4.6.4)