10. 프로덕션의 지연 시간과 비용
LLM 서빙의 지연 시간과 비용은 Prefill(프롬프트 읽기)과 Decode(답 쓰기)라는 성격이 다른 두 단계의 병목을 알아보고, 각 병목에 맞는 기법과 엔진을 고르는 문제입니다. FDE는 고객의 증상(첫 단어가 늦다, 답이 끊긴다, GPU 비용이 크다)을 병목으로 번역해 설정과 도구를 고릅니다.
학습 동기: 이 장을 읽으면 고객이 "느리다"와 "비싸다"를 말할 때 TTFT와 TPOT 중 어느 쪽 문제인지 나누고, KV 캐시·페이지드 어텐션·연속 배칭·양자화 중 무엇이 해법인지 근거를 들어 설명할 수 있습니다. 또한 Ollama, vLLM, SGLang, TensorRT-LLM 가운데 고객의 장비와 사용자 수에 맞는 엔진을 추천할 수 있습니다.
선행 가정: 토큰과 다음 토큰 예측 과정(1.12)을 알고 있고, 어텐션이 Key·Value를 쓴다는 정도를 들어 본 상태면 충분합니다. 양자화의 한 줄 정의(0.4.6)와 API 수준의 프롬프트 캐싱(4.6)을 먼저 읽으면 10.3과 10.8이 더 빨리 이해됩니다. 수치 예제는 사칙연산만 사용합니다.
10.1 LLM 추론 최적화 기법 총정리
원문: LLM Inference Optimization
영상: LLM Inference Optimization
이 글은 2026년 6월 14일 게시된 색인형 글로서, 추론 최적화 기법이 어떤 문제에서 출발해 서로 어떻게 이어지는지를 한 장의 지도로 보여 줍니다. 영상 자막은 각 기법을 비유로 풀어 설명하므로, 이 절은 글의 목차와 자막의 설명을 합쳐 기법 사이의 인과 사슬을 세웁니다.
**LLM 추론 최적화(LLM Inference Optimization)**는 모델이 답을 더 빨리 내고, 같은 서버로 더 많은 사용자를 더 낮은 비용으로 받게 하는 기법 묶음입니다. 사용자의 요청은 브라우저나 앱에서 서버로 가고, 서버는 시스템 프롬프트와 사용자 설정을 덧붙여 LLM에 넣고, LLM이 출력을 돌려줍니다. 이 구간의 대기 시간이 길면 사용자 경험이 나빠지므로 서버 쪽에서 줄여야 합니다.
현재 널리 쓰이는 서빙 라이브러리에는 이 기법들이 기본값으로 들어 있습니다. 따라서 FDE가 기법을 새로 구현하는 일은 드물고, 어떤 기법이 어떤 병목을 푸는지 알고 고객의 증상에 맞는 설정을 고르는 일이 실무입니다.
| 기법 | 해결하는 문제 | 상세 절 |
|---|---|---|
| KV 캐시 | 토큰마다 같은 Key·Value를 다시 계산 | 10.3 |
| KV 캐시 압축 | 캐시가 차지하는 메모리 | 10.1.1 |
| 페이지드 어텐션 | 캐시를 담는 메모리 조각 낭비 | 10.4 |
| FlashAttention | 어텐션 계산의 GPU 메모리 왕복 | 10.1.2 |
| GQA | 헤드마다 따로 두는 Key·Value | 10.1.2 |
| 투기적 디코딩 | 한 토큰씩 생성하는 느림 | 10.6 |
| 연속 배칭 | 끝난 요청이 남긴 GPU 빈 칸 | 10.5 |
| 프롬프트 캐싱 | 반복되는 접두의 재계산 | 4.6 |
표 10.1.1 — 추론 최적화 기법과 해결 대상. 한 기법이 병목을 풀면 다음 병목이 드러나고 그 병목을 푸는 기법이 이어집니다.
10.1.1 KV 캐시 압축
KV 캐시는 LLM이 이미 읽은 토큰의 Key와 Value를 저장해 두는 메모리입니다(10.3 참조). 영상은 이 캐시의 출발점을 예문으로 설명합니다. 프롬프트가 I love이면 모델은 teaching을 예측하기 위해 두 토큰의 Key·Value를 계산하고, 다음에는 I love teaching을 넣어 AI를 예측하면서 앞의 두 토큰을 처음부터 다시 계산합니다. 이 반복을 막으려고 계산 결과를 저장한 것이 KV 캐시입니다.
그런데 캐시가 속도 문제를 풀자마자 메모리가 새로운 병목이 됩니다. 캐시는 대화가 길어질수록, 동시 사용자가 늘수록 커지기 때문입니다. **KV 캐시 압축(KV Cache Compression)**은 모델이 답을 쓰는 동안 대화 내용을 기억하는 데 쓰는 메모리를 줄이는 기법 묶음이며, 글은 네 가지 접근을 나열합니다.
- 양자화: 캐시에 저장하는 숫자의 비트 수를 줄입니다. 가중치 양자화와 같은 원리입니다(10.8 참조).
- 토큰 퇴출(token eviction): 덜 중요한 과거 토큰의 항목을 캐시에서 버립니다.
- 헤드 간 Key·Value 공유: 여러 어텐션 헤드가 같은 Key·Value를 쓰게 합니다. 10.1.2의 GQA가 대표적입니다.
- 저랭크 압축(low-rank compression): Key·Value 행렬을 더 작은 차원으로 압축해 저장합니다.
접근마다 줄이는 축이 다릅니다. 첫째 접근은 숫자 하나의 크기를, 둘째는 토큰의 개수를, 셋째는 헤드의 개수를, 넷째는 차원을 줄입니다. 글에는 이 접근들의 비교표와 "언제 무엇을 쓸 것인가" 항목이 있으나 이 색인 글에는 수치가 없으므로, 어느 접근이 얼마나 줄이는지는 단정하지 않습니다.
압축은 공짜가 아닙니다. 버리거나 줄인 정보는 답의 품질에 영향을 줄 수 있으므로, 고객이 긴 문서 질의에서 "뒷부분 내용을 놓친다"고 말하면 토큰 퇴출이나 낮은 비트 캐시가 켜져 있는지 확인합니다.
10.1.2 FlashAttention과 GQA(Grouped Query Attention)
두 기법은 모두 어텐션 층을 겨냥하지만 줄이는 대상이 다릅니다. FlashAttention은 같은 계산을 GPU 안에서 더 빨리 하는 방법이고, GQA는 모델 구조를 바꿔 저장할 Key·Value의 양을 줄이는 방법입니다.
FlashAttention은 GPU의 메모리 계층을 이용합니다. GPU에는 용량이 크지만 느린 메모리(HBM)와 용량이 작지만 빠른 메모리(SRAM)가 있습니다. 어텐션의 Q·K·V 행렬은 커서 통째로 큰 메모리에서 계산하면 편해 보이지만, 행렬 곱셈은 조각으로 나눠 계산해도 결과가 같습니다. 그러면 작고 빠른 메모리에서 조각을 계산하며 오가는 비용을 치르더라도, 큰 메모리에서 한 번에 계산하는 것보다 빠르다는 사실이 실험으로 확인되었습니다. 핵심 개념은 두 가지입니다.
- 타일링(tiling): 큰 행렬을 작은 블록으로 쪼개 빠른 메모리에서 계산합니다.
- 온라인 Softmax(online softmax): 전체 행렬이 없어도 조각 단위로 Softmax를 이어서 계산하는 방식입니다.
원문 글에는 역전파 단계의 재계산과 FlashAttention 2, 3의 항목도 있습니다. 영상 화자는 이 기법이 "거의 모든 현대 LLM"에 쓰인다고 말합니다.
**GQA(Grouped Query Attention)**는 진화 순서로 이해하면 쉽습니다. 원래의 멀티 헤드 어텐션(MHA)에서는 쿼리마다 Key·Value가 하나씩 있어 Q1,K1,V1, Q2,K2,V2처럼 짝을 이룹니다. 멀티 쿼리 어텐션(MQA)은 모든 쿼리가 하나의 Key·Value를 공유합니다. GQA는 그 중간으로, 쿼리를 묶음으로 나눠 묶음마다 Key·Value를 하나씩 둡니다. 영상의 예에서 쿼리가 100개이면 MHA는 Key·Value 100쌍, MQA는 1쌍이고, 10개씩 묶은 GQA는 10쌍입니다. 저장할 Key·Value가 MHA의 10분의 1이므로 KV 캐시도 그만큼 줄어듭니다.
| 방식 | 쿼리 100개일 때 Key·Value 쌍 | 품질 | 메모리·연산 |
|---|---|---|---|
| MHA | 100 | 가장 좋음 | 가장 큼 |
| GQA(10개씩 묶음) | 10 | 중간 | 중간 |
| MQA | 1 | 가장 낮음(공유가 과함) | 가장 작음 |
표 10.1.2 — 같은 Key·Value를 얼마나 많은 쿼리가 공유하는가가 정확도와 메모리를 맞바꿉니다.
영상 화자는 이 구조를 "정확도와 연산·메모리 사이의 균형점"이라고 부릅니다. 원문은 GQA가 MHA와 MQA를 일반화한 형태이며, 기존 MHA 모델을 GQA로 바꾸는 업트레이닝(uptraining)이 있고, 실제 모델에 널리 쓰인다고 안내합니다.
FDE가 고객의 모델 후보를 비교할 때 "이 모델은 GQA를 쓰는가"는 같은 GPU에서 동시 사용자를 얼마나 받을 수 있는지를 가르는 질문입니다. FlashAttention은 거의 모든 현대 LLM이 쓰는 기법이므로 고객과 고를 선택지라기보다 사용 중인지 확인할 전제입니다.
10.1.3 Medusa·EAGLE·N-gram 투기적 추측
**투기적 디코딩(Speculative Decoding)**은 작은 초안(draft) 모델이 여러 토큰을 먼저 추측하고, 큰 대상(target) 모델이 그 추측을 한 번에 검증하는 기법입니다(10.6 참조). 영상 화자가 강조하는 비대칭이 이 기법의 전제입니다. 생성은 앞 토큰이 있어야 다음 토큰이 나오므로 병렬화할 수 없지만, 검증은 이미 나온 토큰들을 한꺼번에 확인하므로 병렬화할 수 있습니다. 예컨대 초안이 100토큰을 쓰고 10토큰마다 검증하며, 큰 모델이 7번째에서 오류를 찾으면 7개는 받아들이고 8~10번째는 초안 모델이 다시 씁니다. 토큰마다 검증하면 큰 모델을 매번 돌리므로 이득이 없어, 묶음 검증이 요점입니다.
문제는 별도의 초안 모델을 두는 비용입니다. 이 문제를 푸는 세 가지 변형이 글에 소개됩니다.
| 변형 | 초안을 만드는 방식 | 초안 모델 필요 여부 |
|---|---|---|
| Medusa | 대상 모델에 여러 개의 추가 헤드를 달아 미래 토큰 여러 개를 동시에 추측하고, 트리 어텐션으로 많은 추측을 한 번에 검증 | 불필요 |
| EAGLE | 토큰 단계가 아니라 모델 내부 피처 단계에서 초안을 만들어 추측이 맞을 확률을 높임. EAGLE-2는 동적 초안 트리를 사용 | 작은 초안 구조 필요 |
| N-gram 추측 | 이미 나온 텍스트에서 비슷한 단어열을 찾아 다음 몇 단어를 복사해 추측 | 불필요(모델 없음) |
표 10.1.3 — 초안 생성 방식에 따른 투기적 추측의 세 변형.
Medusa 글은 2~3배 빠른 생성을, 투기적 디코딩 글은 품질 손실 없이 약 2~3배의 속도 향상을 말합니다. N-gram 추측은 프롬프트에 이미 있는 문장을 되풀이하는 작업에서 잘 맞고, 참조할 텍스트가 없는 새 글쓰기에서는 효과가 떨어지는 방식입니다. 세 변형 모두 검증을 거치므로 출력은 대상 모델이 직접 생성했을 때와 같습니다.
고객이 "초안 모델을 따로 올릴 GPU 여유가 없다"고 하면 Medusa류 헤드 방식이나 N-gram 추측이 후보이고, 코드 수정이나 문서 요약처럼 입력 문장이 출력에 많이 되풀이되는 업무라면 N-gram 추측이 가장 가볍습니다.
10.1.4 추론 엔진·하드웨어 지도: vLLM·SGLang·TensorRT-LLM·Ollama·CUDA 커널·LPU
앞의 기법들은 개별 아이디어이고, 실제 서비스에서는 이를 묶은 추론 엔진과 그 아래의 하드웨어가 선택지입니다. 글은 이 지도를 다음 순서로 보여 줍니다.
| 구성 요소 | 한 줄 역할 | 상세 절 |
|---|---|---|
| vLLM | 페이지드 어텐션과 연속 배칭으로 많은 사용자를 받는 서빙 엔진 | 10.12 |
| SGLang | 지난 작업을 재사용하는 RadixAttention과 프런트엔드 언어를 가진 서빙 엔진 | 10.13 |
| TensorRT-LLM | NVIDIA GPU에서 최고 속도를 뽑는 NVIDIA의 엔진. 모델을 미리 엔진으로 빌드 | 10.14 |
| Ollama | 한 줄 명령으로 내 컴퓨터에 LLM을 내려받아 실행하는 도구 | 10.11 |
| CUDA 커널 | GPU에서 도는 작은 프로그램으로, 거의 모든 AI 모델의 연산 기반 | 12.3 |
| LPU | 학습이 끝난 LLM을 돌려 텍스트를 가장 빨리 내는 데 특화된 칩. 병목이 연산이 아니라 메모리라는 관찰에서 출발 | 12.5 |
표 10.1.4 — 엔진은 소프트웨어 계층, 커널과 LPU는 하드웨어에 가까운 계층입니다.
기법 사이의 경계도 구분해야 합니다. 페이지드 어텐션은 캐시를 담는 메모리 낭비를 풀고(10.4 참조), 연속 배칭은 생성 단계마다 GPU를 쉬지 않게 해 두 기법이 함께 동시 사용자 수를 늘립니다(10.5 참조). 같은 사용자 요청이라도 프롬프트 읽기(prefill)와 답 쓰기(decode)는 병목이 다르며(10.2 참조), 두 단계를 서로 다른 기계에서 돌리는 방식이 따로 있습니다(10.7 참조). 사용자 앞의 프롬프트 접두 재사용은 API 수준의 프롬프트 캐싱으로 제공됩니다(4.6 참조). 로컬 실행 쪽은 양자화와 파일 형식(10.8, 10.9)과 실행 엔진(10.10)이 한 묶음입니다.
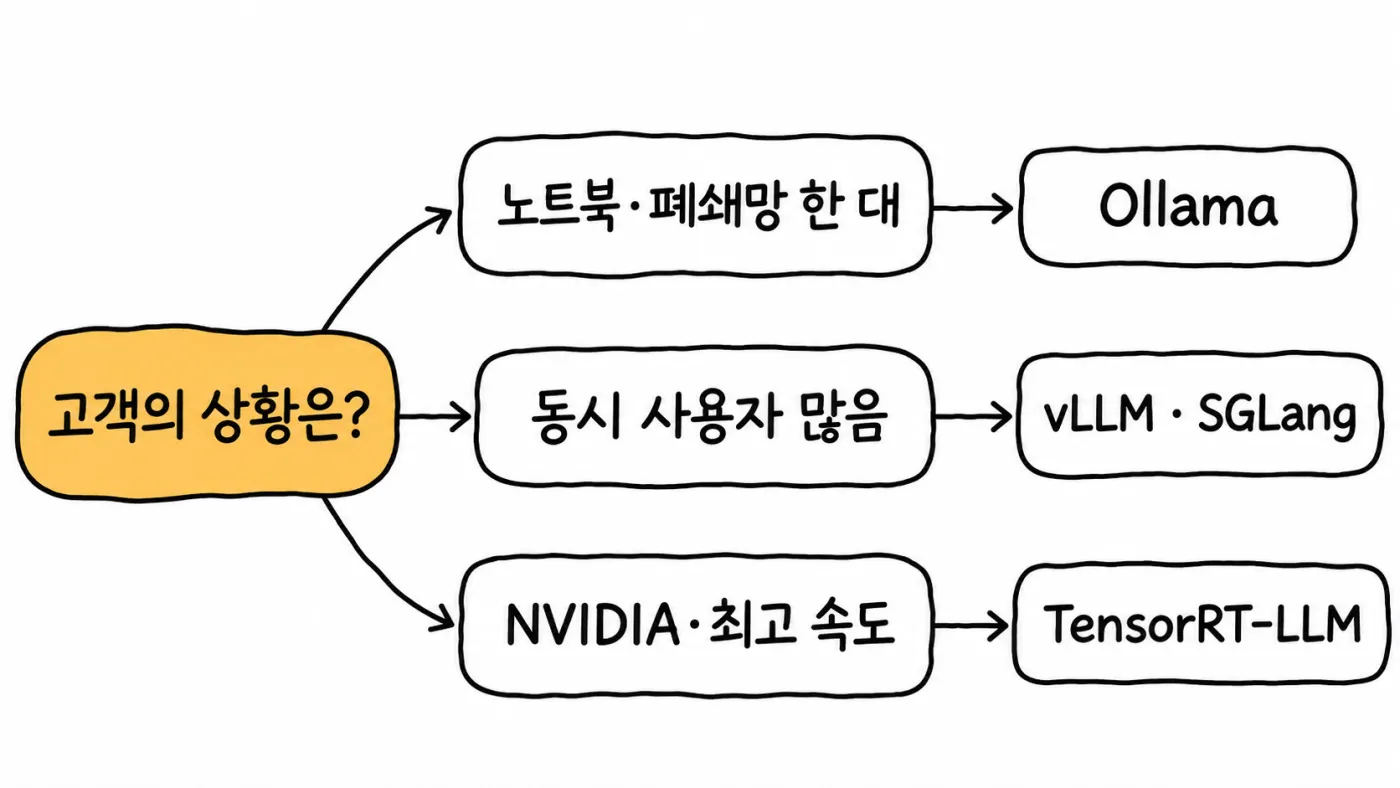
고객 현장에서는 이 표를 질문 순서로 씁니다. 동시 사용자가 많은 서버인가(vLLM·SGLang), NVIDIA GPU를 이미 쓰고 있고 빌드 비용을 감수할 수 있는가(TensorRT-LLM), 개발자 노트북이나 폐쇄망 단일 장비인가(Ollama·llama.cpp) 하는 답이 후보를 좁힙니다.
10.2 Prefill vs Decode
원문: Prefill vs Decode: LLM Inference Optimization
영상: The First-Token Latency Problem in LLMs
LLM이 한 요청에 답하는 과정은 서로 병목이 반대인 두 단계로 나뉘고, 대부분의 추론 최적화 기법은 그중 한 단계를 겨냥합니다. 이 절은 2026년 7월 5일 게시된 글과 영상 자막(첫 토큰이 느린 이유)을 바탕으로, 어떤 지표가 어느 단계에 속하며 기법이 어디를 고치는지를 한 장의 지도로 만듭니다.
기본 용어부터 맞춥니다. **추론(inference)**은 학습이 끝난 모델이 질문을 읽고 답을 쓰는 일이고, 모델은 답을 한 번에 쓰지 않고 토큰 단위로 하나씩 씁니다. 토큰은 단어나 단어의 일부이며, 짧은 문장이 대략 15~20토큰이고 1,000토큰 프롬프트가 대략 한 페이지 분량입니다. 한 사용자의 질문이 **요청(request)**입니다. 토큰이 하나씩 나타나는 모습이 스트리밍입니다(2.15 참조). 두 단계는 같은 모델과 같은 가중치를 쓰고, 일하는 방식만 다릅니다.
10.2.1 Prefill 단계
Prefill은 모델이 입력 프롬프트 전체를 한 번에 읽어 처리하고 첫 번째 출력 토큰을 내는 단계입니다. 시험장에서 학생이 답을 쓰기 전에 문제지를 먼저 훑어보는 일에 비유됩니다. 프롬프트가 1,000토큰이면 1,000토큰을 순서대로가 아니라 동시에 처리하며, 이를 병렬 처리라 합니다. 입력 전체가 이미 알려져 있으므로 기다릴 이유가 없기 때문입니다.
- KV 캐시 작성: 읽는 동안 모델은 토큰마다 Key(K)와 Value(V)를 계산해 저장합니다. 이렇게 모인 K와 V가 KV 캐시이며, 프롬프트에 대한 모델의 메모 역할을 합니다(10.3 참조).
- 첫 토큰만 생성: Prefill이 만드는 것은 첫 번째 출력 토큰뿐이고 나머지는 Decode가 만듭니다.
- 연산 병목: 여러 토큰을 함께 처리하면 계산이 큰 행렬끼리의 곱셈이 되고, 이는 GPU가 가장 잘하는 일입니다. 고성능 GPU에서 수학 연산 장치가 큰 프롬프트일 때 90퍼센트 이상까지 바쁘게 돌 수 있다고 글은 말합니다(2026년 7월 글 기준).
- 프롬프트가 길수록 오래 걸림: 일부 작업은 프롬프트 길이보다 빠르게 늘어납니다. 어텐션에서는 모든 토큰이 다른 모든 토큰을 보므로, 프롬프트를 100토큰에서 200토큰으로 두 배 늘리면 이 부분의 작업이 2배가 아니라 약 4배(200² ÷ 100²)가 됩니다. 10명이 모인 방의 악수는 45번이지만 100명이면 4,950번으로 늘어나는 것과 같은 구조입니다.
Prefill이 빠르면 첫 토큰이 일찍 나옵니다. 영상은 이를 "한 번 하는 무거운 일"이라고 요약합니다. 고객이 긴 문서를 통째로 넣는 요약 서비스를 요청하면, 응답 시작이 느린 원인은 대개 이 단계이므로 입력 길이부터 확인합니다.
10.2.2 Decode 단계
Decode는 모델이 KV 캐시를 재사용하며 출력 토큰을 한 번에 하나씩 만드는 단계입니다. 문제지를 읽은 학생이 답안을 한 단어씩 써 내려가는 모습에 해당합니다. 토큰 하나를 만들 때마다 그 토큰을 입력으로 되먹이므로 각 토큰은 앞 토큰이 끝나야 나오며, 이 구조가 자기회귀(autoregressive) 생성입니다(2.3 참조). 그래서 Decode는 순차적이고, Prefill처럼 출력 토큰을 한꺼번에 처리할 수 없습니다.
매 Decode 스텝에서 모델은 프롬프트 전체를 다시 읽지 않습니다. 새 토큰 하나의 Key·Value만 계산하고, 캐시에서 이전 Key·Value를 읽어 다음 토큰을 만든 뒤, 새 토큰의 Key·Value를 캐시 끝에 붙입니다. 그래서 스텝마다 캐시는 정확히 한 항목씩 늘어납니다.
- 스텝 수: 답이 200토큰이면 Prefill 1번과 순차 Decode 200스텝이 필요합니다.
- 시간 비중: 일반 요청에서 Prefill은 1초 미만에 끝나지만 Decode는 수 초 동안 이어집니다. 전체 시간 대부분이 Decode에서 쓰이므로 최적화 기법도 Decode에 몰려 있습니다.
- 연산량 대비 읽는 양: 스텝당 계산은 큰 표와 얇은 벡터 한 줄의 곱이라 작지만, 그 한 토큰을 만들기 위해서도 모델 가중치 전체와 커지는 KV 캐시를 메모리에서 읽어야 합니다.
Decode가 빠르면 나머지 답이 빨리 흐릅니다. 서비스 전체가 느리다고 할 때 출력 길이가 긴 업무(보고서 생성 등)인지, 입력이 긴 업무인지를 구분하면 어느 단계를 고칠지 갈립니다.
10.2.3 연산 병목 vs 메모리 병목
**병목(bottleneck)**은 전체 속도를 붙잡는 가장 느린 한 부분이며, 병의 좁은 목처럼 물 쏟아지는 속도를 제한합니다. 두 단계는 병목이 반대이고 대부분의 최적화는 이 사실에서 나옵니다.
| 항목 | Prefill | Decode |
|---|---|---|
| 하는 일 | 입력 프롬프트 전체 처리 | 출력 토큰을 하나씩 생성 |
| 병렬성 | 병렬(프롬프트 토큰 동시) | 순차(한 번에 한 토큰) |
| 스텝 | 큰 한 번 | 작은 N번 |
| 연산 모양 | 큰 표 × 큰 표 | 큰 표 × 얇은 벡터 |
| 병목 | 연산(compute-bound) | 메모리 대역폭(memory-bandwidth-bound) |
| GPU 활용 | 높음(90퍼센트 이상까지) | 낮음(요청 하나일 때 약 20~40퍼센트) |
| KV 캐시 | 작성 | 읽고 확장 |
| 지연 지표 | TTFT | TPOT |
| 비용 요인 | 프롬프트 길이 | 스텝마다 가중치+KV 캐시 전체를 읽음 |
표 10.2.1 — Prefill과 Decode는 서로의 거울상입니다. 활용률 수치는 고성능 GPU 기준이며 2026년 7월 글 기준입니다.
**메모리 대역폭(memory bandwidth)**은 GPU 메모리에서 수학 연산 장치로 데이터를 옮기는 속도입니다. GPU 안에서 계산은 빠르지만 큰 데이터를 메모리에서 가져오는 일은 상대적으로 느립니다. 요리사가 거대한 창고에서 재료 하나를 가져와 썰고 다시 가는 상황을 떠올리면, 오가는 시간이 썰기보다 훨씬 길어 칼이 대부분 놀게 됩니다. Prefill은 한 무더기를 한꺼번에 써는 작업이라 손이 쉬지 않습니다.
이 차이가 두 가지를 설명합니다.
- 긴 프롬프트가 응답 시작을 늦춤: 입력이 길면 Prefill의 계산이 늘기 때문입니다.
- Decode에서는 많은 사용자를 함께 돌려도 추가 비용이 작음: 스텝 하나가 GPU 연산 능력을 거의 쓰지 않으므로 여러 사용자의 스텝을 묶어 돌릴 수 있습니다. 이것이 배칭입니다(10.5 참조).
두 단계가 하드웨어에 원하는 것이 다르기 때문에 서빙 시스템 중에는 Prefill과 Decode를 서로 다른 GPU에서 돌리는 구성도 있습니다(10.7 참조). 병목이 연산인지 메모리인지에 따라 개선책이 달라지므로, 고객의 GPU 사용률 그래프를 볼 때 낮은 사용률이 곧 낭비가 아니라 Decode의 정상 모습일 수 있음을 설명해 줍니다.
10.2.4 핵심 지표: TTFT·TPOT·처리량·종단 지연
측정하지 않으면 최적화하지 못하며, 지표마다 담당 단계가 정해져 있습니다.
- TTFT(Time To First Token): 요청을 보낸 뒤 첫 출력 토큰이 보이기까지의 시간으로, 거의 Prefill이 정합니다. 대략 Prefill 시간에 Decode 한 스텝을 더한 값이며 프롬프트가 길수록 커집니다.
- TPOT(Time Per Output Token): 첫 토큰 이후 토큰 하나를 만드는 평균 시간으로, Decode가 정합니다. 토큰 사이 간격을 뜻하는 **ITL(Inter-Token Latency)**과 요청 하나일 때는 같은 개념으로 봐도 됩니다. TPOT이 50밀리초이면 초당 20토큰, 25밀리초이면 초당 40토큰이므로 TPOT을 절반으로 줄이면 사용자가 느끼는 스트리밍 속도는 두 배가 됩니다.
- 처리량(throughput): 동시에 서비스하는 모든 사용자에 걸쳐 초당 생성하는 전체 토큰 수입니다. 사용자 한 명의 지표가 아니라 시스템 지표입니다. 요청들을 묶어 함께 돌리는 것이 **배치(batch)**이고 요청 수가 배치 크기입니다.
- 종단 지연(end-to-end latency): 요청 전송부터 마지막 토큰 수신까지의 시간입니다.
종단 지연 = TTFT + (출력 토큰 수 - 1) × TPOT첫 토큰은 TTFT에 이미 포함되므로 출력 토큰 수에서 1을 뺍니다. 예컨대 TTFT가 400밀리초, 답이 200토큰, TPOT가 25밀리초이면 남은 199토큰이 각 25밀리초이므로 400 + 199 × 25 = 5,375밀리초, 약 5.4초입니다. 같은 조건에서 TPOT만 50밀리초로 느려지면 400 + 199 × 50 = 10,350밀리초로 약 10.4초가 됩니다. 응답이 길수록 TPOT가 종단 지연을 지배한다는 뜻입니다.
flowchart LR
    S["요청 전송"] --> T["TTFT 400ms (Prefill + 첫 토큰)"]
    T --> R["토큰 2~200: 199개 x TPOT 25ms = 4,975ms"]
    R --> E["마지막 토큰, 합계 5,375ms"]
그림 10.2.1 — 응답은 TTFT 이후 TPOT 간격으로 흐릅니다. 수치는 원문 예시를 python3로 재계산한 값입니다.
한 가지 긴장 관계가 있습니다. TTFT와 TPOT는 사용자별 지연이라 작을수록 좋고, 처리량은 시스템 지표라 클수록 좋은데 둘은 서로 당깁니다. 배치를 키우면 초당 토큰 수는 늘지만 각 사용자의 대기는 길어지고, 배치를 줄이면 반응은 빠르지만 GPU 용량이 낭비됩니다. 챗봇은 낮은 TTFT와 TPOT를, 대량 문서 요약 작업은 높은 처리량을 원합니다. Prefill이 TTFT를, Decode가 TPOT와 처리량을 담당하므로 최적화 앞에서는 어느 지표를 개선하려는지부터 묻습니다.
10.2.5 KV 캐시가 잇는 두 단계
KV 캐시는 Prefill이 쓰고 Decode가 읽고 키우는, 두 단계를 잇는 다리입니다. 영상의 설명을 빌리면 "모델이 이미 본 것의 기억이며 같은 일을 되풀이하지 않게 합니다."
flowchart TD
    P["입력 프롬프트 (예: 1,000토큰)"] --> PF["Prefill: 전체 병렬 처리, KV 캐시 작성, 첫 토큰"]
    PF --> D["Decode: 스텝당 토큰 1개, 캐시 읽기 + 항목 1개 추가"]
    D <--> C["KV 캐시: 지금까지 모든 토큰의 Key·Value"]
    PF --> C
    D --> A["토큰 2, 3, ... N: 전체 답"]
그림 10.2.2 — Prefill이 한 번 쓴 캐시를 Decode의 모든 스텝이 읽고 확장합니다.
과거 토큰의 Key와 Value는 한번 계산하면 뒤에 오는 토큰에 영향을 받지 않으므로 변하지 않고, 그래서 저장해 재사용할 수 있습니다. 반면 Query는 현재 토큰이 지금 무엇을 찾는지를 나타내므로 스텝마다 새로 계산되며 저장하지 않습니다. 3토큰 프롬프트로 확인하면 흐름이 분명합니다.
| 시점 | 캐시 내용 | 항목 수 |
|---|---|---|
| Prefill 직후 | P1, P2, P3 | 3 |
| Decode 1스텝 | P1, P2, P3, T4 | 4 |
| Decode 2스텝 | P1, P2, P3, T4, T5 | 5 |
| Decode 3스텝 | P1, P2, P3, T4, T5, T6 | 6 |
표 10.2.2 — 캐시는 스텝마다 정확히 한 항목씩 늘고, 각 스텝은 새 토큰 하나의 Key·Value만 계산합니다.
캐시가 없다면 스텝 N마다 앞선 N개 토큰의 Key·Value를 모두 다시 계산하므로 답 전체에서 총 작업이 길이의 제곱 정도로 늘어납니다. 캐시는 각 토큰의 Key·Value를 정확히 한 번만 계산하게 하므로 작은 최적화가 아니라 Decode를 성립시키는 전제입니다. 대가가 있습니다. 캐시는 프롬프트 크기에서 시작해 생성 토큰마다 늘고, 사용자마다 자기 캐시가 필요해 사용자 수에도 비례합니다. 긴 컨텍스트와 많은 동시 사용자가 겹치면 캐시 총량이 모델 가중치 크기를 넘어 GPU 메모리를 채울 수 있습니다. 이 때문에 캐시 자체를 줄이는 압축 기법군이 따로 있습니다(10.1.1 참조).
고객의 동시 접속 한도가 GPU 연산이 아니라 메모리에서 막힌다면 원인은 대개 이 캐시이며, 캐시 크기는 동시 사용자 수와 컨텍스트 길이를 곱해 가늠합니다.
10.2.6 최적화 기법의 단계별 매핑: chunked prefill·prefix caching 등
각 기법은 특정 단계나 지표를 겨냥합니다. 원문은 일곱 가지를 다루며, 앞의 둘은 이미 설명한 기반입니다.
- KV 캐시(Decode의 기반): 새 토큰 하나만 계산하게 해 Decode를 빠르게 만듭니다. 대신 캐시가 메모리를 채우므로 아래 기법들이 존재합니다(10.3 참조).
- 연속 배칭(처리량): 정적 배칭은 요청 묶음을 만들고 가장 느린 요청이 끝날 때까지 기다려 일찍 끝난 요청의 슬롯이 비어 GPU가 낭비됩니다. 연속 배칭은 Decode 스텝마다 배칭을 결정해, 한 요청이 끝나는 순간 슬롯을 비우고 대기 중인 요청이 다음 스텝에 들어오게 합니다. 손님이 내리는 즉시 다음 손님을 태우는 합승 택시와 같습니다(10.5 참조).
- Chunked prefill(다른 사용자의 스트리밍 보호): 긴 프롬프트의 Prefill이 하나의 거대한 스텝으로 돌면 GPU를 독점해 이미 Decode 중인 다른 사용자의 토큰이 멈춰 답이 끊깁니다. Chunked prefill은 긴 Prefill을 여러 작은 조각으로 쪼개고 조각 사이에 작은 Decode 스텝을 끼워 넣습니다. 연산 위주인 Prefill과 메모리 위주인 Decode를 한 배치에 섞어 하드웨어를 더 잘 쓰는 부수 효과도 있습니다. 전체 계산량은 그대로이므로 Prefill 자체를 빠르게 하지는 않습니다. 한 개의 화구로 연회 주문을 통째로 조리하면 다른 테이블 음식이 식으므로, 작은 단위로 나눠 짧은 주문을 사이에 끼우는 요리사에 비유됩니다.
- Prefix caching 또는 프롬프트 캐싱(Prefill, TTFT): 요청들이 같은 긴 앞부분(prefix)으로 시작하는 경우가 많습니다. 고정된 시스템 지침, 질문 대상 문서, 대화의 이전 턴이 예입니다. 공유 접두의 KV 캐시를 요청 간에 재사용해 그 부분의 Prefill을 한 번만 계산하므로 TTFT가 줄고, 반복 프롬프트에서 캐시 적중률이 높으면 비용이 크게 절감됩니다. 공통 접두가 없는 요청은 전체 Prefill로 돌아갑니다. API 수준의 동작은 프롬프트 캐싱 절을 봅니다(4.6 참조).
- 분리 서빙(TTFT·TPOT 모두): 한 GPU에서 둘을 함께 하면 무거운 Prefill 폭주가 다른 사용자의 Decode를 멈추게 하고 단계별로 따로 튜닝할 수 없습니다. 분리 서빙은 Prefill을 한 GPU 풀에서, Decode를 다른 GPU 풀에서 하고 Prefill GPU가 만든 KV 캐시를 빠른 연결로 Decode GPU에 넘깁니다. 대가는 캐시를 네트워크로 옮기는 비용과 모델을 풀마다 복제하는 부담이며, 엄격한 TTFT·TPOT 목표를 동시에 맞춰야 하는 대규모에서 이득이 큽니다. 소규모에서는 단일 GPU의 연속 배칭과 chunked prefill로 충분한 경우가 많습니다(10.7 참조). 원문은 SGLang이 이 분리를 chunked prefill, prefix caching과 함께 지원하고, TensorRT-LLM도 chunked prefill을 지원한다고 소개합니다(10.13, 10.14 참조).
- 투기적 디코딩(Decode, TPOT): 작은 초안 모델이 다음 몇 토큰을 싸게 추측하고 큰 대상 모델이 한 번의 병렬 패스로 전부 검증해, 맞은 추측은 유지하고 첫 오답과 그 뒤는 큰 모델이 고칩니다. Decode가 메모리 병목이라 가능한 기법입니다. 가중치를 어차피 메모리에서 읽어야 하므로 추측 5개를 함께 검증해도 1토큰을 만들 때와 읽는 양이 거의 같아 맞은 추측이 거의 공짜가 됩니다. 5개 추측 중 3개가 맞고 4번째가 틀리면 1번 패스 비용으로 3개 수락에 교정 1개를 얻습니다. 속도 향상은 초안이 얼마나 자주 수락되는지에 따라 보통 2~3배입니다(10.6 참조). 모델이 가장 확률 높은 토큰을 고르는 설정에서는 대상 모델이 혼자 만든 토큰과 같고, 무작위성이 있으면 같은 확률 분포에서 뽑으므로 품질이 보존되고 표현만 실행마다 다를 수 있습니다(2.11 참조). 초안을 만드는 다른 길로는 대상 모델의 추가 헤드(Medusa), 내부 피처 단계에서 초안을 만드는 EAGLE, 프롬프트에서 추측을 복사하는 N-gram 추측이 있습니다(10.1.3 참조).
- 페이지드 어텐션(KV 캐시 메모리 효율): 단순한 시스템은 요청마다 가장 긴 답에 맞춰 연속된 큰 메모리 덩어리를 잡아 대부분이 빈 채로 낭비됩니다. 페이지드 어텐션은 KV 캐시를 보통 토큰 16개 크기의 고정 작은 블록으로 쪼개 GPU 메모리 어디에나 두고, 블록 테이블이 요청별 블록 위치를 기억하며, 시퀀스가 실제로 자랄 때만 블록을 추가합니다. 낭비가 거의 사라지고 배치를 키울 수 있어 처리량이 오릅니다. 같은 접두를 가진 두 요청이 같은 물리 블록을 가리킬 수 있어 prefix caching의 기반이 되며, 둘은 별개 개념입니다(10.4 참조).
| 기법 | 주된 대상 | 개선하는 것 |
|---|---|---|
| KV 캐시 | Decode | 재계산 회피로 Decode 가속 |
| 연속 배칭 | 두 단계 | 처리량 |
| Chunked prefill | 다른 사용자 스트리밍 | 긴 Prefill이 Decode를 막는 것을 방지(ITL 보호) |
| Prefix caching | Prefill | TTFT |
| 분리 서빙 | 두 단계 | TTFT와 TPOT를 규모에서 독립적으로 |
| 투기적 디코딩 | Decode | TPOT |
| 페이지드 어텐션 | KV 캐시 메모리 | 처리량(더 큰 배치) |
표 10.2.3 — 첫 단어를 빠르게 하려면 Prefill 쪽을, 스트리밍과 동시 사용자를 늘리려면 Decode 쪽을 봅니다.
고객 증상에서 기법으로 가는 경로는 이렇습니다. 첫 글자가 늦게 나오면 접두 재사용과 입력 길이를, 글이 흐르다 끊기면 chunked prefill을, 동시 사용자 수가 모자라면 페이지드 어텐션과 연속 배칭을, 스트리밍 속도가 느리면 투기적 디코딩을 먼저 의심합니다.
원문 FAQ의 요점도 같은 방향입니다. 두 단계가 다른 모델을 쓰는 것이 아니며, 캐시에는 Query가 저장되지 않고, 투기적 디코딩은 품질을 낮추지 않으며, chunked prefill은 Prefill 자체를 빠르게 하지 않고 진행 중인 답이 멈추는 것만 막습니다.
10.3 KV 캐시(KV Cache)
원문: KV Cache in LLMs
KV 캐시는 프롬프트 캐싱과 페이지드 어텐션, 연속 배칭이 모두 기대는 바탕 개념이므로, 이 절은 "무엇을 저장하고 왜 저장하는가"를 예문 한 줄로 끝까지 따라갑니다. 2026년 3월 27일 게시된 글을 기준으로 하며, API 수준의 접두 재사용은 4.6에 있습니다(4.6 참조).
KV 캐시는 LLM 안에서 이미 처리한 토큰의 작업 결과(Key와 Value)를 저장해 두어, 새 토큰을 만들 때마다 같은 일을 되풀이하지 않게 하는 메모리입니다. LLM은 토큰을 하나씩 만드는데(2.3 참조), 입력 I love를 보고 teaching을 예측하면 시퀀스는 I love teaching이 되고, 이를 보고 AI를 예측하는 식으로 이어집니다. 새 토큰을 예측할 때마다 앞의 모든 토큰을 봐야 한다는 점이 문제의 출발입니다.
10.3.1 반복 계산 문제
모델 안의 어텐션 층은 트랜스포머의 핵심으로, 다음 토큰을 예측하는 데 어느 이전 토큰이 중요한지를 가려냅니다(2.8, 2.9 참조). 층 안에서 토큰은 세 가지로 바뀌며, 교실에 새로 전학 온 학생이 특정 주제를 도와줄 사람을 찾는 상황으로 구분됩니다.
- Query(Q): 새 학생의 질문 "이 주제를 아는 사람은 누구인가". 예측 중인 토큰마다 생기며 그 토큰이 찾는 것을 나타냅니다.
- Key(K): 기존 학생이 달고 있는 이름표 "나는 수학을 안다". 이전 토큰마다 생기며 그 토큰이 가진 정보의 종류를 설명합니다.
- Value(V): 학생이 가진 실제 노트. 이름표로 사람을 찾은 뒤 실제로 가져다 쓰는 내용이며 그 토큰의 정보 자체입니다.
현재 토큰은 Query를 모든 이전 토큰의 Key와 비교해 어텐션 점수(각 이전 토큰에 얼마나 집중할지를 나타내는 숫자)를 얻고, 점수가 높은 토큰의 Value를 모읍니다.
캐시가 없을 때 모델은 매 스텝에서 시퀀스 전체 토큰의 Key, Value, Query를 다시 계산합니다.
| 스텝 | 입력 | 계산하는 토큰 | 중복 계산 |
|---|---|---|---|
| 1 | I love |
I, love | 없음 |
| 2 | I love teaching |
I, love, teaching | I, love (스텝 1에서 이미 계산) |
| 3 | I love teaching AI |
I, love, teaching, AI | I, love, teaching |
표 10.3.1 — 스텝이 진행될수록 이미 계산한 토큰의 Key·Value를 다시 계산하는 양이 늘어납니다.
I의 Key와 Value는 스텝 1에서 구했는데 스텝 2와 3에서 또 구합니다. 이미 100토큰을 생성했다면 다음 토큰 하나를 예측하려고 앞의 100토큰의 Key·Value를 전부 다시 계산합니다. 시퀀스가 길수록 낭비가 커지므로 텍스트 생성이 크게 느려집니다.
캐시를 쓰면 스텝 1에서 I와 love의 Key·Value를 계산해 캐시에 저장하고, 스텝 2에서는 teaching만 입력으로 넣어 I와 love는 캐시에서 꺼내고, 스텝 3에서는 AI만 계산합니다. 회의 중에 새 발언자가 말할 때마다 이전 발언자에게 다시 말해 달라고 하는 대신 내 메모를 읽고 새 발언만 듣는 것과 같습니다.
고객의 챗봇이 대화가 길어질수록 응답이 느려진다고 하면, 서버가 캐시를 쓰고 있는지부터 확인합니다.
10.3.2 Key·Value만 캐시하고 Query는 캐시하지 않는 이유
저장 대상이 K와 V뿐인 이유는 각 값이 쓰이는 시점이 다르기 때문입니다. Query는 지금 생성 중인 현재 토큰만 쓰고, 예측이 끝나면 더 쓰이지 않습니다. 반면 과거 토큰의 Key와 Value는 앞으로 올 모든 스텝에서 필요합니다. 새 토큰마다 이전 토큰을 전부 봐야 하기 때문이며, 이름이 KV 캐시인 이유도 여기에 있습니다.
- 새 토큰에 대한 계산은 남습니다: 캐시를 써도 모델은 새 토큰의 Key, Value, Query를 계산합니다. 건너뛰는 것은 이전 토큰의 계산이고, 새 토큰의 Key·Value는 다음 스텝을 위해 캐시에 저장합니다.
- 불변성: 과거 토큰의 Key·Value는 이후 토큰에 영향을 받지 않아 변하지 않으므로 안전하게 재사용됩니다(10.2.5 참조).
- 요청 간 재사용: 같은 시작 텍스트를 가진 여러 요청 사이에서 캐시를 재사용하는 확장이 프롬프트 캐싱이며, "한 번 계산해 다시 쓴다"는 같은 발상 위에 있습니다(4.6 참조).
Query를 저장하자는 제안이 나오면 이유를 한 문장으로 답할 수 있어야 합니다. Query는 한 번 쓰고 나면 다시 읽히지 않으므로 저장해도 얻는 것이 없고 메모리만 쓴다는 것입니다.
10.3.3 속도 향상 정도
캐시가 없을 때와 있을 때의 계산량을 나란히 놓으면 차이가 분명합니다. 처음 입력이 2토큰일 때 시퀀스를 100토큰까지 만드는 경우를 가정합니다.
| 스텝 | 캐시 없음(계산하는 토큰 수) | 캐시 있음(계산하는 토큰 수) |
|---|---|---|
| 1 | 2 | 2 (K, V 저장) |
| 2 | 3 (2개 중복) | 1 (캐시 2개 재사용) |
| 3 | 4 (3개 중복) | 1 (캐시 3개 재사용) |
| ... | ... | ... |
| N | N+1 (N개 중복) | 1 (캐시 N개 재사용) |
표 10.3.2 — 캐시가 있으면 첫 스텝 이후 매 스텝이 새 토큰 하나만 계산합니다.
원문은 100토큰 생성에서 캐시 없이 2 + 3 + 4 + ... + 100 = 5,049회의 Key·Value 계산이 들고, 캐시를 쓰면 2 + 1 + 1 + ... + 1회가 든다고 계산해 "약 50배 적다"고 결론짓습니다. 재계산하면 5,049는 맞고, 캐시 쪽은 2 + 98 = 100회이므로 비율은 약 50.5배입니다(원문은 101로 적었으며 비율의 결론인 약 50배는 같습니다). 시퀀스가 1,000토큰이면 캐시 없이 2 + 3 + ... + 1,000 = 500,499회, 캐시를 쓰면 2 + 998 = 1,000회여서 약 500배 차이가 납니다. 이 절의 비율 계산은 모두 python3 -I로 검증했습니다.
이 차이가 생기는 이유는 캐시 없는 쪽의 총 계산이 길이의 제곱에 비례해 커지고, 캐시 있는 쪽은 길이에 비례해 커지기 때문입니다. 시퀀스가 길수록 절약도 커지므로 캐시는 선택 기능이 아니라 현대 서빙의 기본값입니다. 고객이 긴 출력을 요구할수록 캐시가 꺼진 구성은 성립하지 않는다는 점을 짚어 줍니다.
10.3.4 속도 vs 메모리 트레이드오프
캐시는 생성을 빠르게 하는 대신 지금까지 생성한 모든 토큰의 Key와 Value를 저장할 메모리를 추가로 씁니다. 시퀀스가 수천 토큰으로 길어지면 캐시가 상당한 메모리를 차지합니다. 한마디로 더 많은 메모리로 계산 시간을 산다는 거래이며, 대부분의 용도에서 속도 이득이 커서 남는 거래입니다.
문제는 여러 사용자를 동시에 서빙할 때입니다. 캐시를 메모리에 어떻게 두는지가 동시 사용자 수를 정하게 되고, 이를 푸는 대표 기법이 페이지드 어텐션입니다(10.4 참조). 엔진 수준에서 이를 통합한 사례가 vLLM입니다(10.12 참조). 완전한 해결은 아니므로 캐시 크기를 줄이는 선택지를 구분해 둡니다.
- 끝나지 않는 대화의 고정 크기 유지: 최근 토큰 창과 처음 몇 개의 어텐션 싱크(attention sink)만 남기고 나머지를 버려 캐시를 일정 크기로 유지하는 방법이 흔합니다. 이는 KV 캐시 압축 기법 중 하나이며, 다른 기법들은 토큰을 하나도 버리지 않고 메모리를 줄입니다(10.1.1 참조).
- 페이지드 어텐션과의 구분: 페이지드 어텐션은 캐시 주변 메모리가 낭비되는 것을 막을 뿐 캐시 자체를 작게 만들지 않습니다. 캐시를 줄이는 일은 압축의 역할입니다.
- 속도와 메모리를 함께 보는 질문: 캐시는 계산 시간을 줄이지만 메모리 문제를 해결하지는 않습니다.
현장에서는 GPU 메모리 한도 안에서 동시 사용자 수와 컨텍스트 길이를 정할 때 이 거래를 근거로 삼습니다. 긴 컨텍스트와 많은 동시 사용자를 함께 요구하는 고객에게는 둘을 곱한 만큼 캐시가 자란다는 점과, 선택지가 압축·페이지드 방식·장비 증설이라는 점을 함께 제시합니다.
10.4 페이지드 어텐션(Paged Attention)
원문: What is Paged Attention in LLMs?
KV 캐시가 계산을 아끼는 대신 메모리를 먹는다면(10.3 참조), 그 메모리를 어떻게 나눠 주느냐가 동시에 받을 수 있는 사용자 수를 정합니다. 2026년 3월 29일 게시된 이 글은 운영체제의 메모리 관리 방식을 빌려 KV 캐시의 낭비를 없애는 방법을 설명합니다.
**페이지드 어텐션(Paged Attention)**은 KV 캐시 메모리를 페이지라 부르는 작고 크기가 고정된 블록으로 쪼개 관리하는 기법입니다. 블록들은 메모리에서 서로 붙어 있을 필요가 없습니다. 낭비가 사라지므로 LLM이 같은 시간에 훨씬 많은 사용자를 받을 수 있습니다.
10.4.1 KV 캐시 메모리 낭비 문제
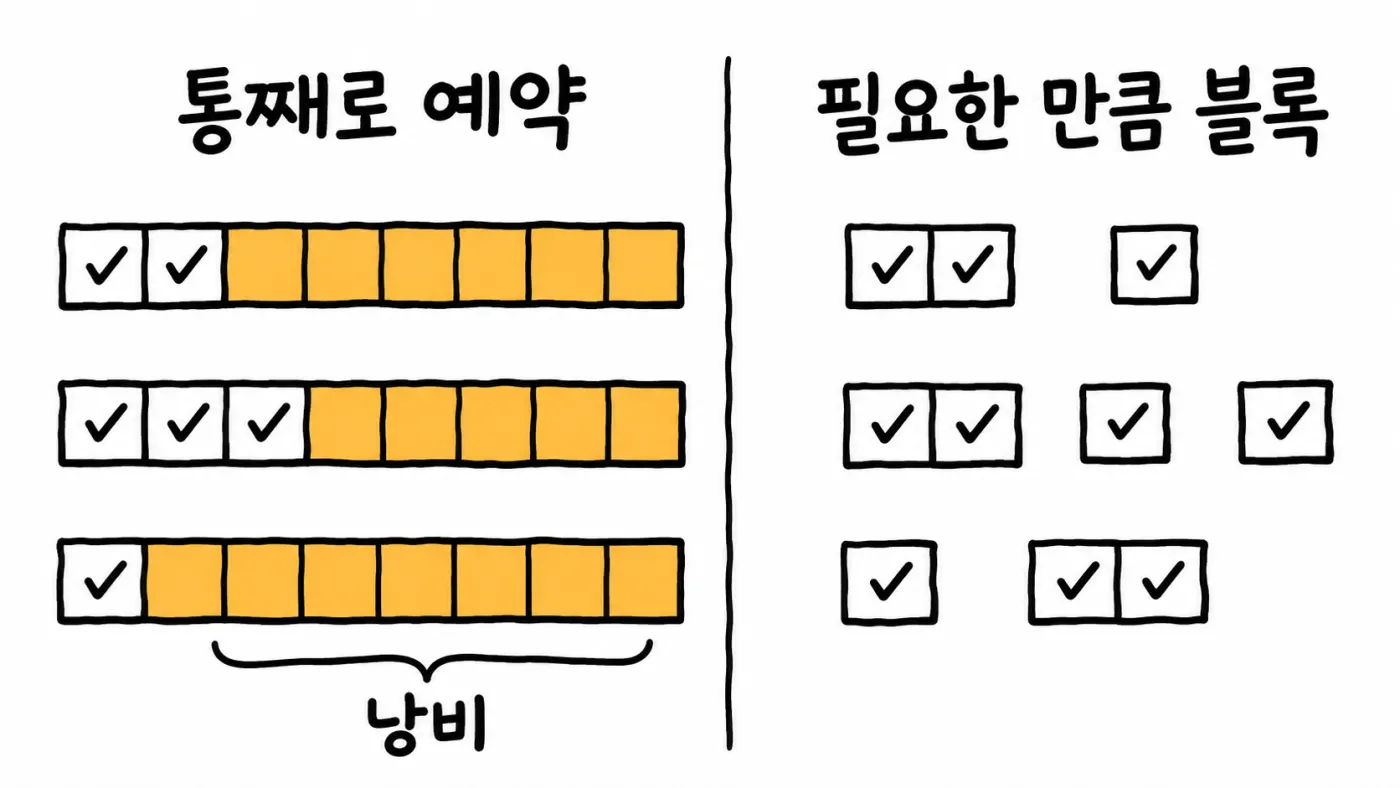
문제의 뿌리는 시스템이 답이 얼마나 길어질지 미리 모른다는 사실입니다. 사용자는 20토큰으로 끝나는 단순한 질문을 할 수도 있고 2,000토큰짜리 답을 부르는 복잡한 질문을 할 수도 있습니다. 전통적인 방식은 요청마다 슬롯이 서로 붙어 있는 큰 메모리 덩어리 하나를 최대 응답 길이만큼 예약합니다. 2,048토큰을 예약했는데 실제 답이 50토큰이면 1,998토큰 분량(약 97.6퍼센트)이 비어 있는 채로 다른 요청에 쓰이지 못합니다.
호텔에 비유하면 이해가 쉽습니다. 투숙객이 며칠 머물지 모르니 호텔은 한 층에 이어진 방 30개를 통째로 잡아 둡니다. 2박만 하고 떠나도 30개가 모두 예약된 상태이고, 10명이 체크인하면 30 × 10 = 300개 방이 예약되지만 대부분의 손님이 며칠만 묵으면 수백 개 방이 빈 채로 낭비됩니다.
낭비는 두 가지 모양으로 나타납니다.
- 내부 낭비(internal waste): 예약했지만 쓰지 않은 메모리입니다. 2,048토큰을 예약하고 50토큰만 생성하면 나머지 1,998토큰 분량이 여기에 해당합니다.
- 외부 낭비(external waste): 한 덩어리로 붙은 공간을 요구하므로, 흩어진 작은 빈 공간들은 합치면 새 요청을 받을 만큼이어도 쓰지 못하는 낭비입니다.
예약된 메모리의 상당 부분이 실제로 쓰이지 않으므로 같은 GPU에서 동시에 받는 사용자 수가 줄어듭니다. 영상(10.1의 영상 자막)의 화자는 같은 현상을 이렇게 설명합니다. 시스템은 필요한 만큼이 아니라 10MB 같은 블록 단위로만 메모리를 내줍니다. 2MB짜리 캐시에 10MB 블록을 받으면 8MB가, 4MB에는 6MB가, 8MB에는 2MB가 낭비되며, 이 세 건을 합치면 30MB 중 16MB(약 53퍼센트)가 버려집니다. 화자는 전체적으로 70~80퍼센트가 낭비된다고 말하지만 이 예의 계산은 약 53퍼센트이므로, 수치는 워크로드에 따라 달라지는 예시로만 받아들입니다.
고객이 GPU를 늘려 달라고 요청하기 전에 현재 서빙 엔진이 요청마다 최대 길이를 예약하는 방식인지부터 확인하면 증설 없이 동시 사용자 수를 늘릴 여지가 보이는 경우가 있습니다.
10.4.2 블록 테이블(Block Table)
이름의 페이지드는 운영체제에서 왔습니다. 운영체제는 프로그램마다 큰 연속 메모리를 주는 대신 메모리를 작고 크기가 같은 페이지로 나누고, 필요한 만큼의 페이지를 메모리 어디에나 흩어서 줍니다. 각 페이지의 실제 위치는 페이지 테이블이라는 대응 목록이 기록합니다. 페이지드 어텐션은 같은 발상을 KV 캐시에 적용하며, 호텔로는 필요할 때 방을 하나씩 내주고 어느 방이 어느 손님 것인지 적어 두는 방식에 해당합니다. 2박이면 방 2개만 쓰고 나머지는 다른 손님에게 돌아갑니다.
블록 하나는 정해진 수의 토큰에 대한 Key·Value를 담습니다. 블록 크기가 4이면 한 블록이 4토큰을 담고, 원문은 실제로는 보통 16토큰 크기를 쓴다고 소개합니다(10.2.6 참조). 생성 문장 "I love teaching AI and Machine Learning at Night School"(10토큰)로 비교합니다.
| 방식 | 할당 | 사용 | 낭비 |
|---|---|---|---|
| 전통 방식 | 연속 16슬롯을 미리 예약 | 10슬롯 | 6슬롯(37.5퍼센트) |
| 페이지드(블록 크기 4) | 블록 1(I, love, teaching, AI) → 블록 2(and, Machine, Learning, at) → 블록 3(Outcome, School, 빈칸 2) | 10슬롯 | 2슬롯(12슬롯 중 약 16.7퍼센트) |
표 10.4.1 — 블록은 이전 블록이 차면 그때 하나씩 추가되며, 낭비는 마지막 블록의 빈칸으로만 남습니다.
블록이 흩어져 있으면 모델이 어떻게 찾을까요? 시스템이 요청별로 블록 테이블을 유지하며, 순서대로 번호가 붙은 논리 블록이 실제 메모리 위치를 가리킵니다.
flowchart LR
    subgraph T["요청 1의 블록 테이블"]
      B0["논리 블록 0"]
      B1["논리 블록 1"]
      B2["논리 블록 2"]
    end
    B0 --> L5["물리 위치 5"]
    B1 --> L12["물리 위치 12"]
    B2 --> L3["물리 위치 3"]
그림 10.4.2 — 논리 블록은 순서대로 늘어서고 물리 위치는 흩어져 있어도 됩니다.
모델은 이전 토큰의 Key·Value가 필요할 때 이 테이블을 따라 해당 블록을 찾으므로 어느 과거 토큰에도 접근할 수 있습니다. 이 구조는 영상 화자의 비유로는 물리 메모리 위에 얹은 장부이고, 10MB 덩어리를 2MB 블록 다섯 개처럼 쓰게 해 줍니다. 낭비가 0이 되지는 않지만 70~80퍼센트에서 10~20퍼센트 수준으로 내려간다고 화자는 설명합니다. 이 수치도 강연의 예시이며, 낭비가 마지막 블록에만 남는다는 구조는 글의 설명과 일치합니다.
블록이 작을수록 마지막 블록에서 비는 칸이 줄어드는 것은 위 계산에서 직접 확인됩니다. 4토큰 블록이면 마지막 블록의 빈칸은 최대 3칸입니다.
10.4.3 요청 간 메모리 공유
페이지드 어텐션의 부수적인 이득이 메모리 공유입니다. 두 사용자가 같은 질문을 보내면 입력 토큰이 같고, 같은 토큰의 Key·Value도 같으므로 두 요청이 같은 블록을 가리키게 하면 됩니다. 사본 두 개를 저장하는 대신 하나만 저장하고 양쪽 블록 테이블이 같은 블록을 가리킵니다. 같은 접두를 가진 요청들이 물리 블록을 함께 쓰는 구조이므로, 프롬프트 캐싱과 prefix caching의 블록 공유 기반이 됩니다(4.6 참조).
- 병렬 샘플링(parallel sampling): 같은 질문에 서로 다른 답을 여러 개 만들어 가장 좋은 것을 고르는 경우입니다. 질문 부분은 모든 답에서 같으므로 입력 블록을 모든 답이 공유합니다. 예컨대 1,000토큰 입력에 답을 8개 뽑으면 입력 캐시를 8벌이 아니라 1벌만 저장합니다(공유 효과를 보이기 위한 가정 예시).
- 빔 서치(beam search): 모델이 여러 후보 완성을 동시에 탐색해 가장 좋은 것을 고르는 경우입니다. 공유되는 입력은 한 번만 저장하고 모든 병렬 시퀀스가 재사용합니다.
공유가 일어나려면 앞부분이 같아야 하므로, 이 발상을 더 정교하게 밀고 간 것이 공유 텍스트를 기수 트리(radix tree)로 정리해 공통 접두를 더 정확히 맞추는 SGLang입니다(10.13 참조).
고객이 한 질문에 후보 답변을 여러 개 만들어 고르는 구조(예: 같은 계약서에 대해 여러 초안 생성)를 쓴다면, 공유가 켜져 있는 엔진인지에 따라 메모리 비용이 크게 달라집니다.
10.4.4 효과
페이지드 어텐션은 두 낭비를 각각 해결합니다.
- 내부 낭비가 거의 사라집니다: 메모리를 블록 단위로 필요할 때만 할당하므로 낭비는 마지막 블록의 빈칸으로 한정됩니다. 위 예에서 마지막 블록의 4칸 중 2칸이 낭비였고, 전통 방식은 16칸 중 6칸이었습니다.
- 외부 낭비가 사라집니다: 블록이 붙어 있을 필요가 없으므로 메모리 어디의 빈 블록이든 쓸 수 있고, 쓰지 못하는 틈이 없습니다.
결과적으로 같은 메모리로 훨씬 많은 요청을 동시에 처리할 수 있고, 더 큰 배치를 만들 수 있어 처리량이 오릅니다(10.2.6 참조). 다만 한계를 분명히 해야 합니다.
- 캐시를 작게 만들지는 않습니다: 페이지드 어텐션은 캐시 주변 메모리가 낭비되는 것을 막을 뿐이고, 캐시 자체를 줄이는 일은 KV 캐시 압축의 역할입니다(10.1.1 참조).
- 낭비가 완전히 0은 아닙니다: 마지막 블록은 항상 가득 차지는 않으므로 소량이 남습니다.
- vLLM과 같은 말이 아닙니다: 페이지드 어텐션은 기법이고, vLLM은 이 기법을 핵심 아이디어로 삼은 처리량 높은 서빙 엔진입니다(10.12 참조). NVIDIA의 TensorRT-LLM에서는 같은 블록 기반 발상이 paged KV cache라는 이름으로 나타납니다(10.14 참조).
- 연속 배칭과 짝을 이룹니다: 연속 배칭은 이전 요청이 끝나는 순간 새 요청을 배치에 넣어 GPU를 바쁘게 유지하고, 페이지드 어텐션은 그 추가 요청이 들어갈 메모리 자리를 만들어 줍니다. 앞의 것이 연산 낭비를, 뒤의 것이 메모리 낭비를 푸는 역할 분담입니다(10.5 참조).
동시 사용자가 늘었을 때 메모리 부족이 먼저 오는 고객이라면 페이지드 어텐션을 쓰는 엔진인지가 첫 확인 사항이며, 그래도 모자라면 캐시 압축이나 양자화 같은 별도 수단을 검토합니다.
10.5 연속 배칭(Continuous Batching)
원문: What is Continuous Batching in LLMs?
서빙 서버의 비용은 GPU가 얼마나 쉬지 않고 쓸모 있는 일을 하느냐로 정해집니다. 2026년 5월 11일 게시된 이 글은 요청 묶음을 만드는 방식 하나를 바꿔 같은 장비로 더 많은 사용자를 받는 방법을 수치로 보여 줍니다.
**배칭(batching)**은 여러 사용자의 요청을 묶어 GPU에서 함께 돌리는 일입니다. GPU는 같은 종류의 일을 많은 데이터에 동시에 하는 데 강하므로 요청 하나만 주면 연산 능력 대부분이 놉니다. 8명의 요청을 한 배치로 돌리면 1명일 때와 거의 같은 시간에 8명분을 처리하므로, 한 GPU가 각 사용자를 크게 기다리게 하지 않고 여러 명을 받습니다. 문제는 그 묶음을 언제 시작하고 언제 끝내느냐이며, 이 규칙이 정적 배칭과 연속 배칭을 가릅니다. 배경이 되는 추론 구조는 이렇습니다. 응답은 큰 작업 하나가 아니라 토큰당 한 스텝, 수백 번의 작은 스텝이며 Prefill은 요청마다 처음 한 번, Decode는 응답이 200토큰이면 200스텝입니다. 각 요청은 자기 KV 캐시를 가집니다(10.2, 10.3 참조).
10.5.1 정적 배칭(Static Batching)의 문제
정적 배칭은 서버가 고정된 요청 묶음을 모아 함께 돌리고, 전부 끝난 뒤에야 새 배치를 시작하는 방식입니다. 절차는 단순합니다. 요청 4개를 모아 Prefill을 함께 하고, Decode 스텝마다 4개 요청에 토큰을 하나씩 만들며, 4개가 모두 끝날 때까지 이어간 뒤 새 배치를 시작합니다. 만들기 쉽다는 장점이 있지만 요청들이 끝나는 시간이 크게 다르다는 점에서 심각한 문제가 생깁니다.
- 짧은 요청의 슬롯이 놂: "2 + 2는?"처럼 몇 토큰이면 끝나는 요청은 5스텝 만에 끝나는데, 같은 배치의 "기후 변화에 대한 긴 에세이" 요청이 1,000토큰이면 배치는 수백 스텝을 더 돕니다. 끝난 요청이 쓰던 슬롯은 빈 채로 남고, GPU는 그 빈 슬롯에 대해서도 연산을 수행하지만 아무 쓸모가 없습니다.
- GPU는 바쁜데 일은 낭비: 배치 수명의 대부분 동안 실제로 일하는 슬롯은 일부뿐입니다.
- 새 사용자가 기다림: 중간에 도착한 사용자는 현재 배치가 모두 끝날 때까지 시작조차 못 합니다.
연속 배칭이 필요한 이유가 여기에 있습니다. 고객이 "GPU 사용률은 높은데 처리량이 안 나온다"고 하면, 정적 배칭에서 슬롯이 빈 채 돌고 있는지, 응답 길이 편차가 큰 업무인지를 함께 봅니다.
10.5.2 연속 배칭 단계별 동작
연속 배칭은 배치 전체가 끝나기를 기다리지 않고, 배치 안의 요청 하나가 끝나는 순간 대기열의 새 요청으로 즉시 바꿔 넣는 방식입니다. 배치를 "함께 시작하고 함께 끝나는 요청 묶음"이 아니라 "언제나 누군가 들어 있는 슬롯 묶음"으로 보는 관점 전환입니다. 핵심 차이는 한 줄로 외울 수 있습니다. 정적 배칭은 요청 단위로, 연속 배칭은 토큰 단위로 일합니다. 연속 배칭에서 작업 단위는 "지금 배치에 있는 모든 이에 대한 Decode 한 스텝"이며, 매 스텝 뒤에 끝난 요청이 있는지, 새로 도착한 요청이 있는지를 확인합니다.
슬롯이 4개인 서버가 요청을 처리하는 절차는 여섯 단계입니다.
- 배치에는 고정된 수의 슬롯이 있습니다(여기서는 4개).
- 요청이 대기열에 도착하고, 빈 슬롯이 있는 한 다음 요청을 꺼내 슬롯에 넣고 그 요청의 Prefill로 상태를 준비합니다.
- 현재 배치의 모든 요청에 대해 Decode 스텝을 하나 돌려 각각 새 토큰 하나를 얻습니다.
- 스텝 뒤에 각 요청을 점검합니다. 모델이 정지 토큰을 내거나 최대 길이에 닿으면 끝난 것이며(2.13 참조), 슬롯에서 빼고 결과를 사용자에게 보냅니다.
- 대기열을 봅니다. 기다리는 요청이 있으면 방금 빈 슬롯에 넣고 Prefill을 돌립니다.
- 다음 Decode 스텝을 돌리고 4단계부터 반복합니다.
flowchart TD
    Q["대기열: 새 요청 도착"] -->|슬롯이 비면 꺼냄| B["배치 (슬롯 4개)"]
    B --> D["Decode 스텝: 슬롯마다 토큰 1개"]
    D --> C{"슬롯 점검"}
    C -->|끝남| R["제거하고 결과 전송"]
    C -->|비어 있음| Q
    R --> Q
    C -->|계속 진행| D
그림 10.5.1 — 매 Decode 스텝마다 완료와 도착을 확인하는 루프가 배치를 항상 가득 채웁니다.
비유는 4인승 합승 택시입니다. 정적 배칭은 4명이 타고 모두 목적지에 닿을 때까지 기다리는 택시여서 5분 만에 내린 승객의 좌석이 여정이 끝날 때까지 비고, 길에서 기다리는 손님은 택시가 돌아올 때까지 탈 수 없습니다. 연속 배칭은 승객이 내리는 즉시 길에서 기다리던 승객이 그 좌석에 탑니다. 좌석이 GPU 슬롯, 승객이 요청, 승객이 차에 머문 시간이 요청이 만드는 토큰 수입니다. 값비싼 자원이 좌석이므로 좌석을 비우지 않는 택시가 하루에 더 많은 승객을 태웁니다.
10.5.3 수치 예제와 속도 향상
슬롯 4개에 요청 A(100스텝), B(20), C(50), D(200)가 들어오고, 직후 요청 E(30스텝)가 도착합니다. Decode 스텝 하나는 GPU에서 50ms라고 가정합니다.
| 스텝 | 정적 배칭(슬롯 1~4 / 대기열) | 연속 배칭(슬롯 1~4 / 대기열) |
|---|---|---|
| 0 | A, B, C, D / E | A, B, C, D / E |
| 20 | A, 빈칸, C, D / E (B 끝) | A, E, C, D / 없음 (B 끝, E 즉시 투입) |
| 50 | A, 빈칸, 빈칸, D / E | A, 빈칸, 빈칸, D / 없음 (E와 C 끝) |
| 100 | 빈칸 3개, D / E | 빈칸 3개, D / 없음 (A 끝) |
| 200 | 전부 빈칸 / E (D 끝, 배치 종료) | 전부 빈칸 (D 끝) |
표 10.5.1 — 정적 배칭에서 E는 스텝 200이 지나서야 슬롯을 얻습니다. 연속 배칭 쪽에서 뒤에 빈칸이 생기는 것은 대기열이 비었기 때문입니다.
시간으로 환산하면 정적 배칭은 1라운드(A~D)가 200 × 50ms = 10.0초, 2라운드(E 혼자)가 30 × 50ms = 1.5초여서 5개 요청을 모두 끝내는 데 11.5초가 걸립니다. 연속 배칭은 E가 스텝 20에 들어가 50에 끝나고 D가 스텝 200에 끝나 총 10.0초입니다. 총 생성 토큰은 100 + 20 + 50 + 200 + 30 = 400개로 같습니다. 사용자가 체감하는 요청별 응답 시간은 다음과 같습니다.
| 요청 | 정적 배칭 | 연속 배칭 |
|---|---|---|
| A (100토큰) | 5.0초 | 5.0초 |
| B (20) | 1.0초 | 1.0초 |
| C (50) | 2.5초 | 2.5초 |
| D (200) | 10.0초 | 10.0초 |
| E (30) | 11.5초 | 2.5초 (약 4.6배 빠름) |
| 평균 | 6.0초 | 4.2초 |
표 10.5.2 — 이득은 뒤늦게 도착한 짧은 요청 E에 집중됩니다. 앞서 시작한 요청의 시간은 그대로입니다.
E는 이전 배치가 끝나기를 10초 기다린 뒤 시작하는 대신 바로 투입되어 11.5 ÷ 2.5 = 4.6배 빨라집니다. 평균은 (5 + 1 + 2.5 + 10 + 11.5) ÷ 5 = 6.0초에서 (5 + 1 + 2.5 + 10 + 2.5) ÷ 5 = 4.2초로 내려갑니다.
더 현실적인 부하로 처리량을 비교합니다. 100개 요청이 도착하는데 20토큰짜리 짧은 요청 50개와 200토큰짜리 긴 요청 50개이며, 생성해야 할 총 토큰은 50 × 20 + 50 × 200 = 11,000개입니다. 처리량은 서버가 초당 만드는 토큰 수입니다.
- 정적 배칭: 배치 4개마다 평균 짧은 요청 2개와 긴 요청 2개가 섞이고 가장 긴 것이 끝날 때까지 200스텝을 돕니다. 배치 수는 100 ÷ 4 = 25개, 배치당 200 × 50ms = 10초, 총 25 × 10 = 250초이므로 처리량은 11,000 ÷ 250 = 44토큰/초입니다.
- 연속 배칭: 대기열이 슬롯을 계속 채우므로 스텝마다 슬롯 4개에서 토큰 4개가 나옵니다. 필요한 스텝은 11,000 ÷ 4 = 2,750개, 총 2,750 × 50ms = 137.5초이므로 처리량은 11,000 ÷ 137.5 = 80토큰/초입니다.
- 차이: 80 ÷ 44 약 1.8배이고 250 − 137.5 = 112.5초, 즉 같은 일에 45퍼센트 적은 시간이 듭니다.
이 값은 python3로 재계산해 원문과 일치함을 확인했습니다. 정적 배칭의 44토큰/초가 연속 배칭의 80토큰/초 대비 55퍼센트라는 것은, 배치마다 짧은 요청 2개(20스텝)와 긴 요청 2개(200스텝)에서 실제 일한 슬롯 스텝이 2 × 20 + 2 × 200 = 440이고 전체가 4 × 200 = 800이라 440 ÷ 800 = 55퍼센트인 것과 같은 수치입니다. 즉 정적 배칭에서 슬롯의 약 45퍼센트가 빈 채로 돈 것입니다.
실제 워크로드에서의 속도 향상은 보통 2배에서 4배입니다. 폭을 좌우하는 조건은 세 가지입니다.
- 요청 길이의 편차: 편차가 클수록 이득이 큽니다.
- 트래픽의 꾸준함: 도착이 꾸준할수록 이득이 큽니다.
- 모델과 하드웨어.
원문은 vLLM에서 발표된 벤치마크로 연속 배칭과 페이지드 어텐션을 함께 쓰면 단순한 서빙 대비 20배 넘는 처리량, 같은 GPU의 정적 배칭 대비 2~4배를 낼 수 있다고 소개합니다(2026년 5월 글 기준). 이득은 처리량 증가, 대기 시간 감소, 가장 비싼 부품인 GPU 활용도 개선의 세 가지입니다. vLLM, SGLang, TensorRT-LLM을 포함한 거의 모든 현대 서빙 시스템이 연속 배칭을 사용합니다(10.12, 10.13, 10.14 참조).
고객에게 속도 향상을 약속할 때는 2~4배라는 범위를 그대로 쓰되, 응답 길이 분포가 균일하고 트래픽이 드문 업무라면 이득이 작다는 조건을 함께 말합니다.
10.5.4 유의 사항
연속 배칭을 도입할 때 알아야 할 한계와 오해가 있습니다.
- 모델은 그대로입니다: 연속 배칭은 모델, 어텐션 방식, 토큰 생성 방식, 출력 내용을 바꾸지 않고 서버가 GPU에서 요청을 배치하는 방식만 바꿉니다. 각 사용자의 출력은 요청을 혼자 돌린 것과 같습니다.
- 페이지드 어텐션과 짝입니다: 페이지드 어텐션은 KV 캐시의 메모리 낭비를, 연속 배칭은 정적 배칭의 연산 낭비를 해결합니다. 둘이 합쳐져 한 GPU가 많은 사용자를 받는 이유가 됩니다(10.4 참조).
- 배치 크기는 무제한이 아닙니다: GPU 메모리가 한정되고 배치 안의 요청마다 KV 캐시 메모리를 쓰므로 서버는 메모리에 맞는 배치 크기를 고르고, 배치가 가득 차면 새 요청은 대기열에서 슬롯이 열리기를 기다립니다. 요청마다 캐시를 줄이는 KV 캐시 압축은 같은 메모리에 더 많은 요청을 넣는 방법의 하나입니다(10.1.1 참조).
- 긴 프롬프트가 다른 사용자를 멈출 수 있습니다: 새 요청의 Prefill이 다른 모든 사용자의 Decode와 같은 GPU에서 돌므로, 아주 긴 프롬프트가 들어오면 그 Prefill이 잠시 다른 사용자의 Decode를 멈춥니다. 아주 큰 규모에서는 Prefill-Decode 분리가 두 단계를 서로 다른 GPU에서 돌려 이를 없앱니다(10.7 참조).
- 예시 수치는 단순화되어 있습니다: 새 요청이 합류할 때 드는 작은 Prefill 비용을 0으로 보았고, 정적 배칭의 2 + 2 구성은 평균이며 실제 배치는 이 주변에서 달라집니다. 요청 길이가 다양할 때 연속 배칭이 몇 배 앞선다는 정성적 패턴은 유지됩니다.
고객이 질문했을 때 판단 기준은 이렇게 압축됩니다. 출력 품질은 바뀌지 않으므로 도입 위험은 품질이 아니라 메모리 한도와 긴 프롬프트가 만드는 끊김에 있고, 후자는 chunked prefill이나 분리 서빙으로 완화합니다(10.2.6 참조).
10.6 투기적 디코딩(Speculative Decoding)
원문: What is Speculative Decoding?
디코딩은 GPU의 연산 능력이 놀고 있는데도 토큰을 하나씩 만들 수밖에 없다는 점이 느린 이유입니다. 2026년 5월 6일 게시된 이 글은 그 놀고 있는 연산 능력을 이용해, 모델과 출력 품질을 바꾸지 않고 약 2~3배 빠르게 만드는 방법을 설명합니다.
**투기적 디코딩(Speculative Decoding)**은 작고 빠른 모델이 다음 몇 토큰을 먼저 추측(초안)하고, 크고 느린 모델이 그 추측 전체를 한 번의 실행으로 검증하는 기법입니다. 한 줄 공식은 "작은 모델이 토큰을 초안으로 쓰고 큰 모델이 병렬로 검증한다"이며, 초안이 좋으면 큰 모델 한 스텝 값으로 여러 토큰을 얻고, 나쁘면 틀린 토큰을 버리고 초안이 맞았던 지점부터 이어갑니다. 출력은 큰 모델 혼자 썼을 때와 정확히 같습니다.
10.6.1 생성이 느린 이유
ChatGPT, Claude, Gemini 같은 서비스는 한 단어씩 씁니다. LLM은 자기회귀 방식으로 토큰 하나를 만들고 그 토큰을 입력으로 받아 다음 토큰을 만들기 때문입니다(2.3 참조).
스텝 1: 입력 "I"               -> 출력 "love"
스텝 2: 입력 "I love"          -> 출력 "teaching"
스텝 3: 입력 "I love teaching" -> 출력 "AI"
토큰마다 큰 모델 전체가 한 번씩 실행됩니다. 파라미터가 700억 개인 모델이라면 토큰 하나를 만들 때마다 700억 개 파라미터를 GPU 메모리에서 읽습니다. 모델이 클수록 느려지는 구조입니다.
- 느린 것은 계산이 아니라 메모리 이동입니다: 토큰 하나를 만드는 시간 대부분은 모델 가중치를 연산 장치로 불러오는 데 쓰이고, 실제 수학 계산은 일부입니다.
- 놀고 있는 연산 능력: 메모리를 기다리는 동안 GPU의 연산 능력이 쓰이지 않은 채 남습니다.
- 비용의 비대칭: 토큰마다 메모리 비용은 전부 내면서 연산은 거의 쓰지 않습니다. 이 틈이 투기적 디코딩이 파고드는 자리입니다.
이는 Decode가 메모리 대역폭 병목이라는 사실과 같은 이야기입니다(10.2.3 참조). 고객이 더 큰 모델로 바꾸자마자 응답 속도가 떨어졌다고 하면, 토큰당 읽는 가중치가 늘어난 것이 원인이며 GPU를 늘리기 전에 이 기법의 적용 가능성을 따져 봅니다.
10.6.2 초안 생성과 검증 아이디어
두 모델이 역할을 나눕니다.
- 초안 모델(draft model): 빠른 작은 모델로, 예를 들어 파라미터 10억 개입니다.
- 대상 모델(target model): 똑똑한 큰 모델로, 예를 들어 700억 개입니다.
계획은 네 줄입니다. 초안 모델이 다음 4~5토큰을 연달아 빠르게 쓰고, 대상 모델이 그 초안 토큰들을 한꺼번에 받아 한 번의 순전파로 검사합니다. 토큰마다 "나도 이렇게 썼을 것이다"인지 "틀렸다"인지를 판정하고, 받아들인 토큰은 유지하고 나머지는 버린 뒤 거기서부터 이어갑니다. 대상 모델이 4~5토큰을 한 번에 확인하는 것은 놀고 있던 연산 능력을 쓰는 일이며, 가중치를 불러오는 메모리 비용은 한 번만 내고 토큰은 여러 개를 얻습니다.
비유는 꼼꼼하지만 느린 선임 엔지니어와 빠르지만 가끔 틀리는 주니어입니다. 선임이 모든 줄을 직접 쓰는 대신, 주니어가 5줄 초안을 쓰면 선임이 5줄을 함께 읽고 맞는 줄을 승인하고 처음 틀린 줄을 고친 뒤 이어 쓰므로, 선임은 한 줄씩 쓰는 대신 묶음을 검토합니다.
생성은 병렬화할 수 없지만 검증은 병렬화할 수 있다는 비대칭이 성립의 핵심입니다. 영상(10.1의 영상 자막)의 화자는 같은 점을 이렇게 말합니다. I love teaching AI에서 AI는 teaching이 나온 뒤에야 쓸 수 있으므로 생성은 순서를 따르지만, 이미 나온 후보 토큰들이 맞는지는 한꺼번에 확인할 수 있습니다. 토큰마다 검증하면 큰 모델을 매번 돌리는 셈이라 이득이 없으므로 묶음 검증이 요점입니다.
한 라운드를 따라가 봅니다. 프롬프트 I love teaching AI, 초안 길이 4입니다.
| 위치 | 1 | 2 | 3 | 4 |
|---|---|---|---|---|
| 초안 | and | Machine | Learning | today |
| 대상 모델의 예측 | and | Machine | Learning | everyday |
| 판정 | 수락 | 수락 | 수락 | 거절 후 교정 |
표 10.6.1 — 대상 모델은 프롬프트와 초안 4토큰(입력 8개)을 한 번의 병렬 순전파로 처리해 각 위치의 다음 토큰을 예측합니다.
처음 거절이 나오기 전까지의 토큰만 받아들이고, 거절된 토큰은 대상 모델이 고른 토큰으로 바꿉니다. 결과적으로 and Machine Learning everyday 4토큰을 얻고 다음 라운드는 I love teaching AI and Machine Learning everyday에서 시작합니다. 대상 모델은 한 번만 실행되었습니다. 초안 4개가 전부 수락되면 보너스 토큰이 하나 더 붙어 5토큰이 되는데, 대상 모델의 한 번의 순전파가 마지막 초안 토큰 바로 다음 위치의 확률 분포까지 내놓기 때문입니다.
검증 규칙은 거절 샘플링(rejection sampling)입니다. 단순하게는 초안 토큰이 대상 모델이 고를 토큰과 같으면 받아들이면 되지만, LLM은 확률적으로 샘플링하므로(2.11 참조) 최상위 토큰과 같은지만 보는 것으로는 부족합니다. 초안 모델이 이 토큰을 고를 확률을 q(x), 대상 모델이 고를 확률을 p(x)라 하면 규칙은 다음과 같습니다.
p(x) >= q(x)이면 항상 수락합니다.p(x) < q(x)이면 확률p(x) / q(x)로 수락합니다.
Machine은 q = 0.6, p = 0.8이므로 p >= q여서 항상 수락합니다. today는 q = 0.5, p = 0.1이므로 0.1 / 0.5 = 0.2, 즉 20퍼센트만 수락하고 80퍼센트는 거절합니다. 대상 모델이 동의하는 정도가 초안보다 강하면 안전하고, 약하면 대상 모델이 그 토큰을 믿는 만큼의 비율로만 통과시킨다는 직관입니다.
거절되면 포기하지 않고 두 모델의 차이를 메우는 보정 분포에서 새 토큰을 뽑습니다. 보정 분포는 max(0, p(x) - q(x))를 구해 합이 1이 되도록 정규화한 값입니다. 거절 위치의 후보가 세 개이고 확률이 아래와 같다고 하면 다음과 같이 계산됩니다.
| 토큰 | q(x) | p(x) | max(0, p − q) | 보정 확률 |
|---|---|---|---|---|
| everyday | 0.2 | 0.5 | 0.3 | 0.3 ÷ 0.4 = 0.75 |
| today | 0.5 | 0.1 | 0 | 0 |
| tomorrow | 0.3 | 0.4 | 0.1 | 0.1 ÷ 0.4 = 0.25 |
표 10.6.2 — 합계 0.4로 정규화하면 교정 토큰은 everyday 75퍼센트, tomorrow 25퍼센트입니다. 초안이 과하게 선호한 today는 후보에서 빠집니다.
이 규칙은 최종 출력이 대상 모델을 토큰 단위로 혼자 돌렸을 때와 정확히 같은 확률 분포를 갖도록 설계되어 있습니다. 근사가 아니라 수학적으로 정확한 값입니다. 원문은 분량상 증명을 생략했고 증명은 원 논문에 있다고 안내합니다. 이 성질 덕분에 속도를 얻으면서 품질은 잃지 않습니다. 모든 기법이 분포를 건드리지 않는 것은 아니며 일부 기법은 분포를 일부러 약간 옮겨 신호를 숨기는데, 투기적 디코딩은 그렇지 않습니다.
고객이 "작은 모델을 끼우면 답이 달라지지 않느냐"고 물으면, 거절 샘플링이 분포를 보존하며 확인하는 쪽이 항상 큰 모델이라는 점으로 답합니다.
10.6.3 속도 향상 수치
가정은 대상 모델 50ms/토큰, 초안 모델 5ms/토큰, 초안 길이 4입니다. 기준선은 토큰 하나당 대상 모델 한 번이므로 N토큰이 N × 50ms입니다. 투기적 디코딩의 한 라운드 비용은 초안 4 × 5ms = 20ms에 검증 1회 50ms를 더한 70ms로 고정되고, 달라지는 것은 그 라운드에 몇 토큰을 얻느냐입니다.
| 상황 | 라운드당 얻는 토큰 | 기준선 시간 | 투기적 디코딩 | 속도 향상 |
|---|---|---|---|---|
| 최상(4개 모두 수락) | 4 + 보너스 1 = 5 | 5 × 50 = 250ms | 70ms | 약 3.57배 |
| 평균(3개 수락) | 3 + 교정 1 = 4 | 4 × 50 = 200ms | 70ms | 약 2.86배 |
| 최악(0개 수락) | 교정 1 = 1 | 50ms | 70ms | 약 0.71배(더 느림) |
표 10.6.3 — 라운드당 70ms는 같고, 수락 수에 따라 이득이 3.57배에서 0.71배까지 갈립니다. 모두 python3로 재계산했습니다.
최악에서도 첫 초안이 거절되면 보정 분포에서 교체 토큰을 뽑으므로 진전은 0이 아니라 1토큰입니다. 다만 초안 시간이 낭비됩니다. 이 도박의 손익분기는 라운드당 70 ÷ 50 = 1.4토큰입니다. 수락된 초안 수 k에 대해 얻는 토큰이 k + 1이므로 k = 0이면 0.71배, k = 1이면 1.43배, k = 2이면 2.14배, k = 3이면 2.86배, k = 4이면 3.57배가 되어, 초안이 하나라도 맞으면 이득이 시작됩니다(이 k별 표는 원문의 가정으로 직접 계산한 값입니다).
사용자가 느끼는 효과는 200토큰 답으로 계산합니다. 평균 사례(라운드당 4토큰)를 쓰면 기준선은 200 × 50ms = 10,000ms = 10.0초입니다. 투기적 디코딩은 200 ÷ 4 = 50라운드에 50 × 70ms = 3,500ms = 3.5초이므로 6.5초를 아끼며 속도는 약 2.86배입니다. 원문은 실제 워크로드에서 라운드당 토큰 수가 1에서 5까지 어디든 될 수 있고 4는 예시일 뿐이라고 밝힙니다.
실무의 속도 향상은 대부분의 워크로드에서 2~3배입니다. 폭을 좌우하는 조건은 세 가지입니다.
- 초안과 대상의 유사도: 작은 모델이 큰 모델과 비슷하게 행동할수록 수락률이 높아져 이득이 커집니다.
- 초안 길이.
- 입력 스타일: 입력이 초안 모델이 본 스타일과 비슷한 정도입니다.
고객에게 제시하는 약속은 3.57배 같은 최상 수치가 아니라 2~3배의 범위여야 하며, 수락률을 실제 트래픽으로 재 본 뒤에 확정합니다.
10.6.4 사용처와 트레이드오프
투기적 디코딩은 많은 프로덕션 LLM 시스템에서 쓰입니다(2026년 5월 글 기준).
- 서빙 엔진: vLLM, SGLang, TensorRT-LLM이 큰 모델 서빙을 위해 기본 기능으로 지원합니다(10.12, 10.13, 10.14 참조).
- Llama 계열: 작은 Llama와 큰 Llama를 짝지어 추론을 가속하는 경우가 많습니다.
- DeepSeek-V3: 보조 목표인 다중 토큰 예측(Multi-Token Prediction, MTP)으로 모델을 학습시킵니다. 트랜스포머 층 하나와 출력 헤드로 이루어진 가벼운 추가 모듈이 미래 위치의 토큰을 예측하도록 배우고, 추론 시 이 모듈이 내장 초안기 역할을 하므로 별도의 초안 모델이 필요 없습니다. DeepSeek은 이 방식으로 약 1.8배의 생성 속도 향상을 보고합니다.
재훈련 없이 LLM 서빙에서 2~3배 속도를 얻는 가장 값싼 방법이기 때문에 변형이 많습니다. 별도 모델을 없애는 후속 방법도 있습니다.
- Medusa: 큰 모델 자체에 추가 디코딩 헤드를 달아 스스로 초안을 씁니다.
- EAGLE: 잡음이 많은 출력 토큰 대신 모델 내부의 부드러운 피처를 초안으로 씁니다.
- N-gram 추측: 초안 모델이 아예 필요 없습니다. 프롬프트에서 마지막 몇 토큰을 찾아 그 뒤에 온 것을 초안으로 복사하고 큰 모델이 검증하며, 답이 입력을 반복할 때 특히 잘 맞습니다(10.1.3 참조).
대가도 있습니다.
| 제약 | 내용 |
|---|---|
| 모델이 하나 더 필요 | 초안 모델이 GPU 메모리를 더 씀. 아주 큰 배포에서 중요 |
| 같은 토크나이저 | 두 모델의 어휘가 다르면 초안 토큰이 대상 모델이 기대하는 입력과 맞지 않음(2.4 참조) |
| 수락률 의존 | 초안이 대상과 너무 다르면 대부분 거절되어 시간 낭비 |
| 아주 짧은 출력 | 두 모델 운영의 오버헤드가 속도 향상을 상쇄할 수 있음 |
| 초안 길이 조정 | 너무 짧으면 이득이 작고, 너무 길면 거절될 토큰이 낭비됨 |
| 낮은 배치 크기에서 효과적 | 배치가 아주 크면 연속 배칭이 이미 GPU를 바쁘게 해 투기적 디코딩이 쓰는 여유 연산이 없어져 이득이 줄고 경우에 따라 뒤집힘(10.5 참조) |
표 10.6.4 — 투기적 디코딩의 비용과 적용 조건. 요약하면 놀고 있는 연산이 있을 때만 이득이 있습니다.
대부분의 큰 모델 서빙에서는 사용자가 더 빠른 응답을 보고 GPU가 효율적으로 쓰이므로 도입할 가치가 있습니다. 원문 FAQ의 답도 같습니다. 품질은 떨어지지 않지만 속도는 느려질 수 있고(첫 초안이 거절되면 50ms 대신 70ms), 두 모델은 같은 토크나이저를 써야 하며, 별도의 초안 모델이 항상 필요한 것은 아닙니다. 현장에서는 동시 접속이 적고 지연이 중요한 내부 도구에서 먼저 켜 보고, 동시 접속이 많은 서비스에서는 켜기 전에 연속 배칭이 GPU를 얼마나 채우고 있는지부터 확인합니다.
10.7 Prefill-Decode 분리(Disaggregation)
원문: What is Prefill-Decode Disaggregation in LLM Inference?
프롬프트를 읽는 일(prefill)과 답을 쓰는 일(decode)은 하드웨어의 서로 다른 부분을 소모합니다. 한 GPU에 섞어 두면 서로 발목을 잡으므로, 이 절은 둘을 다른 기계로 나누는 서빙 방식의 동작과 비용을 다룹니다. 아래 수치와 제품 동작은 2026년 9월 글 기준입니다.
10.7.1 한 GPU에서 섞일 때의 문제
LLM은 요청 하나를 두 단계로 처리합니다. Prefill은 프롬프트(질문, 이전 대화, 지시문) 전체를 한 번에 읽어 첫 토큰을 만드는 단계이고, Decode는 답을 토큰 하나씩 쓰는 단계입니다. 채팅 앱에서 답이 단어 단위로 나타나는 것이 decode의 모습입니다. "인도의 수도는?"이라는 질문이면 prefill에서 질문 전체를 읽고, decode에서 한 스텝에 한 토큰씩 답을 이어 갑니다(10.2 참조).
두 단계를 잇는 것이 KV 캐시입니다. prefill 중 모델은 토큰마다 다른 토큰과의 관계를 계산하고, 그 결과를 메모리에 노트처럼 남겨 두어 decode의 매 스텝이 프롬프트를 다시 읽지 않게 합니다. 긴 프롬프트의 KV 캐시는 수 GB에 이르며, 이 크기가 분리 서빙의 비용을 좌우합니다(10.3 참조).
두 단계의 성격은 정반대입니다. 요리사에 비유하면 prefill은 열 쪽짜리 레시피를 한자리에서 읽고 요약 노트를 만드는 일이라 머리를 많이 쓰고 걷지는 않습니다. decode는 "소금 넣고 젓고 기다린다"를 반복하며 스텝마다 선반(메모리)까지 노트를 보러 오가는 일이라, 시간 대부분이 요리가 아니라 오가는 데 들어갑니다.
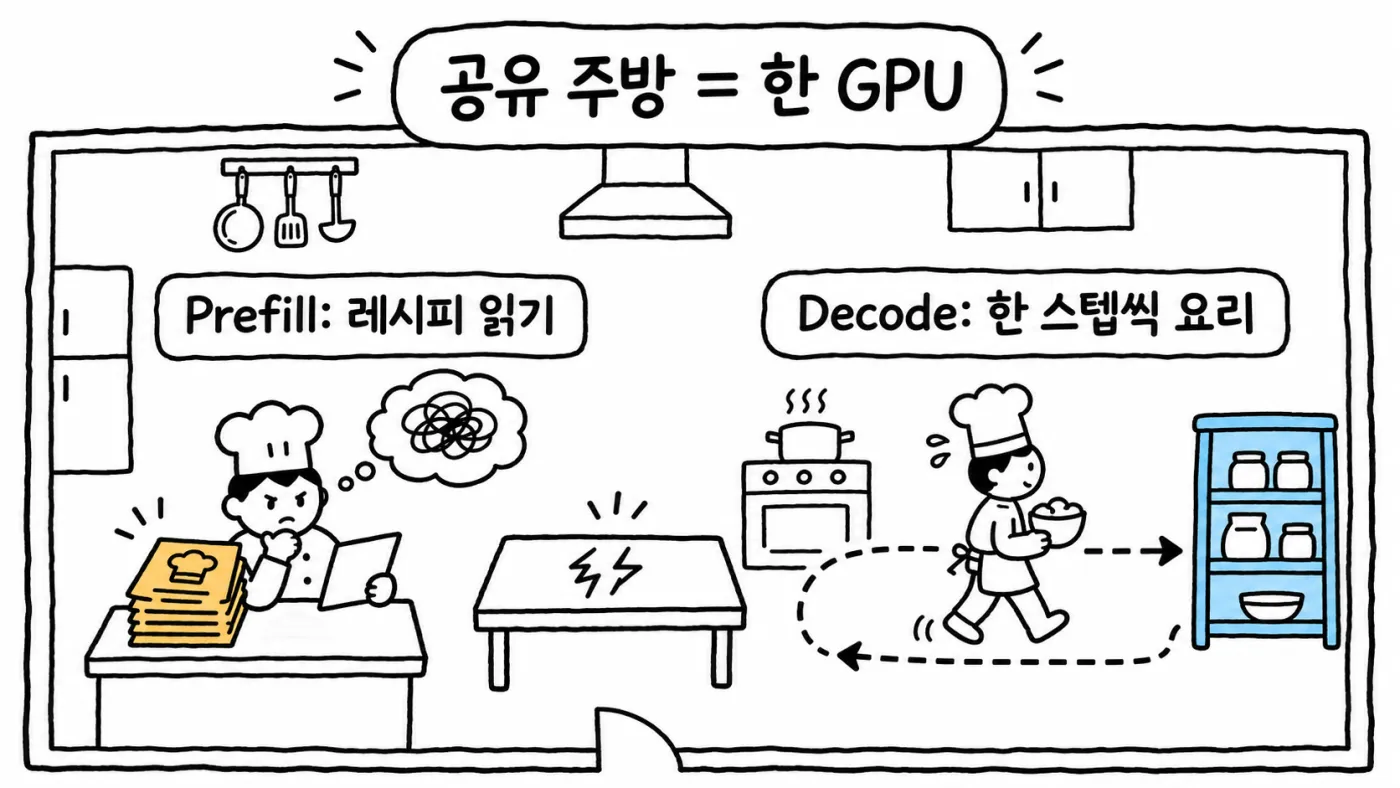
- Prefill은 연산 집약적입니다. 프롬프트 토큰 수천 개를 동시에 처리하므로 연산 유닛이 가득 차서 GPU가 최대 성능으로 일합니다.
- Decode는 메모리 집약적입니다. 스텝당 토큰이 하나뿐이라 계산량은 적지만, 매 스텝 모델 전체 가중치와 KV 캐시 전체를 메모리에서 읽어야 합니다. 연산 유닛은 데이터를 기다리며 대부분 놀게 됩니다.
한 GPU가 두 단계를 모두 처리하는 구성을 co-located 서빙이라 합니다. 여러 사용자의 요청을 묶어 처리하는 배칭(10.5 참조)을 쓰는 서버에서 열 명이 decode 중일 때 열한 번째 사용자가 1만 토큰짜리 문서를 보내면, GPU는 약 1초짜리 큰 prefill에 매달립니다. 그 1초 동안 나머지 열 명의 다음 토큰은 오지 않고 답이 문장 중간에서 멈춥니다. 이것이 generation stall(간섭)이며, 긴 프롬프트가 올 때마다 모든 사용자의 지연이 튑니다. 반대로 GPU가 decode로 바쁘면 새 사용자의 prefill이 밀려 첫 토큰이 늦어집니다. 두 단계가 같은 GPU를 두고 다투면 양쪽이 모두 손해를 봅니다.
고객이 "답이 가끔 중간에 멈춘다"고 호소하면, 같은 GPU에 긴 문서 요청이 섞여 들어오는지부터 확인합니다.
10.7.2 TTFT vs TPOT
간섭을 재려면 두 지표가 필요합니다. TTFT(Time To First Token)는 사용자가 엔터를 누른 뒤 첫 토큰이 화면에 나타나기까지의 시간으로 주로 prefill이 정하고, TPOT(Time Per Output Token)는 답이 써지는 동안 토큰과 토큰 사이의 간격으로 decode가 정합니다. TTFT는 답이 시작되기까지 기다리는 시간이고, TPOT는 시작된 답이 얼마나 매끄럽게 흐르는지입니다.
| 지표 | 정하는 단계 | 예시 값 | 체감 |
|---|---|---|---|
| TTFT | Prefill | 500ms | 반 초 뒤 답이 시작됨 |
| TPOT | Decode | 30ms | 이후 초당 약 33토큰이 흐름 |
TPOT 30ms는 1000 ÷ 30 ≈ 33으로, 원문의 "초당 약 30토큰"과 같은 규모입니다. 좋은 경험은 둘 다 낮아야 합니다. 그러나 co-located에서는 한쪽을 올리면 다른 쪽이 나빠지는 트레이드오프가 생깁니다.
- prefill에 우선권을 주면 TTFT는 좋아지지만 decode가 밀려 TPOT가 나빠집니다.
- decode에 우선권을 주면 TPOT는 좋아지지만 새 사용자가 오래 기다려 TTFT가 나빠집니다.
고객의 지연 요구를 받을 때는 "빨라야 한다"에서 멈추지 않고 TTFT 목표와 TPOT 목표를 따로 숫자로 받습니다. 두 숫자가 서로 다른 단계의 문제이기 때문입니다.
10.7.3 분리 서빙 동작과 요청 워크스루
원문이 먼저 검토하는 두 우회책은 모두 간섭을 없애지 못합니다.
- GPU를 더 사서 각 GPU가 두 단계를 모두 처리하게 하는 방법: 부하는 줄지만 각 GPU 안의 다툼은 그대로이고, 다툼이 덜 자주 일어날 뿐 비용은 크게 늘어납니다. 모든 GPU가 두 일을 다 잘해야 하므로 한 단계에 맞춘 하드웨어 선택도 못 합니다.
- Chunked prefill: 긴 prefill을 작은 조각으로 쪼개 매 배치의 decode 스텝에 섞는 방법입니다. 한 prefill이 decode를 오래 막지 않아 실제 시스템에서 많이 쓰이지만, 같은 GPU를 공유하므로 모든 decode 스텝에 prefill 일이 얹혀 TPOT가 조금 오르고, prefill은 조각나 더 늦게 끝나므로 TTFT도 오릅니다. 고통을 없앤 것이 아니라 펼친 것입니다.
Prefill-Decode Disaggregation은 prefill과 decode를 서로 다른 GPU 그룹에서 실행해 같은 하드웨어를 두고 다투지 않게 하는 기법입니다. disaggregation은 aggregation(합치기)의 반대로, 붙어 있던 것을 떼어 낸다는 뜻입니다. 레시피를 읽고 노트를 만드는 읽기 담당과 노트를 받아 요리하는 요리사를 따로 두는 것과 같습니다. 구성 요소는 네 가지입니다.
| 구성 요소 | 역할 |
|---|---|
| Router | 모든 요청을 받아 어느 prefill worker와 decode worker가 맡을지 정하는 작은 프로그램 |
| Prefill worker | prefill만 하는 GPU. 프롬프트를 한 번에 처리해 첫 토큰과 KV 캐시를 만듭니다. 연산에 맞춰 조정합니다 |
| Decode worker | decode만 하는 GPU. KV 캐시를 받아 토큰을 하나씩 생성합니다. 빠른 메모리 접근에 맞추고 많은 사용자를 동시에 받습니다 |
| KV 캐시 전송 | prefill worker가 만든 KV 캐시를 네트워크로 decode worker에 보내는 다리 |
flowchart TD
    R[요청] --> RT[Router]
    RT --> P[Prefill worker<br/>프롬프트 전체 읽기, KV 캐시 생성, 첫 토큰]
    P -->|KV 캐시를 네트워크로 전송| D[Decode worker<br/>KV 캐시 로드, 토큰 2, 3, 4 ... 생성]
    D --> U[답을 사용자에게 스트리밍]
그림 10.7.3 — 요청은 Router를 거쳐 prefill worker가 노트(KV 캐시)를 만들고, decode worker가 그 노트로 답을 씁니다.
원문의 의사 코드는 흐름을 이렇게 보여 줍니다. handle_request는 prefill worker와 decode worker를 하나씩 고르고, prefill이 첫 토큰과 KV 캐시를 돌려주면 첫 토큰을 곧바로 사용자에게 보냅니다. 이어 decode_worker.load(kv_cache)로 KV 캐시가 네트워크를 건너가고, decode worker가 답이 끝날 때까지 decode_step()을 반복하며 토큰이 나오는 대로 보냅니다.
KV 캐시 전송이 느리면 이득이 사라지므로 실제 시스템은 GPU 사이에 NVLink, InfiniBand, RDMA 같은 빠른 연결을 씁니다. 이는 한 기계의 메모리를 다른 기계로 아주 적은 지연으로 복사하는 케이블과 프로토콜이며, 기계 사이의 이 빠른 연결을 인터커넥트라 부릅니다. SGLang 같은 서빙 시스템이 이 구성을 기본 지원합니다(10.13 참조).
요청 하나의 흐름을 원문의 예시 수치로 따라가 봅니다. 프롬프트 4000토큰, 답 200토큰입니다.
- 요청이 Router에 도착하고, Router가 부하가 가장 적은 prefill worker를 고르며 decode worker의 자리도 예약합니다.
- prefill worker가 4000토큰을 한꺼번에 처리합니다. 연산 유닛이 최대로 돌아 약 400ms가 걸리고, 첫 토큰과 약 2GB의 KV 캐시가 나옵니다.
- 첫 토큰이 사용자에게 갑니다. TTFT는 약 400ms입니다.
- 2GB KV 캐시가 빠른 네트워크로 decode worker에 복사됩니다. 20~50ms가 걸린다는 가정은 약 40~100GB/s의 실효 대역폭에 해당합니다. 실제 시스템은 prefill이 진행되는 중에 조각 단위로 전송을 시작해 이 대기를 숨기는 경우가 많습니다.
- decode worker가 KV 캐시를 로드해 토큰 2, 3, ...을 만듭니다. 토큰당 20ms이므로 TPOT는 20ms이고 200토큰은 약 4초(200 × 20ms)입니다.
- prefill worker는 KV 캐시를 넘긴 즉시 다음 사용자의 프롬프트로 넘어갑니다. 이 사용자의 decode를 기다리지 않습니다.
- decode worker에는 prefill이 아예 오지 않으므로 이 사용자의 답이 도중에 끊기지 않습니다.
종단 시간은 단순 합산으로 0.4 + 0.02~0.05 + 4.0 ≈ 4.4초입니다. 사용자는 빠른 시작(낮은 TTFT)과 매끄러운 흐름(낮은 TPOT)을 동시에 얻습니다.
현장에서는 전송 구간이 병목이 되지 않는지를 확인합니다. KV 캐시 크기와 인터커넥트 대역폭을 곱해 보면 이 구성이 성립하는지 바로 판단됩니다.
10.7.4 장단점
장점은 단계별로 독립적으로 조정할 수 있다는 데서 나옵니다.
- 독립 확장: 긴 프롬프트에 짧은 답이 많으면 prefill worker를, 짧은 프롬프트에 긴 답이 많으면 decode worker를 늘립니다. 두 단계를 함께 키우지 않습니다.
- 간섭 제거: 한 사용자의 긴 prefill이 다른 사용자의 decode를 막지 못하므로 TTFT와 TPOT를 따로 조정합니다.
- 단계별 하드웨어: prefill에는 연산이 가장 강한 GPU를, decode에는 더 빠르고 큰 메모리를 가진, 흔히 더 저렴한 GPU를 씁니다. 모든 것을 잘하는 비싼 GPU 한 종류를 사지 않아도 됩니다.
- 더 나은 배칭: decode worker는 모두 같은 작은 스텝을 하므로 많은 사용자를 큰 배치로 묶을 수 있어 메모리 읽기 효율이 오르고 토큰당 비용이 내려갑니다.
- 예측 가능한 지연: 두 단계가 다투지 않아 응답 시간이 안정되고 답 중간의 무작위 멈춤이 사라집니다.
단점은 분리 자체의 비용입니다.
- KV 캐시 전송 비용: 요청마다 KV 캐시를 네트워크로 옮겨야 하며, 긴 프롬프트면 수 GB입니다. 빠른 인터커넥트가 없으면 전송이 얻은 이득보다 오래 걸릴 수 있습니다.
- 빠른 인터커넥트 필요: NVLink나 InfiniBand급 연결이 필요하고 일반 네트워크는 너무 느리며, 이 자체가 비용입니다.
- 복잡도: Router, 두 종류의 worker, 전송 시스템, 각각의 장애 처리가 생깁니다. decode worker가 답 도중 죽으면 KV 캐시가 사라져 요청을 처음부터 다시 해야 합니다.
- 유휴 용량: 긴 프롬프트가 없는 순간에는 prefill worker가 놀고 decode worker가 몰리거나 그 반대가 되므로, 트래픽을 감시해 worker 수를 맞춰야 합니다.
- 소규모에는 과잉: 사용자가 적으면 이 장치 전체가 노력만큼의 가치를 주지 못합니다.
도입 제안 때는 장점 다섯 가지 중 고객이 실제로 겪는 것이 몇 개인지, 단점 중 인프라가 이미 감당하는 것이 몇 개인지를 한 장의 표로 맞춰 봅니다.
10.7.5 과잉인 경우
분리가 맞는 조건과 과잉인 조건은 규모와 네트워크로 갈립니다.
| 분리가 잘 맞는 경우 | 과잉인 경우 |
|---|---|
| 공개 채팅 제품처럼 동시 사용자가 많음 | 단일 GPU나 노트북에서 모델을 실행함 |
| 문서, 대화 이력, 코드 파일처럼 프롬프트가 길고 답이 스트리밍됨 | 사용자가 아주 적음 |
| 사용자가 빠른 시작과 매끄러운 흐름을 모두 원함 | 프롬프트가 짧아 KV 캐시가 작고 분리할 것이 별로 없음 |
| 데이터센터 안처럼 GPU 사이에 빠른 인터커넥트가 있음 | 기계 사이에 빠른 네트워크가 없음 |
작은 구성이라면 단일 GPU의 chunked prefill이 더 단순하고 충분한 선택입니다. 큰 구성에서는 분리가 정답에 가깝습니다. 분리는 LLM 서빙을 빠르게 하는 여러 기법 중 하나일 뿐이며, 전체 지도는 10.1에 있습니다.
고객이 사내 동시 사용자 수십 명 규모라면 분리를 권하기 전에 chunked prefill로 TTFT·TPOT 목표가 충족되는지를 먼저 측정합니다.
10.7.6 Co-located vs Disaggregated 비교
두 방식의 차이를 한 표로 놓고, 고객의 규모에 맞는 쪽을 고릅니다.
| 항목 | Co-located 서빙 | Disaggregated 서빙 |
|---|---|---|
| Prefill이 도는 곳 | decode와 같은 GPU | 별도 prefill worker |
| Decode가 도는 곳 | prefill과 같은 GPU | 별도 decode worker |
| 단계 간 간섭 | 있음. prefill이 decode를 멈춤 | 없음 |
| TTFT와 TPOT | 트레이드오프. 하나를 올리면 다른 하나가 나빠짐 | 따로 조정 가능 |
| 확장 | 두 단계를 함께 확장 | 단계별 독립 확장 |
| 하드웨어 선택 | 한 종류의 GPU가 두 일을 모두 해야 함 | 단계마다 다른 GPU |
| KV 캐시 전송 | 불필요 | 요청마다 필요 |
| 네트워크 요건 | 없음 | 빠른 인터커넥트 필수 |
| 복잡도 | 낮음 | 높음 |
| 적합한 경우 | 소규모, 단일 GPU, 짧은 프롬프트 | 대규모, 많은 사용자, 긴 프롬프트 |
FAQ에서 확인되는 질문도 같은 표 위에 놓입니다. GPU를 늘려도 각 GPU 안의 다툼이 남으므로 간섭은 해결되지 않고, decode worker가 죽으면 그 worker의 KV 캐시가 사라져 요청을 다시 실행해야 합니다. prefill worker와 decode worker는 서로 다른 GPU를 써도 되며, 이것이 단계별 하드웨어 선택의 근거입니다.
10.8 모델 양자화(Quantization)
원문: How does Model Quantization work?
모델이 메모리에 들어가지 않거나 느리면 비용과 배포 환경이 막힙니다. 양자화는 모델의 숫자를 더 적은 비트로 저장하고 계산해 이 두 문제를 함께 줄이는 기법이며, 이 절은 그 메커니즘과 대표 방법론을 다룹니다. 방법론 설명은 2026년 7월 글 기준입니다.
10.8.1 FP32·INT8·INT4 비트 표현
**모델 양자화(Model Quantization)**는 모델의 숫자를 낮은 정밀도로 저장하고 계산해 메모리를 줄이고 속도를 높이는 과정입니다. 모델은 본질적으로 거대한 숫자 모음이고, 그 숫자가 가중치입니다. 대규모 언어 모델에는 수십억 개의 가중치가 있습니다. 양자화는 0.7319284 같은 상세한 소수를 94 같은 단순한 정수로 반올림합니다. 정수가 더 커 보여도 저장에 필요한 비트가 훨씬 적습니다. 고해상도 사진을 압축하면 거의 같아 보이면서 용량이 줄어드는 것과 같은 원리입니다.
컴퓨터는 비트(0 또는 1)의 묶음으로 숫자를 저장하며, 비트가 많을수록 상세하고 정밀합니다. AI 모델에서 흔한 형식은 다음과 같습니다.
| 형식 | 비트 | 저장하는 값 | 상세도 |
|---|---|---|---|
| FP32 | 32 | 소수, 아주 정밀 | 최상 |
| FP16 | 16 | 소수, 덜 정밀 | 높음 |
| BF16 | 16 | 소수, 넓은 범위 | 높음 |
| INT8 | 8 | 정수, 256개 값(-128~127) | 낮음 |
| INT4 | 4 | 정수, 16개 값 | 최저 |
FP32는 32비트 부동소수점(소수부가 있는 수를 저장하는 컴퓨터의 방식)이며 대부분의 모델이 학습 중 쓰는 형식입니다. FP16과 BF16은 16비트로 FP32의 절반 크기입니다. INT8은 8비트 정수라 값이 256가지, INT4는 4비트라 16가지뿐입니다. 표를 내려갈수록 비트가 줄고 숫자가 단순해지며 공간이 작아지는 것이 양자화 이득의 출발점입니다.
비트 수에서 줄어드는 만큼 메모리가 줄어듭니다. 가중치 하나는 FP32에서 4바이트, INT8에서 1바이트, INT4에서 0.5바이트입니다. 70억 개 가중치 모델을 python3로 계산하면 다음과 같습니다.
| 형식 | 가중치당 바이트 | 70억 가중치 모델 크기 | FP32 대비 |
|---|---|---|---|
| FP32 | 4 | 약 28GB | 1배 |
| FP16 | 2 | 약 14GB | 1/2 |
| INT8 | 1 | 약 7GB | 1/4 |
| INT4 | 0.5 | 약 3.5GB | 1/8 |
FP16 행은 원문 본문에 없는 계산이지만 바이트 수에서 직접 나옵니다. 28GB 모델이 3.5GB가 되면 데이터센터급 장비가 필요하던 모델이 GPU 한 장이나 좋은 노트북에 들어옵니다. 모델의 모양은 그대로이고 숫자 하나의 크기만 달라집니다.
속도도 빨라집니다. 모델이 돌아갈 때 컴퓨터는 메모리에서 가중치를 계속 읽는데, 1바이트를 옮기는 것이 4바이트를 옮기는 것보다 훨씬 빠릅니다. 많은 칩에서 정수 연산이 소수 연산보다 빠르기도 합니다. 그래서 모델이 더 잘 들어가고, 더 빨리 돌고, 전력도 덜 씁니다. 치르는 값은 약간의 정확도 손실입니다(10.8.6, 10.8.7의 정확도 논의 참조).
고객이 "GPU가 모자란다"고 하면 가중치 개수 × 바이트 수로 필요 메모리를 먼저 계산해 형식별 후보를 제시합니다. KV 캐시와 활성화는 이 계산에 포함되지 않으므로 여유를 따로 남깁니다(10.3 참조).
10.8.2 스케일과 제로 포인트
양자화의 핵심은 소수 범위를 작은 정수 집합에 대응시키는 일이며, 도우미 값이 둘 필요합니다. **스케일(scale)**은 정수 한 칸이 실제 값 얼마를 나타내는지, 즉 한 걸음의 크기이고, **제로 포인트(zero-point)**는 실제 값 0을 나타내는 정수입니다. 스케일이 정수를 늘리거나 줄여 범위를 덮고, 제로 포인트가 정렬을 맞춥니다.
quantized_int = round(real_value / scale) + zero_point
real_value ≈ (quantized_int - zero_point) * scale
양자화 후 역양자화를 해도 원래 값이 정확히 돌아오지 않고 가까운 값이 나오며, 이 차이가 반올림 오차로 정확도 손실의 근원입니다.
구체 예시로 가중치 범위가 -1.0~1.0이고 INT8 슬롯에 0~255 라벨을 붙인다고 합시다. python3 -I로 재계산한 값입니다.
- 전체 범위는
1.0 - (-1.0) = 2.0이고 사용할 칸은 255개이므로 스케일은2.0 / 255 ≈ 0.00784입니다. - 실제 값 0은 중간에 놓여야 하므로 제로 포인트는 약
128입니다. - 가중치
0.5는round(0.5 / 0.00784) + 128 = round(63.8) + 128 = 64 + 128 = 192입니다. 원문은 63.7로 적었으나 실제는 63.77이며, 반올림 결과 64는 같습니다. - 되읽으면
(192 - 128) × 0.00784 ≈ 0.502입니다(정확한 스케일로 계산하면 0.5020).
0.5를 저장해 0.502가 돌아왔고, 이 0.002가 반올림 오차입니다.
flowchart LR
    A["실제 값 FP32<br/>-1.0 ... 0.0 ... 0.5 ... 1.0"] -->|"scale ≈ 0.00784, zero-point 128"| B["INT8 슬롯<br/>0 ... 128 ... 192 ... 255"]
그림 10.8.2 — 실제 값의 넓은 범위가 정수 슬롯으로 대응되고, 0.0은 128에, 0.5는 192에 놓입니다.
이 장치가 모든 양자화의 엔진이며, 나머지는 범위·스케일·제로 포인트를 어떻게 고르느냐의 문제입니다. 고객 모델에서 정확도가 떨어졌다면 먼저 이 범위를 어떻게 잡았는지, 보정 데이터가 대표성이 있었는지를 묻습니다.
10.8.3 대칭 vs 비대칭, 텐서별 vs 채널별
스케일과 제로 포인트를 두는 방식에는 두 축이 있습니다.
**대칭 양자화(Symmetric)**는 -1.0~1.0처럼 0을 중심으로 한 범위를 -127~127 같은 부호 있는 정수에 대응시킵니다. 범위가 0 주위에 균형을 이루므로 제로 포인트가 0이 되고 계산이 단순하고 빠릅니다. **비대칭 양자화(Asymmetric)**는 0.0~6.0처럼 0 중심이 아닌 범위를 쓰며, 제로 포인트를 한쪽으로 옮겨 치우친 범위를 정수 전체로 덮습니다.
- 모델 가중치처럼 음수와 양수에 고르게 퍼진 값은 대칭이 잘 맞습니다. 정수 값이 낭비되지 않습니다.
- 항상 양수인 값, 예컨대 음수가 나올 수 없는 함수의 출력에 대칭을 쓰면 정수의 절반이 음수 쪽에서 아무 일도 안 해 정밀도가 낭비됩니다. 이때 비대칭이 실제 범위에 바짝 맞춰 모든 정수를 씁니다.
- 대칭의 장점은 단순하고 빠른 계산, 비대칭의 장점은 한쪽으로 치우친 데이터에 대한 더 나은 적합입니다.
다음 축은 이 값들을 어느 단위에 적용하느냐입니다. **텐서(tensor)**는 숫자의 큰 격자이며 모델의 한 층 가중치가 텐서 하나입니다.
- 텐서별(Per-tensor): 텐서 전체에 스케일과 제로 포인트 하나를 씁니다. 단순하고 빠르지만 약점이 있습니다. 한 행은
0.001같은 작은 값이고 다른 행은0.9같은 큰 값이면, 스케일 하나로 둘을 덮을 때 작은 값들이 거의 같은 정수로 뭉개져 상세함을 잃습니다. - 채널별(Per-channel): 행(채널)마다 별도 스케일을 씁니다. 작은 행은 촘촘한 스케일을, 큰 행은 자기 스케일을 받아 각자 상세함을 유지합니다. 스케일을 여러 개 저장하느라 메모리가 조금 더 들지만 정확도가 훨씬 좋아서 가중치에는 채널별이 흔합니다.
| 방식 | 스케일 수 | 장점 | 약점 |
|---|---|---|---|
| 텐서별 | 텐서당 1개 | 단순, 빠름 | 크기가 다른 행이 섞이면 작은 값이 뭉개짐 |
| 채널별 | 행마다 1개 | 행별 상세 유지, 정확도 우수 | 스케일 저장에 메모리가 조금 더 듦 |
양자화 도구 설정에서 granularity 항목이 보이면 이 두 선택지를 가리키는 것이므로, 정확도가 문제인 고객에게는 채널별을 먼저 확인합니다.
10.8.4 PTQ vs QAT
양자화를 언제 적용하느냐에 따라 두 접근이 갈립니다.
PTQ(Post-Training Quantization, 학습 후 양자화)는 이미 학습된 모델을 사후에 양자화하는 방식입니다. 다시 학습하지 않고 가중치를 보고 좋은 스케일과 제로 포인트를 골라 숫자를 바꿉니다. "먼저 학습하고 나중에 줄인다"이며, 빠르고 싸고 큰 학습 설비가 필요 없어 가장 인기 있습니다. 범위를 재는 데는 보통 소량의 샘플 데이터면 됩니다. 다만 모델이 양자화될 것을 몰랐으므로, 특히 INT4 같은 극저비트에서는 반올림 오차가 원하는 것보다 정확도를 더 해칠 수 있습니다.
QAT(Quantization-Aware Training, 양자화 인지 학습)는 학습 중에 양자화를 가르치는 방식입니다. 학습 중 반올림 오차를 모의해 모델이 이를 견디도록 가중치를 조정합니다. "줄여질 준비가 되게 학습한다"입니다.
flowchart LR
    subgraph PTQ
    A1[모델 학습] --> A2[학습된 모델] --> A3[양자화] --> A4[작은 모델]
    end
    subgraph QAT
    B1[반올림을 모의하며 모델 학습] --> B2[양자화] --> B3[작은 모델]
    end
그림 10.8.4 — PTQ는 학습이 끝난 뒤 한 단계를 더하고, QAT는 반올림을 학습 안에 포함합니다.
| 항목 | PTQ | QAT |
|---|---|---|
| 적용 시점 | 학습 후 | 학습 중 |
| 비용 | 낮고 빠름 | 높음, 전체 학습 필요 |
| 필요한 데이터 | 소량 샘플 | 전체 학습 데이터 |
| 저비트 정확도 | 양호 | 최고 |
| 사용 난이도 | 쉬움 | 어려움 |
속도와 단순함이 중요하면 PTQ, 극저비트에서 최고 정확도가 필요하면 QAT를 고릅니다. 원문은 프런티어 모델이 프로덕션에서 QAT를 쓰며, DeepSeek-V4가 추론을 더 빠르고 싸게 하려고 FP4 QAT로 학습한다고 전합니다. 2026년 7월 글 기준의 서술이며, 제품 동작은 바뀔 수 있습니다.
고객이 이미 공개된 모델을 받아 쓰는 상황이면 학습 설비가 없으므로 사실상 PTQ가 선택지입니다. 모델을 직접 학습하는 고객에게만 QAT를 제안합니다.
10.8.5 가중치 전용 vs 가중치+활성화
가중치 말고도 모델이 돌아가는 동안에만 생기는 숫자가 있습니다. 각 층이 내보내 다음 층으로 흐르는 출력이 **활성화(activation)**입니다. 모델의 숫자는 고정된 가중치와, 실행 중에만 나타나는 활성화 두 종류입니다.
- 가중치 전용(Weight-only): 가중치만 양자화하고 활성화는 FP16 같은 더 높은 정밀도로 둡니다. 가중치가 모델의 대부분이라 메모리 절감이 이미 크고 정확도 면에서도 안전해서 LLM에서 가장 흔한 선택입니다.
- 가중치+활성화(Weight-and-activation): 둘 다 INT8처럼 낮은 정밀도로 만듭니다. 계산 자체가 빠른 정수 형태로 돌아 속도가 더 오릅니다. 큰 서버 없이 스스로 AI를 돌리는 휴대폰·소형 기기의 작은 모델에서 흔합니다.
LLM에는 세 번째 숫자 집합인 긴 대화 중 쌓이는 KV 캐시도 있고, 이것 역시 양자화할 수 있습니다. 이는 KV 캐시 압축 기법의 하나입니다(10.1.1 참조).
그렇다면 활성화도 항상 양자화하면 되지 않느냐는 질문이 남고, 그 답이 다음 소절의 이상치 문제입니다. 서버에서 LLM을 서빙하는 고객이라면 가중치 전용을 기본값으로 삼고, 활성화까지 줄이는 안은 정확도 검증 계획이 있을 때 제안합니다.
10.8.6 LLM의 이상치(outlier) 문제
LLM의 활성화는 얌전하지 않습니다. 대부분은 작은데 몇 개는 아주 큰 값이며, 이 드물고 극단적인 값이 **이상치(outlier)**입니다. 거의 모든 값이 -1~1에 있는데 몇 개가 60까지 튄다고 합시다. 그 값 하나를 담으려면 범위가 -1~60으로 늘어나 스케일이 크게 벌어지고, 평범한 작은 값들이 몇 개의 정수로 뭉개집니다. 이상치 하나가 나머지 전체의 정밀도를 망칩니다.
| 상황 | 범위 | 스케일 | 결과 |
|---|---|---|---|
| 이상치 없음 | -1 ~ 1 | 촘촘함 | 상세 유지 |
| 이상치 1개(60) | -1 ~ 60 | 아주 넓음 | 작은 값 대부분이 뭉개짐 |
이상치 때문에 대형 모델의 활성화 양자화가 어렵고, 현대 양자화 방법들은 바로 이 문제를 풀도록 설계됩니다. 정확도가 유독 나쁜 층이 발견되면 이상치 때문인지부터 의심하고, 그 값을 높은 정밀도로 두는 방법이 있는지 봅니다.
10.8.7 GPTQ·AWQ·bitsandbytes·GGUF
양자화를 직접 발명할 필요 없이 검증된 방법과 도구가 있습니다.
| 방법 | 핵심 아이디어 | 특징 |
|---|---|---|
| GPTQ(Generative Pre-trained Transformer Quantization) | 학습 후 방식으로 LLM 가중치를 4비트까지, 층 하나씩 신중하게 양자화합니다. 각 가중치를 반올림한 뒤 남은 가중치를 조금 조정해 방금 생긴 오차를 보상합니다 | 맹목적으로 반올림하지 않고 고쳐 가므로 4비트에서도 정확도가 높음 |
| AWQ(Activation-aware Weight Quantization) | 모든 가중치가 똑같이 중요하지는 않다는 점에 착안합니다. 큰 활성화 값에 연결된 중요한 가중치를 찾아 특별 대우해 상세함이 뭉개지지 않게 합니다 | 4비트로 내리면서 정확도 유지 |
| bitsandbytes | 모델을 8비트나 4비트로 바로 로드하게 해 주는 사용하기 쉬운 라이브러리입니다. Hugging Face와 널리 쓰이며 몇 줄이면 됩니다 | 단일 GPU에서 큰 모델을 돌리는 가장 쉬운 입문 선택. 이상치 값은 높은 정밀도로 유지해 정확도를 지킴 |
| GGUF와 llama.cpp | llama.cpp는 CPU에서 언어 모델을 돌리는 빠른 엔진이고 GGUF는 양자화 모델을 담는 파일 형식입니다 | GPU가 없는 일반 컴퓨터용. 4비트, 5비트 등 여러 크기가 GGUF 파일 하나에 담김 |
서버 쪽에서는 TensorRT-LLM이 NVIDIA GPU에서 같은 일을 해, 여러 사용자를 서빙하면서 이런 작은 숫자 형식을 적용합니다(10.14 참조). GGUF와 llama.cpp는 각각 10.9, 10.10 참조.
원문의 bitsandbytes 코드는 핵심이 두 줄입니다. BitsAndBytesConfig(load_in_4bit=True)로 설정을 만들고, AutoModelForCausalLM.from_pretrained(..., quantization_config=config)로 모델을 불러오면 스케일과 제로 포인트 계산을 라이브러리가 대신하고 수십 GB 모델이 훨씬 적은 메모리로 올라옵니다.
양자화는 공짜가 아닙니다. 비트를 줄일 때마다 상세함이 조금씩 사라집니다. INT8에서는 손실이 작아 거의 느끼지 못하고, INT4에서는 더 크지만 GPTQ와 AWQ 같은 방법이 놀랄 만큼 작게 유지합니다. 2비트 같은 극저비트에서는 모델이 뚜렷한 실수를 하기 시작합니다. 비트가 적을수록 작고 빠르지만 덜 정확하며, 목표는 훨씬 가벼우면서 원본에 가까운 정확도를 내는 지점을 찾는 것입니다. 오늘날 대규모 언어 모델에서는 대체로 4비트 양자화가 그 지점입니다.
실제 가치는 이렇습니다. 클라우드와 월 비용 없이 노트북에서 강력한 챗봇을 돌리고 싶을 때, FP32 모델은 너무 크지만 4비트로 양자화한 같은 모델은 무리 없이 들어가 쓸 만한 속도로 돕니다. llama.cpp와 GGUF 파일이 매일 하는 일이며, 프라이버시·무비용·완전한 통제를 얻습니다. 어디서 돌릴지는 클라우드 대 온디바이스 배포 결정이 별도로 있습니다.
양자화만이 모델을 줄이는 길은 아닙니다. 지식 증류(Knowledge Distillation)는 숫자를 반올림하는 대신 작은 학생 모델이 큰 교사 모델을 흉내 내도록 학습시킵니다. 양자화는 같은 모델의 숫자를 낮은 정밀도로 저장하는 것이고, 증류는 새 작은 모델을 학습하는 것이라는 점이 다릅니다.
고객과 비트 수를 정할 때는 INT8에서 시작해 정확도 평가 세트로 측정하고, 요구 품질을 유지하는 한 INT4까지 내려가며, 2비트는 품질 검증 없이 제안하지 않습니다.
10.9 GGUF
양자화(10.8)가 숫자를 줄이는 방법이라면, GGUF는 줄인 모델을 한 파일에 담아 노트북에서 바로 실행할 수 있게 하는 파일 포맷입니다. 이 절은 포맷이 생긴 이유와 내부 구성, 파일 이름 읽는 법을 다룹니다. 서술은 2026년 6월 글 기준입니다.
10.9.1 GGUF 이전의 문제
모델은 가중치(학습으로 얻은 숫자)의 거대한 모음이며, 가중치는 보통 텐서(숫자로 채운 격자, 큰 표)로 저장됩니다. 70억 개 가중치 모델은 70억 개의 숫자 목록입니다. 모델을 쓰는 행위가 **추론(inference)**이고, 학습이 모델이 배우는 때라면 추론은 모델이 일하는 때입니다. 추론을 돌리는 곳은 두 곳입니다. 클라우드 서버는 텍스트를 인터넷으로 보내 답을 받아 오는 방식이고, **로컬 추론(local inference)**은 노트북이나 컴퓨터에서 모델을 직접 돌려 아무것도 기기 밖으로 나가지 않는 방식입니다. 로컬 추론은 데이터가 외부로 나가지 않아 프라이버시가 지켜지고, 인터넷 없이 되며, 클라우드 사용료가 없다는 이유로 선택됩니다.
로컬에서 모델을 돌리려면 프로그램에 세 가지가 함께 필요했습니다.
- 가중치: 텐서로 저장된 학습된 숫자
- 토크나이저: 텍스트를 모델이 읽을 작은 조각(토큰)으로 쪼개고 다시 이어 붙이는 도구
- 설정과 메타데이터: 어떤 종류의 모델인지, 어떻게 만들어졌는지, 한 번에 얼마만큼의 텍스트를 다루는지 같은 설명
초기에는 이 조각들이 서로 다른 형식의 여러 파일로 흩어져 있었습니다. 프로그램이 모두 찾아 각각 올바르게 읽고 이어 붙여야 해서 세 가지 문제가 생겼습니다.
| 문제 | 내용 |
|---|---|
| 깨지기 쉬움 | 파일 하나가 없거나 형식이 조금 달라도 로딩이 실패함 |
| 이식성 없음 | 모델을 공유하려면 파일이 여러 개인 폴더를 넘겨야 하고, 상대방 도구가 다르게 읽을 수 있음 |
| 느린 로딩 | 모델이 준비되기도 전에 여러 파일을 읽어 합치는 데 시간이 듦 |
더 이른 포맷인 GGML이 일반 컴퓨터용으로 요소를 묶으려는 첫 시도였고 로컬 추론을 가능하게 했습니다. 그러나 모델이 커지고 설계가 바뀌면서 유연성이 모자랐고, 파일에 새 정보를 더하기가 고통스러웠으며, 모델 설계가 바뀔 때마다 포맷이 따라가지 못했습니다. 필요한 것은 모든 것을 담고, 빨리 로딩되고, 확장하기 쉬운 잘 정리된 단일 파일이었습니다.
고객이 모델을 폴더째 USB로 옮겨 달라고 하거나 "토크나이저 파일이 없다"는 오류를 만나면 이 흩어진 형태의 문제입니다. 단일 파일 하나로 전달할 수 있는 포맷부터 확인합니다.
10.9.2 GGUF 파일 내부 구성
GGUF(GPT-Generated Unified Format)는 로컬 추론에 필요한 모든 것을 자기완결적인 파일 하나에 저장하는 포맷입니다. 핵심은 Unified로, 모델에 필요한 것이 여러 파일에 흩어지지 않고 하나로 모여 있다는 뜻입니다. GGML의 후속이며 GGML의 한계를 고치려고 만들어져 지금은 로컬 실행의 표준 포맷입니다. 이사할 때 침대·탁자·의자가 세 상자에 부품으로 나뉘고 설명서도 세 가지 언어인 상태가 옛 방식이고, GGUF는 라벨이 붙은 한 상자를 열자마자 쓰는 것에 비유됩니다.
파일은 세 종류를 함께 담도록 만들어져 있습니다.
- 텐서: 가중치이며 수십억 개 숫자이므로 파일에서 가장 큰 부분입니다.
- 키-값 메타데이터: 데이터를 설명하는 데이터를 키와 값의 쌍으로 저장합니다. 키가 architecture(모델 종류와 구조)이면 값이 어떤 모델인지 알려 주고, 키가 context length(한 번에 읽는 토큰 수)이면 값은
4096같은 숫자입니다. 이런 쌍이 모델을 완전히 설명합니다. - 토크나이저: 모델은 원문 텍스트를 읽지 못하므로 먼저 토큰으로 나눕니다. GGUF는 토크나이저의 어휘와 규칙을 파일 안에 저장하므로 텍스트를 이해하는 데 추가 파일이 필요 없습니다.
| 영역 | 내용 |
|---|---|
| Header | GGUF 네 글자 표식, 버전, 개수 |
| Key-value metadata | architecture = "llama", context length = 4096, tokenizer vocab, 양자화 정보 등 |
| Tensor info | 목차 역할. 각 텐서의 이름, 모양, 파일 안의 위치 |
| Tensor data | 가중치 본체. 수십억 개의 숫자 |
flowchart TD
    H["Header<br/>GGUF 표식 + 버전 + 개수"] --> M["Key-value metadata<br/>architecture, context length, tokenizer, 양자화 정보"]
    M --> I["Tensor info<br/>이름, 모양, 위치 목차"]
    I --> D["Tensor data<br/>가중치 본체"]
그림 10.9.2 — GGUF 파일은 위에서 아래로 헤더, 메타데이터, 텐서 목차, 텐서 데이터 순으로 구성됩니다.
헤더의 GGUF 표식은 어떤 프로그램에게든 이것이 GGUF 파일임을 알립니다. 파일 하나로 가중치, 설명, 토크나이저가 한곳에 모여 흩어진 파일 문제가 해결됩니다.
고객이 "이 파일이 어떤 모델인지, 컨텍스트가 몇 토큰인지 모르겠다"고 하면 외부 문서를 뒤지기 전에 파일의 메타데이터가 스스로 말해 주는 정보부터 읽도록 안내합니다.
10.9.3 Q4_K_M 같은 양자화 이름 해독
모델이 커서 파일이 노트북 메모리에 들어가지 않는다는 문제는 양자화로 풉니다. 숫자 하나를 몇 비트로 저장하느냐가 정밀도와 공간을 정하며, 가중치마다 16비트면 70억 개 모델은 가중치만 약 14GB(7×10⁹ × 2바이트)이고 일반 노트북이 편히 감당하기 어렵습니다. 양자화는 가중치를 더 적은 비트로 저장해 모델을 훨씬 작게 만드는 기법입니다. 19.997루피를 20루피로 반올림하면 더 짧고 저장하기 쉬우면서 대부분의 용도에 충분한 것과 같은 원리입니다.
16비트에서 약 4비트로 내리면 70억 가중치 모델이 약 14GB에서 약 4GB로 줄어듭니다. 순수 4비트 계산은 3.5GB이며 원문이 "약 4GB"라고 쓴 값은 이 숫자에 보조 정보 등이 더해진 크기로 읽으면 됩니다. 이렇게 줄면 일반 노트북의 CPU나 GPU에서 돌릴 수 있습니다. 트레이드오프는 다음과 같습니다.
- 비트가 적으면 작고 빠르지만 품질이 약간 낮습니다. 숫자가 덜 정확해져 답이 조금 덜 정확해질 수 있습니다.
- 비트가 많으면 크고 느리지만 품질이 높고 원본 모델에 가깝습니다.
GGUF는 여러 양자화 수준을 지원하고 양자화된 가중치를 파일 안에 직접 담습니다. 모델을 줄이는 다른 길로는 작은 모델이 큰 모델을 흉내 내는 지식 증류가 있습니다.
다운로드하는 GGUF 모델에서 Q4_K_M, Q5_K_M, Q8_0 같은 이름을 보게 됩니다. Q4_K_M은 세 부분으로 읽습니다.
| 조각 | 의미 |
|---|---|
Q |
양자화됨(quantized) |
4 |
가중치당 대략 4비트. Q8이면 약 8비트 |
K |
비트를 더 현명하게 배분해 품질을 높게 유지하는 최신 방식 |
M |
크기 변형. S는 small, M은 medium, L은 large |
규칙은 이렇습니다. 숫자는 가중치당 비트 수이며, 숫자가 클수록 비트가 많아 파일이 크고 품질이 좋고, 작을수록 파일이 작고 품질이 약간 낮습니다.
| 이름 | 가중치당 비트 | 파일 크기 | 품질 | 적합한 경우 |
|---|---|---|---|---|
Q4_K_M |
약 4 | 셋 중 가장 작음 | 좋음 | 메모리가 한정된 노트북, 좋은 균형 |
Q5_K_M |
약 5 | 중간 | 더 좋음 | 메모리가 조금 더 있고 답이 조금 더 좋기를 원할 때 |
Q8_0 |
약 8 | 셋 중 가장 큼 | 최고 | 메모리가 충분하고 품질이 가장 중요할 때 |
같은 70억 모델에서 비트만 곱하면 대략 Q5는 4.4GB, Q8은 7GB입니다(가중치 수 × 비트 ÷ 8, 보조 정보 제외). Q4_K_M은 가장 작으면서 품질이 좋아 가장 인기 있는 선택이며, 어느 것을 고를지 모르면 대부분의 노트북에서 안전한 시작점입니다. 답이 조금 어긋난다고 느끼고 메모리가 남으면 Q5_K_M이나 Q8_0으로 올립니다. 양자화 일반론은 10.8을 참조합니다.
고객 PC의 여유 메모리를 묻고, 그 안에서 들어가는 가장 높은 Q 숫자를 고르게 합니다. 품질 불만이 나오면 한 단계 올려 본 뒤에 모델을 바꿉니다.
10.9.4 메모리 매핑으로 빠른 로딩
몇 GB인 GGUF 모델이 어떻게 메모리를 채우지 않고 빨리 시작하느냐는 질문의 답이 **메모리 매핑(memory mapping, mmap)**입니다. 단순한 방식은 파일 전체를 디스크에서 메모리로 읽어 들인 뒤 쓰는 것입니다. 4GB 모델이면 4GB가 다 복사될 때까지 기다리고, 메모리도 곧바로 많이 씁니다.
메모리 매핑은 파일을 복사하지 않고 이미 메모리에 있는 것처럼 다루게 합니다. 한꺼번에 올리는 대신 실제로 필요한 부분만 필요한 때에 읽습니다. 두꺼운 책 전체를 복사한 뒤에야 첫 쪽을 읽는 것이 느린 방식이고, 책을 탁자에 둔 채 필요한 쪽만 펴 보는 것이 메모리 매핑입니다.
| 방식 | 시작 | 메모리 |
|---|---|---|
| 메모리 매핑 없음 | 4GB를 모두 복사한 뒤 시작해 느림 | 곧바로 많이 사용 |
| 메모리 매핑(GGUF) | 즉시 시작하고 필요한 부분만 가져옴 | 효율적으로 사용 |
GGUF는 이 방식과 잘 맞도록 설계되었습니다. 텐서가 파일 안에 깔끔하고 순서 있게 배치되어 있어서 프로그램이 필요한 텐서로 곧장 건너뛰어 직접 읽을 수 있습니다. 앞 소절의 Tensor info 목차가 바로 그 위치 정보 역할을 합니다.
고객이 "모델이 켜지는 데 오래 걸린다"고 하면 포맷이 mmap을 지원하는지, 디스크가 느린 환경은 아닌지 먼저 구분합니다.
10.9.5 크로스 플랫폼과 확장성
GGUF가 널리 쓰이는 이유가 두 가지 더 있습니다.
- 크로스 플랫폼: 같은 GGUF 파일이 Windows, macOS, Linux와 서로 다른 프로세서에서 같게 동작합니다. 시스템마다 다른 파일이 필요 없고 하나를 받으면 어디서든 돌아갑니다.
- 확장성: 이전 파일을 깨지 않고 새 정보를 더하기 쉽습니다. 메타데이터가 단순한 키-값 쌍이므로 새 종류의 모델에 새 설정이 필요하면 키-값 쌍을 하나 더하면 됩니다. 구 프로그램은 파일을 계속 읽고 신 프로그램은 새 키를 읽습니다. 이것이 GGML이 가졌던 약점이며 GGUF가 고친 지점입니다.
실제로는 GGUF가 llama.cpp와 그 위에 만들어진 도구들이 쓰는 포맷입니다. llama.cpp는 노트북 같은 일반 컴퓨터의 CPU나 GPU에서 LLM을 효율적으로 돌리려고 작성된 오픈소스 프로그램으로, 빠르고 가볍고 GGUF 포맷의 모델을 읽습니다(10.10 참조). 그 위의 도구는 둘입니다.
| 계층 | 구성 | 역할 |
|---|---|---|
| 친근한 도구 | Ollama, LM Studio | Ollama는 간단한 명령으로 모델을 받아 로컬에서 돌립니다(10.11 참조). LM Studio는 화면에서 모델을 검색하고 GGUF 파일을 받아 대화하는 데스크톱 앱입니다 |
| 실행 엔진 | llama.cpp | 모델을 효율적으로 실행 |
| 파일 | .gguf |
가중치 + 토크나이저 + 메타데이터 |
flowchart TD
    O[Ollama] --> L[llama.cpp]
    M[LM Studio] --> L
    L --> G[".gguf 파일<br/>가중치 + 토크나이저 + 메타데이터"]
그림 10.9.5 — Ollama와 LM Studio는 llama.cpp 위에 있고, 모두 같은 GGUF 파일을 읽습니다.
어느 도구든 흐름은 같습니다. 원하는 모델과 양자화 수준의 .gguf 파일 하나를 받으면 도구가 메모리 매핑으로 열어 한 파일에서 가중치·토크나이저·메타데이터를 읽고 대화가 시작됩니다. 이렇게 로컬에서 돌리는 모델은 노트북이나 폰에 들어갈 만큼 작은 소형 언어 모델(SLM)인 경우가 많습니다.
FAQ의 질문들도 같은 구조로 풀립니다. 토크나이저 파일이 따로 필요 없는 이유는 어휘와 규칙이 파일 안에 있기 때문이고, 양자화된 GGUF의 답이 약간 나쁜 이유는 숫자가 덜 정확해서이며 대신 모델이 훨씬 작고 빠릅니다. Ollama와 LM Studio가 모두 GGUF를 쓰는 것은 둘 다 llama.cpp 기반 엔진을 쓰기 때문입니다. LM Studio는 Apple Silicon에서 MLX 엔진도 함께 제공합니다.
로컬에서 모델을 돌리고 싶다는 고객에게는 먼저 ".gguf 파일 하나를 받을 수 있는 모델인가"를 확인하고, 그 파일의 Q 수준을 메모리에 맞춰 정합니다.
10.10 llama.cpp
원문: How does llama.cpp run LLMs on everyday hardware?
GGUF(10.9)가 모델을 담는 파일이라면 llama.cpp는 그 파일을 읽어 실제로 답을 만들어 내는 실행 엔진입니다. 이 절은 큰 모델을 일반 노트북에서 돌리기 위해 이 엔진이 쓰는 기법과 프롬프트 하나가 지나가는 전체 경로를 다룹니다. 서술은 2026년 7월 글 기준입니다.
10.10.1 모델이 너무 커서 안 들어가는 문제
llama.cpp는 이름 그대로 llama + .cpp입니다. llama는 Meta가 처음 공개한 LLaMA 모델 계열에서 왔고, .cpp는 C++ 프로그램의 파일 확장자입니다. 주로 C와 C++로 작성되어 사용자의 컴퓨터에서 LLM을 돌리는 작고 빠른 엔진이며, 데이터센터의 거대한 서버가 필요 없습니다. Georgi Gerganov가 2023년 3월에 만들었고, 처음 목표는 특수 하드웨어 없이 일반 프로세서만으로 Apple Mac에서 Meta의 LLaMA 모델을 돌리는 것이었습니다. 원문은 GitHub 스타가 12만 개를 넘는 가장 인기 있는 오픈소스 프로젝트의 하나로 소개하며, 이 수치는 2026년 7월 글 기준입니다.
LLM이 퍼졌을 때 걸림돌은 비싼 장비였습니다. 강력한 그래픽 카드와 막대한 메모리를 가진 컴퓨터가 필요해 대부분 사람은 회사 서버에 인터넷으로 문장을 보내 모델을 쓸 수밖에 없었고, 거기서 세 가지 문제가 생겼습니다.
- 비용: 강력한 서버를 빌리는 데 돈이 많이 듭니다.
- 프라이버시: 사적인 문장이 자기 기기를 떠나야 합니다.
- 의존: 인터넷이 없으면 아무것도 되지 않습니다.
llama.cpp의 발상은 이미 가진 노트북, 휴대폰, 저렴한 미니 컴퓨터 같은 일상 하드웨어(데이터센터용이 아닌 일반 기기)에서 모델을 직접 돌리는 것이었습니다. 클라우드와 온디바이스 배포 중 무엇을 고를지는 별도의 결정입니다.
크기 문제는 숫자로 드러납니다. LLM은 방대한 텍스트를 읽고 언어의 패턴을 학습해 다음 단어를 추측하는 모델이며, 안에 있는 수십억 개의 학습된 숫자가 가중치이자 모델의 지식 전부입니다. 모델 크기는 파라미터 수로 재며 70억 개면 7B로 씁니다. 가중치 하나는 보통 2바이트나 4바이트를 차지하므로, 2바이트일 때 7B 모델은 가중치만 담는 데 약 14GB(7×10⁹ × 2바이트)가 필요합니다. 일반 노트북의 전체 메모리는 8GB나 16GB인 경우가 많아, 가중치만으로도 편하게 들어가지 않고 다른 용도의 여유도 필요합니다. 이것이 일반인이 모델을 돌리지 못하게 한 벽입니다.
고객이 "노트북에서 7B 모델을 돌리고 싶다"고 하면 파라미터 수 × 바이트 수를 먼저 계산해 메모리 총량과 비교합니다. 8GB 기기에서 16비트 7B는 이미 불가능한 선택입니다.
10.10.2 양자화·GGUF·메모리 매핑
첫 번째 해법은 양자화로, 각 가중치를 더 적은 비트로 저장해 모델 전체가 차지하는 메모리를 줄입니다. 16비트로 저장되던 가중치를 4비트로 저장하면 4배 작습니다. llama.cpp는 숫자를 마구 자르지 않고 가중치를 작은 블록(가중치 묶음) 단위로 다룹니다. 블록마다 가장 큰 가중치를 찾아 공유 스케일 팩터(블록 안 값이 얼마나 큰지 기록한 숫자 하나)를 만들고, 블록의 모든 가중치를 4비트의 작은 값으로 줄입니다. 쓸 때는 작은 값에 스케일을 곱해 원래 크기에 가깝게 되돌립니다.
원문의 예시 블록으로 직접 재계산하면 다음과 같습니다. 가장 큰 가중치 0.92를 4비트 범위(-8~7)의 최댓값 7에 대응시켜 스케일은 0.92 / 7 ≈ 0.13입니다.
| 원래 가중치 | 정수 값(÷0.13 반올림) | 복원(정수 × 0.13) | 오차 |
|---|---|---|---|
| 0.92 | 7 | 0.91 | 0.01 |
| -0.31 | -2 | -0.26 | 0.05 |
| 0.78 | 6 | 0.78 | 0.00 |
| -0.55 | -4 | -0.52 | 0.03 |
| 0.12 | 1 | 0.13 | 0.01 |
복원값이 정확히 같지는 않으며, 이 차이가 양자화가 치르는 정밀도입니다. 모델은 훨씬 작아지고 답은 거의 그대로입니다. 7B 모델이 약 14GB에서 4비트로 약 4GB가 되어 약 70% 작아지는 계산은 맞고(1 − 4/14 ≈ 71%), 일반 노트북에 들어갑니다. 양자화 일반론은 10.8을 참조합니다.
Q4_K_M 같은 이름은 세 조각으로 읽습니다.
| 조각 | 의미 |
|---|---|
| Q4 | 가중치를 약 4비트로 저장. 작은 숫자일수록 파일이 작음. Q8은 약 8비트로 더 정밀하고 더 큼 |
| K | llama.cpp와 함께 나온 K-quant 방식. 블록마다 스케일 팩터를 두면 그 숫자도 공간을 차지하므로, 작은 블록 여러 개를 256개 가중치의 슈퍼 블록으로 묶어 슈퍼 블록이 주 스케일 하나를 갖고 안쪽 블록은 그 값에서 작은 조정만 저장함. 기본급 하나를 정하고 사람마다 가감만 적는 회사에 비유됨 |
| M | medium. 4비트 기반 위에 얼마나 많은 부분에 비트를 더 주느냐를 뜻함 |
M의 의미는 이렇습니다. 가중치는 텐서라는 큰 숫자 표에 담기고, 일부 텐서는 양자화에 민감해 줄이면 품질이 더 나빠집니다. Q4_K_M에서는 그 민감한 텐서를 6비트로, 나머지를 4비트로 저장해 파일 크기를 조금만 늘리고 품질을 더 얻습니다. 다른 선택인 S(small)는 모든 것을 4비트로 두어 파일이 조금 더 작고 대체로 정확도가 조금 낮습니다. Q4_K_M이 가장 인기 있는 것은 작으면서 품질이 원본에 아주 가깝기 때문이며, 일상 작업에서는 품질 저하를 거의 느끼지 못합니다.
양자화된 모델을 담는 상자가 GGUF 파일입니다. GGML(같은 저자가 만든, llama.cpp가 숫자 계산에 쓰는 작은 수학 라이브러리)에서 도는 모델을 저장하는 포맷으로 확장하기 어려웠던 옛 포맷들을 대체했습니다. 파일 하나에 양자화된 가중치, 모델이 어떻게 만들어졌는지를 설명하는 아키텍처 정보, 텍스트를 조각으로 나누는 토크나이저, 작은 가중치를 어떻게 읽을지 알려 주는 양자화 설정이 모두 들어 있어 llama.cpp가 흩어진 파일을 찾아다니지 않습니다(10.9 참조).
작은 파일이라도 수 GB를 디스크에서 메모리로 올리는 일은 느립니다. 일반적으로는 프로그램이 느린 디스크에서 빠른 메모리로 파일 전체를 복사합니다. **메모리 매핑(mmap)**은 디스크의 파일을 이미 메모리에 있는 것처럼 다루도록 운영체제에 요청하고, 시스템이 실제로 필요한 부분만 필요한 때에 불러옵니다. 이점은 두 가지입니다.
- 모델이 거의 즉시 사용 가능해집니다. 전체 파일이 올라오기를 기다리지 않고 바로 일을 시작합니다.
- 같은 모델을 프로그램 여러 개가 열면 각자 사본을 두지 않고 메모리의 같은 데이터를 공유할 수 있습니다.
고객에게 모델을 어느 파일로 배포할지 정할 때는 이 세 가지(양자화, 단일 파일, mmap)가 한 묶음으로 작동한다는 점을 설명합니다. 하나만 빠져도 노트북에서의 체감이 달라집니다.
10.10.3 CPU 속도 끌어내기
모델이 들어가고 빨리 로딩되어도 단어 하나마다 수십억 번의 곱셈을 해야 하며, 일반 프로세서에서 이를 빠르게 만들려고 llama.cpp는 SIMD(Single Instruction, Multiple Data)를 씁니다. 같은 연산을 여러 숫자에 동시에 적용하는 방식입니다. 숫자 8쌍을 곱해야 할 때 단순한 프로그램은 8단계로 하나씩 하지만, SIMD가 있으면 CPU가 한 단계에 8쌍을 모두 처리합니다.
| 칩 | SIMD 명령어 집합 |
|---|---|
| Intel·AMD | AVX, AVX2, AVX512 |
| Apple·ARM | NEON |
llama.cpp는 빠른 C와 C++로 작성되었고 CPU가 지원하는 집합에 맞게 세심하게 조정되어 있습니다. 이 튜닝 덕분에 그래픽 카드 없는 일반 CPU에서도 쓸 만한 속도가 나옵니다. 이 문제를 처음부터 한 가지 일에 맞춰 설계한 칩의 접근이 LPU이며(10.1.4 참조), 범용 CPU에서 짜내는 llama.cpp와 대조됩니다.
GPU가 없다는 고객 환경이라면 CPU가 AVX2를 지원하는지, Mac이면 NEON 경로를 쓰는지가 첫 점검 항목입니다. GPU가 없다는 사실만으로 로컬 실행을 포기하게 하지 않습니다.
10.10.4 GPU와 일 나누기
많은 일반 컴퓨터에는 GPU(작은 일꾼 여러 명이 동시에 계산하는 큰 팀)도 있어 LLM의 수학에 알맞습니다. 그러나 작은 GPU는 모델 전체를 담을 메모리가 없을 수 있어, llama.cpp는 모델을 레이어(모델 처리의 한 단계이며 모델은 여러 레이어를 쌓은 것)로 나누고 GPU에 몇 개를 둘지 고르게 합니다. 이 값이 gpu-layers 설정입니다. GPU에 더 많은 레이어를 옮길수록 빨라지며, GPU에 여유가 있는 범위까지입니다. 들어가지 않는 레이어는 CPU에 남습니다.
flowchart TD
    M["하나의 LLM = 여러 레이어<br/>Layer 1, 2, 3 ... N"] --> G["GPU<br/>GPU 메모리에 들어가는 레이어, 빠름"]
    M --> C["CPU<br/>나머지 레이어, 항상 있음"]
    G --> O["레이어가 순서대로 협력해 다음 단어 생성"]
    C --> O
그림 10.10.4 — 모델을 레이어로 잘라 일부는 GPU에, 나머지는 CPU에 두고 함께 다음 토큰을 만듭니다.
이 유연성 덕에 llama.cpp는 다양한 기기에서 돕니다. Apple의 Metal, NVIDIA의 CUDA, 크로스 플랫폼 Vulkan, AMD의 ROCm 등을 지원하고, GPU가 아예 없으면 CPU로 돌아가 실행합니다. FAQ의 질문, 즉 몇 레이어를 GPU에 둘지는 GPU 메모리가 담을 수 있는 만큼 최대한이라는 답으로 정리됩니다.
고객 기기에서 gpu-layers를 한 번에 최댓값으로 주지 말고 늘려 가며 속도를 재고, 메모리 부족 오류가 나는 직전 값을 고릅니다.
10.10.5 프롬프트 실행 전체 여정
질문이 답이 되기까지의 경로를 여덟 단계로 따라갑니다.
- llama.cpp를 시작하고 GGUF 파일을 지정합니다. 프로그램이 메모리 매핑으로 파일을 읽어 거의 즉시 준비됩니다.
- 프롬프트(질문이나 지시)를 일반 텍스트로 입력합니다.
- 토크나이저가 텍스트를 토큰(단어나 단어의 일부이며 모델이 다룰 수 있는 숫자로 바뀐 조각)으로 쪼갭니다.
- 토큰이 모델의 레이어를 흐릅니다. 각 레이어는 양자화된 가중치로 곱셈과 덧셈을 하며, 선택한 대로 CPU와 GPU가 나눕니다.
- 모델이 가능한 모든 다음 토큰에 점수를 냅니다. 샘플링 단계가 Top-k, Top-p 같은 설정(2.12 참조)에 따라 이 점수에서 토큰 하나를 고릅니다.
- 고른 토큰이 텍스트로 바뀌어 곧바로 화면에 보입니다. 이 즉시 표시가 스트리밍이며, 답이 단어 단위로 나타나는 이유입니다.
- 빠르게 유지하려고 llama.cpp는 진행 상황을 KV 캐시에 저장합니다. 앞선 토큰에서 이미 한 계산의 기억이라 새 단어마다 다시 계산하지 않습니다(10.3 참조).
- 새 토큰이 입력으로 다시 들어가고 답이 끝날 때까지 한 토큰씩 순환합니다.
flowchart TD
    A["디스크의 GGUF 파일"] -->|"mmap 즉시 로딩"| B["프롬프트 텍스트"]
    B -->|"토크나이저"| C["토큰이 레이어를 통과<br/>양자화 가중치, CPU+GPU 분담"]
    C --> D["다음 토큰 후보별 점수"]
    D -->|"샘플링"| E["토큰을 텍스트로 변환, 스트리밍"]
    E -->|"KV 캐시에 저장, 다시 입력"| C
    E --> F["완성된 답"]
그림 10.10.5 — 텍스트가 토큰이 되어 레이어를 지나 토큰 하나가 나오고, 그 토큰이 되먹임되며 답이 끝날 때까지 반복됩니다.
llama.cpp는 Ollama와 LM Studio처럼 사람들이 자기 컴퓨터에서 챗봇을 돌리게 하는 인기 로컬 AI 도구의 조용한 엔진입니다. 즉 Ollama는 llama.cpp 위에 만들어졌고(최신 버전은 일부 모델에 자체 엔진을 병행합니다), 실제로 모델을 돌리는 일은 llama.cpp가 합니다(10.11 참조). Llama, Mistral, Qwen, Gemma 같은 폭넓은 최신 모델을 지원하고 Windows, Mac, Linux는 물론 휴대폰과 소형 싱글 보드 컴퓨터에서도 돕니다. 지원 모델 목록은 2026년 7월 글 기준이며 시간이 지나면 달라집니다.
처음에는 Meta의 LLaMA만 Mac에서 돌리려던 프로젝트가 지금은 다양한 모델을 돌리므로, "Llama 전용 아니냐"는 고객 질문에는 지원 목록을 확인해 답합니다.
대가도 분명합니다. 강하게 양자화된 모델은 작고 빠르지만 답이 원본보다 약간 덜 정확할 수 있습니다. 용도에 맞게 Q4_K_M 같은 균형점을 고릅니다. 고객 기기의 사양, 허용 품질, 필요한 속도 세 가지로 Q 수준과 gpu-layers를 함께 정하는 것이 이 엔진을 현장에 올리는 판단의 전부입니다.
10.11 Ollama
Ollama는 llama.cpp(10.10) 위에서 모델 다운로드, 저장, 실행, API 노출을 한 명령으로 묶은 도구입니다. 이 절은 명령 한 줄 뒤에서 벌어지는 일과 한계를 다루며, 서술은 2026년 10월 글 기준입니다.
10.11.1 클라이언트-서버 구조
웹사이트에서 LLM을 쓸 때 모델은 내 컴퓨터가 아니라 회사의 큰 컴퓨터에서 돕니다. 로컬 실행은 모델이 내 컴퓨터에서 돌고 메시지가 기기를 떠나지 않는 것입니다. 온라인 LLM이 식당 주문이라면 로컬 실행은 집밥입니다. 주방과 재료가 필요하지만 모든 것을 직접 통제하고, 남이 무엇을 먹는지 모르며, 식당이 닫혀도 됩니다. 이점은 네 가지입니다.
- 프라이버시: 데이터가 기기에 머뭅니다.
- 오프라인 동작: 모델을 받은 뒤에는 인터넷이 필요 없습니다.
- 메시지당 비용 없음: 요청마다 돈을 내지 않습니다.
- 완전한 통제: 어떤 모델을 어떻게 돌릴지 직접 고릅니다.
예전에는 로컬 실행이 어려웠습니다. 맞는 모델 파일을 찾고, 라이브러리를 여럿 설치하고, GPU를 설정하고, 코드를 써야 했습니다. Ollama는 LLM을 내 컴퓨터에서 쉽게 내려받고 실행하고 관리하게 하는 오픈소스 도구이며, 앱 스토어가 앱에 하는 일을 LLM에 합니다. 설치 후 ollama run llama3.2 한 줄이면 대화가 시작됩니다. ollama run은 모델을 실행하라는 명령, llama3.2는 모델 이름이며, 모델이 컴퓨터에 없으면 먼저 내려받고 터미널에서 채팅을 엽니다. macOS, Windows, Linux에서 동작합니다.
명령 뒤의 구조는 두 부분입니다.
- 서버: 백그라운드에서 돌며 모델을 관리하고 메모리에 올리고 실행합니다.
ollama serve로 시작하며 데스크톱 앱은 자동으로 시작해 줍니다. - 클라이언트: 서버에 요청을 보내는 쪽입니다. 터미널의
ollama명령도 클라이언트이고 다른 앱도 클라이언트가 될 수 있습니다.
둘은 HTTP로 통신하며 서버는 http://localhost:11434에서 기다립니다. localhost는 "이 같은 컴퓨터"를, 11434는 서버가 요청을 기다리는 문 번호인 포트를 뜻합니다.
flowchart TD
    A["ollama CLI (클라이언트)"] --> H[HTTP 요청]
    B["Python 앱 (클라이언트)"] --> H
    C["채팅 앱 (클라이언트)"] --> H
    H --> S["Ollama 서버 (포트 11434)<br/>모델 관리, 메모리 로드, 추론 엔진 실행"]
    S --> P["CPU / GPU"]
그림 10.11.1 — 여러 클라이언트가 하나의 Ollama 서버를 공유하며, 모델은 한곳에만 있습니다.
서버가 하나이고 모델이 사는 곳이 하나이므로 컴퓨터의 모든 앱이 같은 서버를 씁니다. 로컬 모델을 사내 도구에 붙이는 고객이라면 클라이언트가 모두 같은 포트의 서버를 가리키는지, 그 포트가 외부에 노출되지 않는지부터 확인합니다.
10.11.2 모델 다운로드와 저장
모델은 몇 개의 큰 수로 표현되므로 크기가 문제입니다. LLM은 수십억 개의 가중치로 이루어지고 보통 가중치당 16비트(2바이트)로 저장됩니다. 80억 가중치 모델은 8 billion × 2 bytes = 16GB입니다. 노트북 메모리가 총 8GB나 16GB인 경우가 많고 운영체제와 다른 앱도 써야 하므로 중형 모델도 가중치만으로 벅찹니다. 토큰 하나를 생성할 때마다 모든 가중치를 읽어야 하므로 파일이 클수록 응답이 느립니다. 그래서 숫자를 줄입니다.
양자화는 가중치를 더 적은 비트, 예컨대 16비트 대신 4비트로 저장하는 것이며 49.97을 50으로 적는 반올림과 같습니다. 같은 80억 모델을 python3 -I로 재계산하면 다음과 같습니다.
| 정밀도 | 계산 | 크기 |
|---|---|---|
| 16비트 | 80억 × 2바이트 | 16GB |
| 4비트 | 80억 × 0.5바이트 | 4GB(실제로는 조금 더) |
4비트 버전은 약 4배 작아 노트북에 쉽게 들어가고 토큰마다 읽을 데이터가 적어 더 빠르며, 답의 품질은 조금만 떨어집니다. Ollama가 기본으로 내려받는 모델 대부분은 이미 4비트 안팎으로 양자화되어 있습니다(10.8 참조).
줄어든 모델은 GGUF 포맷으로 저장됩니다. GGUF는 GGML(LLM을 효율적으로 돌리는 라이브러리)에서 도는 모델을 저장하는 포맷이며, 양자화된 가중치, 레이어 수 같은 아키텍처 세부, 텍스트를 토큰으로 쪼개고 되돌리는 토크나이저를 한 파일에 담습니다(10.9 참조). GGUF는 llama.cpp 프로젝트에서 나왔고, llama.cpp는 강력한 GPU가 없는 컴퓨터를 포함해 일반 컴퓨터에서 LLM을 효율적으로 돌리는 C/C++ 오픈소스 프로그램입니다. Ollama는 llama.cpp와 그 기반 라이브러리 GGML 위에 만들어졌고, 최신 버전은 일부 모델에 대해 같은 GGML 라이브러리 위에 만든 자체 엔진도 갖고 있습니다. 모델을 돌려 답을 내는 프로그램이 추론 엔진이며 실제 무거운 수학은 이 엔진이 하고, Ollama는 나머지 모두를 처리하는 상위 계층입니다. 엔진 세부는 2026년 10월 글 기준입니다.
내려받는 쪽은 이렇게 움직입니다. Ollama는 ollama.com에 온라인 모델 라이브러리가 있고, 모델마다 이름과 태그(llama3.2:3b, qwen2.5:7b처럼 보통 크기나 버전을 나타냄)가 있습니다. 태그를 주지 않으면 기본 태그 latest를 씁니다. 실행 없이 받기만 하려면 ollama pull llama3.2를 쓰며, 받은 모델을 컴퓨터에 저장해 둡니다.
Ollama에서 모델은 이름 붙은 파일 하나가 아니라 레이어(저장 조각)의 집합입니다. 큰 GGUF 가중치 파일이 레이어 하나이고, 채팅 템플릿, 기본 설정, 라이선스 같은 작은 레이어가 따로 있습니다. 어떤 레이어가 이 모델을 이루는지 적은 목록이 매니페스트 파일입니다. 각 레이어는 내용에서 계산한 지문인 해시로 이름 붙여 저장되고, 같은 내용은 항상 같은 지문이 나옵니다. 그래서 시스템 지시만 다른 사용자 지정 버전 둘을 만들어도 가중치 레이어의 해시가 같아 한 번만 저장되고 작은 레이어만 따로 저장되므로 디스크가 크게 절약됩니다. Mac에서는 홈 폴더의 .ollama/models에 있습니다.
| 명령 | 동작 |
|---|---|
ollama list |
디스크에 받아 둔 모델 목록 |
ollama ps |
지금 메모리에 로드된 모델 |
ollama rm llama3.2 |
디스크에서 모델 삭제 |
디스크가 모자란 고객에게는 list로 받은 모델을 확인해 쓰지 않는 것을 rm으로 지우게 하며, 같은 기반 모델에서 파생한 사용자 지정 모델은 가중치를 공유하므로 용량 걱정을 덜어 줍니다.
10.11.3 CPU·GPU 실행
ollama run llama3.2를 입력하고 질문하면 다음 여덟 단계가 일어납니다.
- 클라이언트가 서버에 접속합니다.
ollama명령이localhost:11434로 요청을 보냅니다. - 서버가 모델이 디스크에 있는지 확인합니다. 없으면 인터넷의 Ollama 모델 라이브러리에서 내려받습니다.
- 서버가 모델을 메모리에 올립니다. GGUF 파일을 읽어 가중치를 GPU 메모리, 일반 메모리, 또는 둘의 혼합에 놓습니다. 몇 초가 걸릴 수 있습니다.
- 프롬프트를 준비합니다. 모델마다 시스템 지시, 사용자 메시지, 어시스턴트 답이 시작되는 위치를 알리는 표식이 있는 특정 배치를 기대하며, 이 배치가 채팅 템플릿입니다. Ollama가 모델에 맞는 템플릿으로 메시지를 자동으로 감쌉니다.
- 프롬프트를 토큰으로 바꿉니다. 토크나이저가 텍스트를 토큰으로 쪼개고 각 토큰은 숫자가 됩니다.
- 모델이 답을 생성합니다. 엔진이 다음 토큰을 예측하고 텍스트에 붙이는 일을 답이 끝날 때까지 반복합니다.
- 답을 스트리밍합니다. 토큰이 준비되는 대로 클라이언트에 보내므로 단어가 하나씩 나타납니다.
- 모델이 한동안 메모리에 남습니다. 기본값은 5분입니다. 그 안에 다시 질문하면 3단계를 건너뛰어 답이 즉시 시작되고, 5분 동안 아무 일이 없으면 언로드해 메모리를 비웁니다. 이 시간은
keep_alive설정으로 바꿉니다.
FAQ의 "첫 응답이 왜 더 느린가"의 답이 바로 3단계와 8단계입니다. 첫 요청은 디스크의 모델을 메모리로 올려야 하는 몇 초가 들고, 이후 5분간은 그 단계를 건너뜁니다. 고객이 "아침 첫 질문만 느리다"고 하면 keep_alive를 늘려 모델을 계속 로드해 두는 것이 해법이지만, 그만큼 메모리를 오래 점유하는 대가가 있습니다.
실제 계산은 CPU나 GPU에서 일어납니다. GPU는 수천 개 계산을 동시에 하므로 LLM에 알맞고 훨씬 빠릅니다. Ollama는 시작할 때 GPU를 확인하고 NVIDIA GPU, 많은 AMD GPU, Mac의 Apple Silicon 칩을 지원합니다. Apple Silicon에서는 CPU와 GPU가 같은 메모리를 공유해 LLM에 유리합니다. 여기서 레이어는 위의 저장 레이어가 아니라 모델 계산의 한 단계이며, 입력이 첫 레이어, 둘째 레이어, ...를 지나 마지막까지 갑니다. Ollama는 이 모델 레이어가 GPU 메모리에 몇 개 들어가는지 정합니다.
| 상황 | 동작 |
|---|---|
| 모델 전체가 들어감 | 모든 레이어가 GPU에서 돌아 가장 빠름 |
| 일부만 들어감 | 일부는 GPU, 나머지는 일반 메모리에서 CPU로 실행(부분 오프로딩) |
| 쓸 GPU가 없음 | 전부 CPU에서 실행 |
32개 레이어 모델에서 GPU가 20개를 담을 수 있다면 Layer 1~20은 GPU(빠름), 21~32는 CPU(느림)입니다. 아무것도 설정하지 않아도 가진 하드웨어를 최대한 쓰며, ollama ps로 로드된 모델이 GPU와 CPU에 각각 얼마나 올라갔는지 볼 수 있습니다. 메모리는 가중치뿐 아니라 대화 자체에도 듭니다. 모델이 더 많은 텍스트를 읽을수록 앞선 토큰에 대한 작업을 KV 캐시로 메모리에 저장하며, 대화가 길수록 메모리가 더 필요합니다(10.3 참조). 모델이 한 번에 볼 수 있는 최대 텍스트량이 컨텍스트 길이이고 클수록 메모리를 더 씁니다.
고객이 "분명히 모델이 들어가는데 느리다"고 하면 ollama ps로 GPU 비율을 보고 부분 오프로딩인지부터 가립니다. GPU가 없다는 FAQ의 경우도 동작은 하지만 응답이 느립니다.
10.11.4 Modelfile
기존 모델의 사용자 지정 버전, 예컨대 항상 친절한 선생님처럼 답하고 무작위성이 낮은 버전은 Modelfile로 만듭니다. Modelfile은 기존 모델에서 사용자 지정 모델을 만드는 방법을 적은 작은 텍스트 파일, 즉 레시피입니다. 어떤 모델에서 시작해 무엇을 바꿀지 적습니다. 원문의 예시는 이렇습니다.
FROM llama3.2

PARAMETER temperature 0.3
PARAMETER num_ctx 4096

SYSTEM """
You are a friendly teacher. Explain everything in simple words.
"""| 지시어 | 의미 |
|---|---|
FROM llama3.2 |
시작할 기반 모델 |
PARAMETER temperature 0.3 |
온도(무작위성 조절, 2.11 참조)를 0.3으로. 값이 낮을수록 더 집중되고 예측 가능한 답 |
PARAMETER num_ctx 4096 |
컨텍스트 길이를 4096토큰으로 |
SYSTEM |
모든 대화 전에 모델이 보는 시스템 메시지 |
ollama create teacher -f Modelfile이 레시피로 teacher라는 새 모델을 만들고, ollama run teacher가 그 모델과 대화를 시작합니다. 새 가중치 사본은 만들어지지 않습니다. teacher는 llama3.2와 같은 가중치 레이어를 가리키고 작은 설정 레이어만 새로 생기며, 이는 앞서의 레이어 공유와 같은 원리입니다(10.11.2 참조).
Modelfile에 temperature와 SYSTEM을 포함해 두면 고객 팀이 같은 설정으로 같은 동작을 재현하므로, 현장에서는 구두 합의된 프롬프트 지침을 Modelfile로 옮겨 파일 하나로 버전 관리하게 합니다. 어느 모델에서 파생했는지는 FROM으로 남습니다.
10.11.5 API 코드 호출
서버가 HTTP로 말하므로 어떤 프로그램이든 API로 Ollama를 쓸 수 있습니다. 원문의 Python 예시는 requests.post("http://localhost:11434/api/chat", json={...})로 채팅 요청을 보냅니다.
| 필드 | 의미 |
|---|---|
요청 주소 /api/chat |
로컬 Ollama 서버의 채팅 엔드포인트 |
model |
사용할 모델("llama3.2") |
messages |
대화. 각 메시지에 role(user, assistant 등)과 content |
stream: False |
답 전체를 한 번에 받음. 기본은 터미널에서 보듯 조각 단위 스트리밍 |
마지막에 response.json()["message"]["content"]를 출력하면 하늘이 파란 이유에 대한 모델의 답이 나옵니다. Ollama는 OpenAI API와 같은 요청 형식을 따르는 주소 http://localhost:11434/v1도 제공하므로, OpenAI용으로 만든 많은 앱과 라이브러리가 요청 보낼 주소만 바꾸면 로컬 Ollama 모델을 쓸 수 있습니다. 호환 범위의 세부는 2026년 10월 글 기준이며 모든 기능이 같지는 않을 수 있습니다.
클라우드 서비스와 Ollama는 다음처럼 갈립니다.
| 항목 | 클라우드 LLM 서비스 | Ollama(로컬) |
|---|---|---|
| 모델이 도는 곳 | 회사 서버 | 내 컴퓨터 |
| 프라이버시 | 데이터를 인터넷으로 보냄 | 데이터가 기기에 머묾 |
| 인터넷 | 필요 | 모델 내려받을 때만 |
| 비용 | 사용량 과금이나 구독 | 무료, 단 자체 하드웨어 필요 |
| 모델 크기 | 아주 큰 모델 | 컴퓨터 메모리에 제한 |
| 속도 | 빠르고 강력한 서버 | CPU와 GPU에 따라 다름 |
| 설정 | 계정과 API 키 | Ollama 설치와 모델 pull |
잘 맞는 경우는 개인 노트나 사내 문서처럼 프라이버시가 필요할 때, 요청마다 돈을 내지 않고 앱을 만들고 시험할 때, 오프라인으로 일해야 할 때, 여러 오픈 모델을 빠르게 써 볼 때입니다. 어려운 경우는 세 가지입니다. 가장 크고 똑똑한 모델은 대부분의 개인용 컴퓨터에 너무 크고, 메모리가 작거나 좋은 GPU가 없으면 응답이 느리며, 여러 사용자를 동시에 서빙해야 할 때 Ollama는 한 사람이나 한 기계의 작은 팀용으로 설계되었습니다. 많은 사용자를 서빙하려면 vLLM처럼 높은 트래픽을 위해 만든 도구가 낫습니다(10.12 참조). 개인용 컴퓨터에서는 대체로 작은 모델이 가장 알맞은 지점입니다.
PoC를 로컬로 시작한 고객이 "동시 사용자 수십 명으로 늘린다"고 하면 이 지점이 도구를 바꿀 신호입니다. 사용자 수, 허용 지연, 모델 크기 세 가지를 확인하고 Ollama에 머물지 서빙 엔진으로 옮길지 정합니다.
10.12 vLLM
많은 사용자를 한 GPU로 서빙할 때의 병목은 계산 속도가 아니라 KV 캐시 메모리입니다. vLLM은 페이지드 어텐션(10.4)과 연속 배칭(10.5)을 하나의 서빙 엔진으로 묶어 이 병목을 푸는 도구이며, 이 절은 그 통합과 도입 판단을 다룹니다. 서술은 2026년 6월 글 기준입니다.
10.12.1 KV 캐시가 GPU 메모리를 잡아먹는 문제
LLM 서빙은 여러 사용자가 동시에 질문을 보내고 답을 받도록 모델을 컴퓨터에서 돌리는 일입니다. 채팅 비서에 수천 명이 한꺼번에 접속하면 모든 질문이 모델에 도착하고 모두 빠른 답을 기대합니다. 요청을 받아 각각 모델에 돌리고 답을 돌려주는 소프트웨어가 서빙 엔진입니다. LLM은 GPU라는 특수 칩에서 도는데, GPU는 비싸고 메모리가 한정되어 있으므로 GPU 메모리를 낭비하면 서빙할 사용자가 줄고 비용이 오릅니다. 서빙의 목표는 한 GPU에서 가능한 한 많은 사용자를 가능한 한 빠르게 처리하는 것이며, vLLM은 이 목표를 위해 만들어졌습니다.
모델은 프롬프트를 토큰으로 쪼갠 뒤 두 단계로 일합니다. prefill은 첫 단어를 쓰기 전에 프롬프트 전체를 읽고 모든 토큰을 처리하는 단계이고, decode는 답을 토큰 하나씩 쓰는 단계입니다(10.2 참조). 두 단계 모두에서 모델은 토큰마다 내부 값을 계산해 저장하고, 그 저장소가 KV 캐시입니다. 토큰이 이전 문맥에서 어떤 의미인지 적은 작은 요약 노트가 토큰마다 한 세트씩 쌓인 것으로 이해하면 됩니다. decode에서 새 토큰을 쓰려면 앞선 모든 토큰의 노트가 필요하고, KV 캐시가 없으면 새 단어마다 모든 노트를 다시 계산해야 해서 지독하게 느려집니다. 노트를 한 번 저장해 재사용하는 덕에 긴 답이 빨리 나옵니다(10.3 참조).
핵심은 KV 캐시가 답과 함께 자란다는 점입니다.
| 시점 | 동작 | KV 캐시(노트 수) |
|---|---|---|
| prefill | "Tell me a joke" 4토큰 처리 | 4 |
| decode 1 | "Why" 생성 | 5 |
| decode 2 | "did" 생성 | 6 |
| decode 3 | "the" 생성 | 7 |
prefill은 프롬프트 토큰마다 노트를 한 번에 만들고, decode는 토큰이 하나 생길 때마다 노트 세트를 하나씩 더합니다. 답이 길수록 GPU 메모리의 KV 캐시가 커집니다.
모델 자체가 GPU 메모리의 큰 덩어리를 차지하고, 남은 메모리가 현재 서빙 중인 모든 요청의 KV 캐시를 담습니다. 따라서 KV 캐시 메모리가 동시에 몇 명을 서빙할지를 정합니다. 요청마다 자기 KV 캐시가 있고 답과 함께 자라므로, 많은 사용자를 서빙하면 모든 캐시가 같은 한정된 공간을 두고 다투며, 서빙의 진짜 병목은 수학 속도가 아니라 KV 캐시 메모리입니다. KV 캐시 압축 기법은 각 캐시를 작게 만들지만(10.1.1 참조), 아무리 작아져도 엔진은 그것을 잘 관리해야 합니다. KV 캐시 메모리를 잘 관리하면 더 많은 사용자를 서빙하고, 못 하면 GPU를 낭비합니다.
고객이 "GPU를 더 사야 하나"라고 물으면 연산 사용률이 아니라 KV 캐시에 쓸 수 있는 남은 메모리와 동시 요청 수를 먼저 봅니다.
단순한 서빙은 이 관리를 어떻게 하는지가 다음 문제입니다. 순진한 엔진은 답이 얼마나 길지 모르므로 안전하게 가능한 가장 긴 답을 담을 크고 연속적인 메모리 블록을 요청마다 미리 잡아 둡니다. 모델이 최대 2,000토큰까지 쓸 수 있다면 모델이 한 글자도 쓰기 전에 요청마다 2,000토큰 분량을 예약합니다. 대부분의 답은 짧습니다. 답이 50토큰이면 나머지 1,950토큰 분량은 예약된 채 아무 일도 하지 않습니다. 낭비에는 이름이 둘 있습니다.
- 과다 예약(over-reservation): 요청이 실제로 쓴 것보다 훨씬 많은 메모리를 예약한 상태입니다. 예약된 미사용 공간은 다른 요청에 줄 수 없습니다.
- 단편화(fragmentation): 빈 메모리가 쓸 수 없는 작은 조각으로 흩어진 상태입니다.
원문의 도식을 숫자로 풀어 python3 -I로 계산하면 이렇습니다. 요청 A, B, C가 각각 50, 120, 20토큰을 쓰고 모두 2,000토큰을 예약하면 예약 6,000, 실제 사용 190이어서 사용률은 약 3.2%, 낭비는 5,810(약 96.8%)입니다. 블록 사이 남은 틈은 작고 흩어져 새 요청을 담지 못하므로, 이론상 빈 메모리가 많아도 쓸 수 없습니다. 비싼 GPU를 사서 일부만 쓰게 됩니다.
10.12.2 PagedAttention 메모리 공유
vLLM은 높은 처리량(throughput), 즉 단위 시간에 끝내는 일의 양(초당 토큰과 요청 수)을 극대화하는 LLM 서빙 엔진이며, 두 아이디어를 함께 씁니다.
- PagedAttention: KV 캐시를 하나의 거대한 블록이 아니라 작은 고정 크기 블록으로 관리해 낭비를 없앱니다.
- 연속 배칭: 매 스텝 끝난 요청을 내보내고 새 요청을 들여 GPU를 계속 바쁘게 합니다.
PagedAttention은 운영체제가 메모리를 다루는 방식에서 빌려 온 아이디어입니다. 운영체제는 페이지라는 작은 고정 크기 조각으로 메모리를 관리하고, 프로그램이 더 필요하면 페이지를 하나 더 주며, 페이지가 서로 붙어 있을 필요가 없고 각 페이지의 위치를 작은 표로 기억합니다. vLLM도 KV 캐시 메모리를 토큰 수가 정해진(예: 16토큰) 작은 고정 크기 블록으로 나누고, 요청이 더 저장해야 하면 블록을 하나 더 주며, 어떤 블록이 어느 요청에 어떤 순서로 속하는지 블록 테이블에 기록합니다(10.4 참조).
- 요청이 들어와 답을 만들기 시작하면 vLLM은 16토큰 분량 블록 하나를 줍니다.
- 답이 16토큰을 넘어 첫 블록이 차면, 메모리의 빈 블록 어디든 하나를 더 줍니다. 첫 블록 옆일 필요가 없습니다.
- 답이 계속 자라는 동안 필요할 때만 블록을 하나씩 주고, 답이 끝나면 그 요청의 블록을 한꺼번에 해제해 즉시 다른 요청이 쓸 수 있게 합니다.
flowchart TD
    P["GPU 메모리: 같은 크기 블록의 풀 B1 ... B9"]
    P --> A["요청 A 블록 테이블: B1, B4, B7"]
    P --> B["요청 B 블록 테이블: B2, B3"]
    P --> C["요청 C 블록 테이블: B5"]
    P --> F["빈 블록: B6, B8, B9"]
그림 10.12.2 — 메모리는 같은 크기 블록의 공유 풀이고, 요청은 필요한 만큼의 블록만 풀 안 어디서든 받습니다.
이렇게 과다 예약이 사라집니다. 실제로 필요할 때만 블록을 할당하기 때문입니다. 단편화도 거의 없습니다. 모든 블록이 같은 크기라 빈 블록 어느 것이든 어느 요청에나 맞기 때문입니다. 앞의 세 요청을 16토큰 블록으로 나누면 각각 4, 8, 2블록(합 14블록, 224토큰 분량)이어서 사용 190 대비 낭비는 34토큰(약 15%)이고, 낭비가 요청당 마지막 블록의 끝부분에만 남습니다. 예약 방식의 약 96.8%와 대비됩니다.
블록 구조는 공짜 선물도 줍니다. 두 요청이 블록 테이블에서 같은 블록을 가리켜 각자 사본을 두지 않고 동일한 부분의 메모리를 공유합니다. 이득이 큰 경우는 둘입니다.
- 동일한 접두부(prefix): 많은 사용자의 요청이 "당신은 자동차 대리점의 공손한 고객 지원 담당자입니다" 같은 긴 시스템 지시로 시작합니다. 이 긴 시작은 모두에게 같으므로 vLLM은 그 KV 캐시를 한 번만 저장하고 모든 요청이 같은 블록을 가리키게 합니다. 같은 노트를 여러 번 저장하지 않습니다. 동일 접두부의 KV 캐시를 재사용하는 원리가 프롬프트 캐싱입니다(4.6 참조).
- 빔 서치(beam search): 모델이 여러 후보 답을 동시에 탐색하다 가장 좋은 것을 남기는 생성 방식입니다. 후보인 빔들은 시작이 같고 뒤에서야 갈라지므로, 공통 시작의 블록은 공유하고 갈라지는 지점부터만 별도 블록을 씁니다.
flowchart TD
    S["공유된 시작: B1, B2 (메모리에 한 벌)"] --> A["요청 A: B5 추가"]
    S --> B["요청 B: B6 추가"]
    S --> C["빔 C: B7 추가"]
그림 10.12.2b — 세 경로가 같은 두 블록(B1, B2)을 가리키고 각자 고유한 부분만 별도 블록을 추가합니다.
같은 시작을 세 번 저장하는 메모리를 아낀 셈이며, 낭비를 멈추는 데서 더 나아가 요청끼리 메모리를 나눠 같은 GPU에 더 많은 사용자를 담습니다. 에이전트 시스템처럼 같은 지시문을 매번 보내는 워크로드에서 가장 크게 작용합니다.
고객의 시스템 프롬프트가 수천 토큰으로 길고 모든 요청에 같다면, 접두부 공유로 얼마나 메모리가 절약되는지가 도입 효과를 가르는 첫 질문입니다.
10.12.3 연속 배칭
배칭은 여러 요청을 하나씩이 아니라 한꺼번에 돌리는 것이며, GPU는 여러 요청을 함께 처리할 때 훨씬 효율적이므로 GPU를 바쁘게 하고 높은 처리량을 얻는 수단입니다. 순진한 방식인 정적 배칭은 요청 묶음을 모아 함께 돌리고, 묶음 안의 모든 요청이 끝나야 다음 묶음을 시작합니다. 문제는 답의 길이가 요청마다 크게 다르다는 점입니다. 한 사용자의 답은 20토큰인데 다른 사용자의 답은 800토큰일 수 있고, 묶음이 함께 움직이므로 짧은 요청은 일찍 끝나도 긴 요청이 끝나기를 기다리며 놉니다. 끝난 요청의 GPU 슬롯이 할 일 없이 시간을 낭비합니다.
연속 배칭은 묶음 전체가 끝나기를 기다리지 않고 매 스텝마다 끝난 요청을 내보내고 대기 중인 새 요청을 들입니다. 요청이 끝나는 순간 vLLM이 그것을 빼고 대기열의 새 요청을 바로 그 자리에 넣어 GPU가 놀지 않습니다. decode가 토큰 하나씩 만드는 작은 스텝의 연속이므로, 매 스텝 vLLM이 방금 끝난 요청이 있는지 확인해 있으면 빼고 새 요청을 더하며, 묶음은 항상 일하는 요청으로 가득 찹니다(10.5 참조).
원문 도식(8스텝)을 표로 옮기면 차이가 보입니다.
| 스텝 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 |
|---|---|---|---|---|---|---|---|---|
| 정적: 슬롯 1 | A | A | A | 끝 | 놀음 | 놀음 | 놀음 | 놀음 |
| 정적: 슬롯 2 | B | B | B | B | B | B | B | 끝 |
| 연속: 슬롯 1 | A | A | A | C | C | C | D | D |
| 연속: 슬롯 2 | B | B | B | B | B | B | B | 끝 |
정적 배칭에서는 A가 일찍 끝났어도 슬롯 1이 B가 끝날 때까지 놉니다(이 도식에서 8슬롯-스텝 중 4가 낭비). 연속 배칭에서는 A가 끝나자 C가 들어오고 C가 끝나자 D가 들어와 슬롯이 낭비되지 않습니다.
연속 배칭과 PagedAttention은 서로 잘 맞습니다. PagedAttention이 끝난 요청의 블록을 즉시 풀어 주면 연속 배칭이 그 메모리와 그 슬롯을 곧바로 새 대기 요청에 씁니다. 둘이 함께 GPU 메모리와 GPU 연산을 모두 꽉 채웁니다.
고객의 트래픽에서 짧은 답과 긴 답이 섞여 있다면 정적 배칭의 낭비가 커지는 조건이므로, 응답 길이 분포를 로그로 먼저 확인합니다.
10.12.4 OpenAI 호환 API 서버
vLLM은 OpenAI 호환 API 서버로 실행되어 채팅 요청을 받고 모델의 답을 돌려줍니다. 이 점이 중요한 이유는 수많은 도구와 애플리케이션이 이미 OpenAI의 API와 통신하도록 작성되어 있기 때문입니다. vLLM이 같은 언어를 쓰면 코드를 다시 쓰지 않고 주소만 바꿔 기존 도구를 자기 vLLM 서버로 향하게 할 수 있습니다. 자기 GPU에서 자기 모델을 돌리면서 애플리케이션은 OpenAI와 말하던 방식 그대로 말합니다. FAQ의 질문, 곧 OpenAI API용으로 만든 앱을 다시 써야 하느냐는 물음의 답은 아니오입니다.
안쪽에는 높은 처리량의 엔진이 있고 바깥쪽에는 익숙하고 쓰기 쉬운 API가 있는 구조여서, 실제 프로젝트에서 도입하기 쉽다는 것이 원문의 평가입니다. 호환 범위의 세부는 2026년 6월 글 기준입니다.
고객이 이미 OpenAI SDK로 만든 앱을 가졌다면 전환 비용은 기본 URL(와 모델 이름) 변경 수준으로 시작하되, 쓰는 기능이 호환 범위에 있는지는 시험해 확인합니다.
10.12.5 도입 효과
효과는 네 가지입니다.
- 훨씬 높은 처리량: PagedAttention이 메모리 낭비를, 연속 배칭이 GPU 시간 낭비를 멈추므로 순진한 엔진보다 초당 훨씬 많은 토큰과 사용자를 서빙합니다.
- 더 나은 GPU 활용도: GPU를 실제로 얼마나 쓰는지를 뜻하는 활용도에서, 메모리와 연산 둘 다 거의 꽉 차게 써서 비싼 하드웨어에서 더 많은 가치를 얻습니다.
- 요청당 낮은 비용: 한 GPU가 훨씬 많은 사용자를 서빙하므로 사용자당 비용이 크게 줄어듭니다.
- 쉬운 도입: OpenAI 호환 API로 기존 애플리케이션에 거의 수정 없이 붙습니다.
vLLM은 같은 GPU에서 더 많은 사용자를 더 빠르고 싸게 서빙하게 하면서 답의 품질은 바꾸지 않습니다. 모델은 같은 답을 내고, vLLM은 메모리와 시간을 낭비하지 않을 뿐입니다. 서빙 병목이 계산 속도냐 하는 질문의 답도 같은 맥락입니다. 아닙니다. 병목은 KV 캐시 메모리이고 그 관리가 서빙 가능한 사용자 수를 정합니다.
vLLM은 오픈 모델을 자체 GPU에서 돌리려는 회사가 널리 쓰는 인기 오픈소스 서빙 엔진입니다. vLLM이 유일한 서빙 엔진은 아니며, SGLang은 고정 크기 블록 대신 라딕스 트리로 공유되는 텍스트를 정밀하게 맞추는 다른 방식의 접두부 공유를 합니다(10.13 참조). NVIDIA 하드웨어에는 GPU 세대별로 조정된 커널까지 내려가는 NVIDIA 자체 엔진 TensorRT-LLM이 있습니다(10.14 참조). 특히 강력한 시스템은 둘입니다.
| 시스템 | 왜 맞는가 |
|---|---|
| 트래픽이 많은 채팅 애플리케이션 | 많은 사용자가 동시에 채팅할 때 연속 배칭이 모든 GPU 슬롯을 채우고 PagedAttention이 여러 사용자의 KV 캐시를 같은 메모리에 촘촘히 담아 적은 GPU로 많은 인원을 서빙 |
| 에이전트 시스템 | 에이전트는 단계를 밟으며 도구를 부르고 여러 턴에 걸쳐 일을 끝냄. 매 단계 같은 큰 지시문을 보내므로 PagedAttention의 동일 접두부 공유가 메모리를 크게 절약하고, 연속 배칭이 많은 짧은 단계를 놀지 않고 흐르게 함 |
반대로 한 사람이나 작은 팀이 한 기계에서 쓰는 규모는 Ollama가 설계 대상으로 삼는 영역입니다(10.11 참조). 고객이 동시 사용자 수십 명을 넘기거나 에이전트 호출이 많다면 vLLM 같은 서빙 엔진으로 옮기는 안을 근거와 함께 제시하며, 그 근거는 접두부 공유 가능성, 응답 길이 분포, GPU당 동시 요청 수의 세 숫자입니다.
10.13 SGLang
2026년 6월 글 기준으로, SGLang은 여러 사용자의 요청에 동시에 답하면서 과거 작업을 재사용해 속도를 끌어올리는 고성능 LLM 서빙 프레임워크입니다. 같은 시스템 프롬프트와 같은 문서를 요청마다 처음부터 다시 읽는 낭비가 고객 현장의 서빙 비용에 직결되므로, 이 엔진이 무엇을 재사용하고 무엇을 보장하는지 알아야 엔진 선택을 설명할 수 있습니다.
10.13.1 RadixAttention: 과거 작업 재사용
SGLang이라는 이름은 SG(Structured Generation, 구조화된 생성)와 Lang(Language, 언어)의 결합입니다. 구성은 두 조각입니다. 모델을 빠르게 돌리고 구조화 출력을 책임지는 엔진이 **런타임(runtime)**이고, 모델에게 할 일을 파이썬 코드 안에서 적게 해 주는 작은 언어가 **프런트엔드 언어(frontend language)**입니다. 속도의 핵심은 런타임 쪽 RadixAttention입니다.
배경은 두 가지 사실입니다. LLM은 토큰을 하나씩 만들며, 새 토큰을 만들 때마다 앞의 모든 토큰을 되돌아봅니다. 되돌아볼 때마다 이전 토큰을 다시 계산하면 느리므로, 이미 처리한 토큰의 중간 계산값(Key와 Value)을 저장해 재사용하며 이 저장물이 KV 캐시입니다(10.3 참조). 문제는 실서비스에서 같은 모델이 수천 명의 요청을 받고 요청마다 시작 부분이 같다는 점입니다.
- 챗봇은 모든 대화가 같은 시스템 프롬프트(예: "You are a helpful assistant.")로 시작하므로, 요청마다 같은 문장을 다시 처리합니다.
- 문서 질의응답 에이전트는 질문이 달라도 문서는 같은데, 질문마다 문서를 처음부터 읽습니다. 작은 질문 하나를 받을 때마다 책을 1쪽부터 다시 읽는 것과 같습니다.
- SGLang의 중심 아이디어는 시작 텍스트가 같은 요청끼리 그 텍스트의 KV 캐시를 공유하는 것입니다.
RadixAttention은 Radix(공통 접두사로 텍스트를 조직하는 방식)와 Attention(이전 토큰을 되돌아보는 LLM의 핵심 연산, 2.9 참조)의 결합입니다. **접두사(prefix)**는 두 텍스트가 공유하는 시작 부분으로, "The sky is blue"와 "The sky is clear"의 접두사는 "The sky is"입니다. SGLang은 여러 요청의 KV 캐시를 **라딕스 트리(radix tree)**에 저장합니다. 문장의 가계도에 가깝고, 같은 말로 시작하는 문장은 같은 가지를 쓰다가 달라지는 지점에서 갈라집니다.
세 요청으로 확인해 봅니다.
- "You are a helpful assistant. What is the capital of France?"
- "You are a helpful assistant. What is the capital of Japan?"
- "You are a helpful assistant. Tell me a joke."
graph TD
  A["You are a helpful assistant.<br/>공통 접두사, KV 캐시 1회 저장"] --> B["What is the capital of<br/>두 요청이 공유, 1회 저장"]
  A --> C["Tell me a joke.<br/>고유 꼬리"]
  B --> D["France?"]
  B --> E["Japan?"]
그림 10.13.1 — 세 요청의 라딕스 트리. 공통 가지는 한 번만 계산되고, 고유한 꼬리만 개별로 처리됩니다.
- SGLang 없이는 "You are a helpful assistant."를 세 번 처리하지만, 라딕스 트리에서는 한 번만 계산합니다.
- France와 Japan 요청은 "What is the capital of"까지 더 길게 공유하므로 그 가지도 한 번만 저장됩니다.
- "Tell me a joke."는 맨 위 가지만 공유하고 갈라집니다. 공유 가지는 다시 계산되지 않으며, 메모리에 남아 있는 동안 다른 요청이 재사용합니다.
이 재사용은 자동입니다. 새 요청 "...What is the capital of Italy?"가 오면 다음 순서로 동작합니다.
- 트리에서 요청의 시작 부분이 얼마나 이미 있는지 조회합니다.
- "You are a helpful assistant. What is the capital of"가 France·Japan 요청 덕분에 있음을 찾아 그 KV 캐시를 재계산 없이 씁니다.
- 새 부분 "Italy?"만 처리하고, 그 결과를 새 가지로 트리에 붙입니다.
- 이후 토큰을 하나씩 생성합니다.
KV 캐시를 담는 메모리는 유한하므로 가득 차면 버릴 대상이 필요합니다. SGLang은 가장 오래 쓰이지 않은 가지부터 지우는 LRU(Least Recently Used) 규칙을 씁니다. 시스템 프롬프트 같은 인기 접두사는 계속 쓰이므로 남고, 한 번뿐인 꼬리가 먼저 사라집니다. 켜는 설정은 따로 없습니다. API 수준의 접두 재사용은 4.6을 함께 봅니다.
고객 현장에서는 "프롬프트의 앞부분이 요청 간에 얼마나 같은가"를 먼저 묻습니다. 시스템 프롬프트·문서·대화 이력이 길고 공통일수록 절약이 커지고, 앞부분이 요청마다 다르면 이득이 줄어듭니다.
10.13.2 프런트엔드 언어
실제 작업은 질문 하나가 아니라 여러 단계인 경우가 많습니다. 예를 들어 문단을 읽고, 요약하고, 요약을 프랑스어로 번역하는 세 단계는 서로 의존하며, 이를 손으로 엮으면서 빠르게 유지하기는 어렵습니다. 프런트엔드 언어는 모델 호출의 순서를 적고, 중간에 내 텍스트를 섞고, 모델 출력을 변수로 잡는 방법입니다.
import sglang as sgl

@sgl.function
def summarize_and_translate(s, paragraph):
    s += "Summarize this paragraph:\n" + paragraph + "\n"
    s += "Summary: " + sgl.gen("summary", max_tokens=64)
    s += "Now translate the summary to French.\n"
s += "French: " + sgl.gen("french", max_tokens=64)s는 점점 늘어나는 대화이며, 텍스트를 계속 덧붙입니다.sgl.gen("summary", ...)는 모델에게 요약을 생성시키고summary라는 이름으로 저장합니다.- 그다음 번역을 시키고 결과를
french로 저장합니다. 흐름을 평범한 단계로 적으면 실행은 SGLang이 효율적으로 맡습니다.
프런트엔드는 프로그램의 구조를 알아서 어디가 고정이고 공유되는 부분인지, 어디가 새 부분인지 압니다. 같은 프로그램을 여러 요청이 돌리면 접두사가 자연스럽게 겹치고, 런타임은 이를 보고 라딕스 트리로 KV 캐시를 재사용합니다. 프런트엔드가 공유 구조를 드러내고 런타임이 그것을 속도로 바꾸는 협업이 SGLang이 쓰기 쉬우면서 빠른 이유입니다.
다단계 에이전트 흐름(6.3 참조)이 핵심인 고객이라면, 프롬프트를 단계별로 어떻게 조립하는지가 곧 캐시 적중률이므로 조립 순서를 함께 점검합니다.
10.13.3 구조화 출력과 빠른 디코딩
많은 업무는 자유 텍스트가 아니라 고정된 형식의 답을 원합니다. 예를 들어 {"name": "Italy", "capital": "Rome"} 같은 JSON(이름과 값의 묶음으로 데이터를 담는 흔한 형식)입니다. 일반 모델은 괄호를 빠뜨리거나 군더더기 말을 붙여 JSON을 깨뜨릴 수 있고, 그러면 받는 프로그램이 읽지 못합니다.
SGLang은 형식 규칙을 받아 모든 생성 토큰이 그 규칙을 따르도록 강제하며 이를 **제약 디코딩(constrained decoding)**이라 부릅니다. 모델은 형식을 유지하는 토큰만 고를 수 있고, 형식을 깨는 토큰은 선택 자체가 막힙니다. 그래서 출력은 항상 유효하고 깨진 JSON을 받지 않습니다.
- 덤이 있습니다. 형식이 이미 정해 버린 부분은 모델에게 토큰 단위로 묻지 않고 빠르게 채울 수 있어, 구조화 출력이 오히려 빨라지기도 합니다.
- 원문 FAQ의 답은 구조화 출력이 생성을 늦추는 정도가 아주 작고 경우에 따라 더 빠르다는 것입니다.
후속 시스템이 JSON을 파싱해야 하는 연동에서 파싱 실패 재시도 루프를 없앨 수 있는지가 고객 현장의 판단 기준입니다. 스키마 실패율과 재시도 비용을 먼저 물어 이 기능의 가치를 가늠합니다.
10.13.4 추가 기능
SGLang은 핵심 흐름 외에도 기능이 많으며 상당수는 다른 최신 서빙 도구에도 있어 SGLang만의 것이 아닙니다. 기능을 읽기 전에 모델 답변의 두 단계를 알아야 합니다. 프롬프트 전체를 한 번에 읽는 단계가 prefill, 답을 토큰 하나씩 쓰는 단계가 decode입니다(10.2 참조).
먼저 연속 배칭입니다. **배치(batch)**는 모델이 동시에 처리하는 요청 묶음이며, 하나씩 처리하는 것보다 훨씬 효율적입니다. 문제는 요청마다 끝나는 시간이 다르다는 점입니다. 옛 방식은 묶음 전체가 끝나야 새 묶음을 시작하므로 빨리 끝난 요청의 자리가 빈 채 낭비됩니다. **연속 배칭(continuous batching)**은 한 요청이 끝나면 대기 중인 요청이 그 자리를 즉시 채웁니다.
| 방식 | 슬롯 2의 요청 R2가 먼저 끝났을 때 |
|---|---|
| 옛 방식(정적 배칭) | 묶음 전체가 끝날 때까지 빈 채로 대기 |
| 연속 배칭 | 대기 중이던 R5가 즉시 그 자리에서 시작 |
연속 배칭은 흔한 기법이어서 SGLang만의 특징이 아닙니다(10.5 참조). SGLang의 특징은 RadixAttention이 공유 작업을 재사용하고 연속 배칭이 기계를 계속 바쁘게 하는 두 가지를 함께 쓴다는 점이며, 긴 공통 시작을 가진 요청이 많을 때 특히 잘 맞습니다.
기능 목록입니다.
- Chunked prefill: 큰 문서처럼 긴 프롬프트를 한 번에 읽으면 다른 사용자가 막힙니다. 긴 프롬프트를 작은 조각으로 나눠 답변 생성 사이사이에 조금씩 읽어 모두에게 매끄러운 흐름을 유지합니다.
- 투기적 디코딩: 작고 빠른 보조 모델이 몇 토큰을 미리 추측하고, 주 모델이 그 추측을 한 번에 검증합니다. 맞으면 여러 토큰을 한꺼번에 얻습니다(10.6 참조). SGLang은 EAGLE도 지원하며, 토큰 수준이 아니라 모델 내부 피처 수준에서 초안을 만들어 추측이 더 자주 맞게 합니다.
- Prefill-Decode 분리(PD disaggregation): prefill은 많은 연산력을, decode는 많은 메모리와 빠른 왕복을 필요로 합니다. 두 단계를 각자에 맞춘 별도 머신에서 돌리고 라우터가 요청을 알맞은 곳으로 보내며, 아주 큰 규모에서 안정적으로 돌게 합니다(10.7 참조).
- 여러 GPU로 모델 분할: 한 GPU에 안 들어가는 모델을 여러 GPU에 쪼개 올립니다. 모델이 작은 전문가 여럿으로 이뤄진 대형 MoE(3.3 참조)는 전문가를 여러 머신에 흩어 놓을 수도 있어, 세계에서 가장 큰 모델도 이렇게 서빙합니다.
- 양자화: 모델 안의 숫자를 작은 형태로 줄여 메모리를 덜 쓰고 빠르게 돌리며, 품질 저하는 거의 없습니다(10.8 참조).
- 여러 맞춤 버전 동시 서빙: 같은 기본 모델에 작업별로 학습한 작은 맞춤 버전이 많을 때, 각각을 별도 머신에 올리지 않고 같은 배치에서 함께 서빙해 자원을 아낍니다(11.2 참조).
- 이미지 등 멀티모달: 텍스트뿐 아니라 이미지를 이해하는 모델도 서빙하고 비디오 등으로 지원을 넓히는 중입니다. 그래서 LLM과 멀티모달 모델의 프레임워크라 불립니다.
- 똑똑한 스케줄러: 연속 배칭이 슬롯을 채운다면, 스케줄러는 다른 종류의 대기를 다룹니다. GPU가 무거운 일을 하는 동안 CPU가 다음에 무엇을 돌릴지 계획해야 하는데, SGLang은 GPU가 바쁜 사이에 계획을 끝내 GPU가 다음 단계를 기다리는 일이 거의 없습니다.
- 캐시 인지 로드 밸런싱: 여러 머신에서는 요청의 공유 작업을 이미 저장한 머신으로 요청을 보내려 합니다. 그러면 RadixAttention의 재사용이 머신을 넘어서도 유지됩니다.
고객이 기능 이름만 나열하며 SGLang이 좋다고 말할 때는, 그 기능이 다른 엔진에도 있는지 확인하고 실제로 맞는 병목(긴 프롬프트, 모델 크기, 맞춤 버전 수)을 짚어 줍니다.
10.13.5 vLLM과 비교
vLLM(10.12 참조)은 가장 널리 쓰이는 서빙 도구 중 하나여서, 둘이 어떻게 다른지는 자연스러운 질문입니다. 먼저 공통점입니다. 둘 다 빠르고, 여러 사용자를 동시에 서빙하며, 공유 텍스트의 KV 캐시를 재사용하고, JSON 같은 구조화 출력을 지원하며, 같은 스타일의 단순한 API를 제공해 코드를 크게 바꾸지 않고 오갈 수 있는 경우가 많습니다. 시간이 지나며 많이 닮았습니다.
차이는 세 가지입니다.
- 공유 텍스트 재사용 방식입니다. SGLang은 라딕스 트리로 조각 단위로 정밀하게 맞춥니다. vLLM은 고정 크기 블록 단위로 맞추며, 이 블록 방식이 PagedAttention입니다(10.4 참조). 그래서 매 턴 글이 조금씩 늘어나는 긴 멀티턴 대화에서는 SGLang이 vLLM이 놓칠 공유를 잡는 일이 많습니다. 요청들이 완전히 같은 고정 텍스트로 시작하면 둘 다 잘합니다.
- 도달 범위와 성숙도입니다. vLLM이 조금 더 오래되어 가장 큰 커뮤니티와 가장 긴 프로덕션 이력이 있어 범용 서빙의 기본 선택이 되곤 합니다. SGLang은 더 새롭지만 빠르게 성장해 여러 대기업에서 하루에 아주 많은 요청을 처리할 만큼 신뢰받습니다. 둘 다 여러 회사의 다양한 칩에서 돌아갑니다. 반대로 가는 엔진이 NVIDIA GPU에서만 돌고 GPU 세대별 최적 커널을 얻는 TensorRT-LLM입니다(10.14 참조).
- SGLang이 더하는 것입니다. 다단계 작업을 쉽게 쓰는 프런트엔드 언어, 속도 저하가 거의 없는 강력한 구조화 출력, 그리고 긴 대화·에이전트·문서 질의응답처럼 공유 텍스트가 많은 워크로드에서의 강점입니다.
순수 속도는 모델·워크로드·각 도구의 버전에 달려 있어 어느 한쪽이 항상 이기지 않으며, 둘 다 빠르게 개선되고 있습니다.
| 항목 | vLLM |
SGLang |
|---|---|---|
| 공유 텍스트 재사용 | 고정 크기 블록 | 라딕스 트리로 조각 단위 |
| 이력과 커뮤니티 | 가장 길고 가장 큼 | 더 새롭지만 빠르게 성장 |
| 대표 강점 | 범용 고속 서빙과 성숙도 | 접두 공유, 프런트엔드 언어, 구조화 출력 |
| 잘 맞는 곳 | 서로 다른 요청이 많을 때 | 멀티턴 대화, 에이전트, 문서 질의응답 |
표 10.13.5 — vLLM과 SGLang 비교(2026년 6월 글 기준).
선택 기준은 이렇습니다. 가장 큰 커뮤니티, 가장 긴 이력, 서로 다른 요청이 섞인 범용 서빙이라면 vLLM이 좋은 선택입니다. 멀티턴 대화·에이전트·문서 질의응답처럼 텍스트 공유가 많고 구조화 출력이 중요하면 SGLang이 좋은 선택이며, 일상적인 경우에는 둘 모두 충분합니다. 고객과 엔진을 정할 때는 속도 주장을 믿기보다 고객의 실제 요청 분포(접두 중복률, 멀티턴 비중)와 모델·버전으로 직접 측정해 비교하자고 제안합니다.
10.14 TensorRT-LLM
원문: How does TensorRT-LLM work?
2026년 9월 글 기준으로, TensorRT-LLM은 NVIDIA가 만든 오픈소스 라이브러리로 완성된 모델을 받아 NVIDIA GPU에 맞게 깊이 튜닝한 실행 가능 형태로 돌려줍니다. 학습을 돕는 도구가 아니라 추론을 가능한 한 빠르게 만드는 도구이며, 학습은 한 번이지만 추론은 사용자가 입력할 때마다 하루 수백만 번 일어나므로 추론 시간을 조금만 줄여도 그 이득이 수백만 배로 곱해집니다. NVIDIA 전용 인프라를 가진 고객에게 엔진을 권하거나 말릴 때 근거가 되는 내부 원리를 다룹니다.
10.14.1 모델을 미리 엔진으로 빌드
먼저 용어를 정리합니다. **추론(inference)**은 이미 학습된 모델로 답을 만드는 일이며, 학생이 몇 년간 공부하는 것이 학습이고 오늘 우리 질문에 답하는 것이 추론입니다. GPU는 단순한 계산을 동시에 엄청나게 많이 하는 데 특화된 칩입니다. 일반 프로세서인 CPU가 문제를 하나씩 빨리 푸는 똑똑한 한 사람이라면, GPU는 동시에 일하는 평범한 일꾼 만 명입니다. 어려운 퍼즐 하나는 한 사람이 이기지만 작은 덧셈 만 개는 일꾼 무리가 압도하며, LLM은 곱셈과 덧셈의 산이라 GPU에 맞습니다. **커널(kernel)**은 GPU에서 도는 작은 프로그램으로 특정한 계산 하나를 맡습니다(예: 큰 숫자 격자 둘을 곱하는 커널, 숫자 목록 둘을 더하는 커널, 목록의 모든 숫자에 간단한 공식을 적용하는 커널). GPU는 혼자 움직이지 못하고 CPU가 커널을 하나씩 보내 실행시키며 이것이 **커널 런치(kernel launch)**입니다(12.2, 12.3 참조). 토큰 하나를 쓰는 데도 수천 번의 런치가 오갑니다.
일반 딥러닝 프레임워크로 모델을 돌리면 프레임워크가 실행 중에 판단합니다. 층을 하나씩 읽고 층마다 기성 커널을 골라 런치합니다. 모델을 개발할 때는 유연성이 장점이지만, 완성된 모델을 수백만 번 돌릴 때는 이 유연성이 비용이며 시간은 네 곳에서 샙니다.
| 낭비 | 내용 |
|---|---|
| 작은 커널이 너무 많음 | 층 하나가 곱셈·작은 보정 더하기·공식 적용 같은 잔단계로 쪼개지고 각각이 별도 커널이라 수천 개가 됩니다 |
| 메모리 이동 | 가장 큽니다. 커널마다 큰 GPU 메모리에서 숫자를 꺼내 계산하고 다시 써 넣는데, 계산은 빠르고 오가는 일이 느립니다. 일꾼은 계산을 곧바로 끝내고 다음 배달을 기다리며, GPU는 바빠 보이지만 대부분 대기합니다 |
| 런치 오버헤드 | 런치 한 번은 미미하지만 토큰마다·사용자마다 수천 번이면 지연이 됩니다. CPU가 런치를 준비하는 속도가 못 따라 GPU가 CPU를 기다리기도 합니다 |
| 범용 커널 | 기성 커널은 모든 모델·크기·GPU에서 돌도록 쓰여 있어 내 모델과 내 GPU에 최적일 수 없습니다 |
표 10.14.1 — 일반 실행에서 GPU 시간이 새는 네 곳.
곱셈·덧셈·공식 커널 세 개가 연속될 때 숫자는 큰 메모리를 세 번 왕복하는데, 하나의 연결된 작업을 세 번에 나눠 한 결과입니다.
TensorRT-LLM의 이름은 Tensor + RT + LLM입니다. **텐서(tensor)**는 숫자 격자를 가리키는 말로, 숫자 하나·목록·표와 그 확장 모두 텐서이고 모델 안은 전부 텐서입니다. RT는 모델을 실제로 돌리는 부분인 Runtime이며, LLM은 대규모 언어 모델 전용이라는 뜻입니다. 모든 종류의 AI 모델에 같은 속도 작업을 해 주는 NVIDIA의 오래된 도구 TensorRT 위에 KV 캐시(10.3 참조), 다수 사용자 배칭, 거대 모델의 GPU 분할 같은 LLM 고유 기능을 얹었습니다.
핵심 문장은 "미리 생각해 두어 답할 때 GPU가 계산만 하게 한다"입니다. 비유는 식당 두 곳입니다. 주문이 오면 레시피 책을 펴고 장을 보고 채소를 써는 가게는 무엇이든 만들 수 있지만 손님이 오래 기다립니다. 개점 전에 메뉴를 정하고 채소를 썰고 소스를 섞고 도구를 손이 닿는 자리에 둔 가게는 주문이 오면 조리만 하므로 빠르지만 메뉴가 고정입니다. 일반 프레임워크가 앞의 가게, TensorRT-LLM이 뒤의 가게입니다.
**빌드(build)**는 이 준비 단계이고 그 산출물이 **엔진(engine)**입니다. 엔진은 모델의 숫자와, 특정 종류의 GPU에서 빠르게 돌리는 정확한 계획을 함께 담은 파일 하나이며 이미 재료가 손질된 주방에 해당합니다. 빌드 중에는 시간이 많으므로 같은 연산에 여러 커널을 실제 GPU에서 재어 보고 승자를 고르며, 이웃한 작은 연산 열 개를 하나로 합칠 수도 있습니다. 사용자가 기다리는 중에는 불가능한 일이며, 한 번 몇 분을 써서 이후 모든 요청의 속도를 얻는 교환입니다.
빌드는 다섯 단계입니다.
- 학습된 모델(학습으로 얻은 숫자인 가중치)에서 시작합니다.
- 모델을 TensorRT-LLM에 기술합니다. 인기 모델 계열은 정의가 이미 있어 보통 직접 쓸 것이 없고, 읽어서 모든 연산과 연결의 내부 지도를 만듭니다.
- 지도를 최적화합니다. 연산을 합치고, 불필요한 일을 지우고, 더 빠른 모양으로 재배열합니다.
- 연산마다 최선의 커널을 고릅니다. 여러 커널 버전을 실제 GPU에서 시간을 재어 가장 빠른 것을 남기며 이를 **커널 자동 튜닝(kernel auto-tuning)**이라 합니다. 답이 GPU마다 다를 수 있어 엔진이 GPU 종류에 묶입니다.
- 엔진 파일로 씁니다. 계획과 가중치가 한 파일로 저장됩니다.
graph LR
  A["학습된 모델<br/>가중치"] --> B["TensorRT-LLM 빌드<br/>연산 합치기, 불필요한 일 제거,<br/>여러 커널 시도 후 실제 GPU에서 측정"]
  B --> C["엔진 파일<br/>가중치와 빠르게 돌리는 계획"]
  C --> D["모든 요청에서 사용"]
그림 10.14.1 — 모든 생각을 한 번의 빌드에 몰아 두면 수백만 번 반복되는 실행에는 계산만 남습니다.
계획이 특정 GPU, 특정 정밀도, 특정 크기 한도에 맞춰져 있어 엔진은 자유롭게 옮길 수 없습니다. GPU를 바꾸거나 훨씬 긴 프롬프트를 허용하려면 새 엔진을 빌드해야 하며, 이 경직성이 속도의 대가입니다.
고객과는 "모델과 GPU 종류가 얼마나 고정되어 있는가"를 먼저 확인합니다. 고정이라면 빌드 비용은 한 번이고, 자주 바뀐다면 빌드가 반복 마찰이 됩니다.
10.14.2 커널 퓨전(Kernel Fusion)
커널 퓨전은 작은 커널 여러 개를 하나의 큰 커널로 합쳐 숫자를 메모리에서 여러 번이 아니라 한 번만 꺼내게 하는 기법으로, 가장 중요한 요령입니다. 느린 부분은 계산이 아니라 큰 GPU 메모리와 일꾼 사이의 이동이기 때문입니다.
같은 숫자에 세 가지를 연달아 하는 예입니다.
- 큰 가중치 격자를 곱합니다.
- 결과에 작은 보정값을 더합니다.
- 모든 숫자에 음수를 0으로 바꾸는 식의 간단한 공식을 적용합니다.
퓨전 없이는 세 커널이며 숫자가 메모리에서 나와 곱해지고 돌아가고, 다시 나와 더해지고 돌아가고, 세 번째로 나와 공식을 적용하고 돌아가므로 왕복이 세 번입니다. 퓨전하면 일꾼 옆의 빠른 메모리에 숫자가 있는 동안 세 가지를 모두 하는 커널 하나를 써서 한 번 나와 한 번 돌아갑니다.
| 메모리 왕복 | 커널 런치 | |
|---|---|---|
| 퓨전 없음 | 3회 | 3회 |
| 퓨전 | 1회 | 1회(런치 2회 절감) |
표 10.14.2 — 계산과 답은 같고 느린 이동 횟수만 3회에서 1회로 줄어듭니다.
이 절감이 모델의 모든 층, 모든 토큰, 모든 사용자에서 곱해지므로 퓨전만으로도 큰 속도 향상이 생깁니다. 빌드 중에는 모델 전체가 한눈에 보이고 이후 바뀌지 않는다는 것도 알기 때문에 일반 프레임워크보다 훨씬 공격적으로 퓨전할 수 있습니다.
같은 맥락의 **양자화(quantization)**는 모델 숫자를 더 적은 비트로 저장하는 기법입니다(10.8 참조). 가중치는 0.372 같은 소수이고, 컴퓨터는 이를 정해진 크기의 비트로 저장하며 보통 16비트나 32비트로 학습합니다. 가격을 19.9999999 대신 20으로 적는 것에 해당하며 모델의 모든 숫자에 이를 적용합니다. 16비트 모델을 8비트나 4비트로 바꾸고, NVIDIA 신형 GPU에는 작은 형식을 빠르게 돌리는 전용 하드웨어가 있습니다. 이득은 세 가지입니다.
- 메모리가 줄어듭니다. 8비트는 같은 모델의 16비트 크기의 절반(8/16 = 0.5)이고 4비트는 4분의 1(4/16 = 0.25)이므로, 안 들어가던 모델이 들어가고 아낀 공간이 더 많은 사용자를 받는 여유가 됩니다.
- 이동이 줄어듭니다. 숫자 크기가 절반이면 이동 시간도 대략 절반으로, 병목 자체를 직접 줄입니다.
- 계산이 빨라집니다. 작은 숫자용 전용 하드웨어가 더 큰 숫자 연산보다 몇 배 빨리 돕니다.
함정은 반올림으로 정보가 조금 사라진다는 점입니다. 그래서 민감한 부분은 높은 정밀도로 두고 나머지만 줄이며, 샘플 텍스트를 흘려 숫자의 실제 범위를 관찰해 반올림을 보정(calibration)합니다. 검증된 양자화 방식 여러 개가 들어 있습니다. KV 캐시도 가중치처럼 양자화할 수 있어(KV 캐시 압축, 10.1 참조) 메모리를 많이 차지하는 캐시를 줄이면 더 많은 사용자를 받습니다. 잘하면 원본에 가까운 답을 내는 더 작고 빠른 모델이 되지만 부주의하면 빠르기만 한 모델이 되므로, 배포 전에 반드시 실제 예제로 확인합니다.
고객의 실제 질문·문서로 양자화 전후 답을 비교하는 평가 세트가 있는지 묻는 것이 판단 기준입니다. 속도 숫자만 좋고 답이 조용히 나빠지는 사고는 이 확인으로 막습니다.
10.14.3 커스텀 어텐션 커널
모델에서 가장 무거운 연산은 어텐션입니다(2.9 참조). 다음 단어를 쓰기 직전에 앞선 단어 중 지금 쓰는 데 무엇이 중요한지 묻는 단계이며, 대화가 길수록 되돌아볼 단어가 늘어 비용이 커지므로 보통 모델 전체에서 시간을 가장 많이 먹습니다.
어텐션은 연산 하나가 아니라 여러 연산의 사슬이고, 각 연산이 큰 메모리 왕복을 가지므로 앞에서 본 낭비 패턴과 같습니다. 그래서 TensorRT-LLM은 어텐션을 사슬로 돌리지 않고 커스텀 어텐션 커널을 씁니다. 어텐션 단계 전체를 한 번에 하고 중간 결과를 일꾼 옆 빠른 메모리에 두며 큰 메모리에는 쓰지 않는 직접 작성 커널입니다. 대표적인 것이 FlashAttention입니다(10.1 참조).
- GPU를 깊이 아는 엔지니어가 상황별로 버전을 나눠 씁니다. 긴 프롬프트 읽기에 맞춘 버전과 토큰 하나씩 쓰기에 맞춘 버전이 다릅니다.
- NVIDIA GPU 세대마다 하드웨어가 조금 달라 세대별 버전이 있습니다.
- GPU를 만드는 회사가 커널을 쓰므로 하드웨어에 딱 맞출 수 있고, 이것이 NVIDIA 하드웨어에서 빠른 가장 큰 이유 가운데 하나입니다.
대신 이 이점은 NVIDIA GPU에 한정되고 세대가 바뀌면 커널도 바뀝니다. 고객 인프라가 어느 GPU 세대인지가 이 이점의 크기를 정합니다.
10.14.4 paged KV 캐시와 in-flight batching
KV 캐시는 이미 처리한 토큰마다 계산해 둔 메모를 GPU 메모리에 두고 다시 계산하지 않는 저장물입니다(10.3 참조). 답에는 두 단계가 있습니다. 프롬프트 전체를 한 번에 읽는 prefill과 답을 토큰 하나씩 쓰는 decode입니다(10.2 참조). decode에서 새 토큰마다 앞 토큰 전부를 되돌아봐야 하고, 메모를 버리면 단어를 쓸 때마다 대화 전체의 메모를 다시 계산해야 해 느립니다.
KV 캐시는 계속 자랍니다. 토큰이 하나 늘 때마다 메모가 한 세트 늘고, 사용자마다 자기 캐시가 있으며, 모두 같은 한정된 GPU 메모리에 공존합니다. 남은 KV 캐시 메모리가 동시에 받을 사용자 수를 정합니다. 순진한 방식은 답 길이를 미리 모르므로 요청마다 가장 긴 답 크기의 큰 덩어리를 처음부터 예약합니다. 대부분의 답은 짧아 예약 공간 대부분이 쓰이지 않고 남에게 줄 수도 없습니다.
paged KV 캐시는 메모리를 같은 크기의 작은 블록으로 쪼개 요청이 실제로 더 필요할 때 하나씩 내주는 방식입니다(10.4 참조). 블록이 메모리에서 이웃할 필요가 없고, 작은 표가 어느 블록이 어느 요청의 몇 번째인지 기억합니다.
| 요청 | 보유 블록 |
|---|---|
| A | B1, B4, B7 (답이 자라면서 하나씩 받은 3개) |
| B | B2, B3 (2개) |
| C | B5 (막 시작, 1개) |
| 비어 있음 | B6, B8, B9 |
표 10.14.4 — 오지 않을지 모르는 답을 위한 예약이 없고, 요청이 끝나면 블록이 즉시 풀로 돌아갑니다.
블록 크기가 모두 같아 어느 빈 블록이든 어느 요청에 맞아 낭비가 거의 없습니다. 덤으로, 똑같은 텍스트로 시작하는 두 요청이 사본 대신 같은 블록을 가리킬 수 있습니다. 모든 대화가 같은 긴 지시문으로 시작한다면 그 시작은 한 번만 저장되어 모두가 공유하며, 이것이 prefix reuse(접두 재사용)로 메모리와 그 시작을 다시 처리하는 일을 모두 아낍니다(4.6 참조).
in-flight batching은 연속 배칭(10.5 참조)을 TensorRT-LLM이 부르는 이름입니다. 배치는 GPU가 한 번에 처리하는 요청 묶음이며, 일꾼 만 명 앞에 요청 하나만 주면 대부분이 논다는 것이 배칭의 이유입니다. **정적 배칭(static batching)**은 묶음을 모아 같이 돌리고 전부 끝나야 다음 묶음을 시작합니다. 답 길이는 20토큰부터 800토큰까지 제각각이라, 짧은 답이 일찍 끝나도 긴 답을 기다리며 자리가 오래 빕니다. in-flight batching은 끝난 요청을 그 순간 배치에서 빼고 대기 요청을 즉시 그 자리에 끌어옵니다. decode는 한 스텝에 토큰 하나를 쓰는 작은 스텝의 연속이므로 스텝마다 방금 끝난 요청을 빼고 KV 캐시 블록을 풀고 대기열의 새 요청을 채워 배치를 항상 살아 있는 일로 유지합니다.
| 스텝 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 |
|---|---|---|---|---|---|---|---|---|
| 정적: 슬롯 1 | A | A | A | 빈 슬롯 | 빈 슬롯 | 빈 슬롯 | 빈 슬롯 | 빈 슬롯 |
| 정적: 슬롯 2 | B | B | B | B | B | B | B | B 종료 |
| in-flight: 슬롯 1 | A | A | A | C | C | C | D | D |
표 10.14.4b — A는 3스텝에 끝나 정적 배칭에서는 슬롯이 5스텝(4~8) 비지만, in-flight에서는 C가 즉시 들어오고 C가 끝나면 D가 이어받습니다.
여기에 chunked prefill이 함께 쓰입니다. 긴 프롬프트를 한 번에 읽으면 잠깐 모두가 막히므로, 긴 프롬프트를 작은 조각으로 나눠 다른 사용자의 토큰 쓰기 스텝 사이에 끼워 처리해 서버 전체가 덜컥하는 일을 막습니다. 다만 두 단계가 한 GPU를 나눠 쓰는 점은 그대로이며, 아주 큰 규모에서는 prefill과 decode를 서로 다른 GPU에서 돌리는 방식으로 한 걸음 더 갑니다(10.7 참조). paged KV 캐시는 끝난 요청의 메모리를 즉시 풀고 in-flight batching은 그 메모리와 슬롯을 즉시 새 사용자에게 주므로, 둘이 맞물려 GPU 메모리와 GPU 일꾼 모두를 꽉 채웁니다.
KV 캐시 여유 메모리와 요청 길이 분포를 같이 보는 것이 고객 현장에서의 용량 산정 시작점입니다. 동시 사용자 수 한계가 연산이 아니라 캐시 메모리에서 먼저 올 수 있기 때문입니다.
10.14.5 CUDA graphs
앞서 세 번째 낭비인 런치 오버헤드를 다룹니다. 토큰 하나를 쓸 때 수천 개의 커널이 런치되고, 모델이 작거나 배치가 작으면 GPU가 커널을 너무 빨리 끝내 CPU가 따라가지 못해 GPU가 다음 지시를 기다립니다. CUDA는 NVIDIA의 GPU 프로그래밍 체계이고, CUDA graph는 커널 런치의 순서 전체를 한 번 기록해 두었다가 지시 하나로 통째로 재생하는 방법입니다(12.3 참조). 매니저가 토큰마다 일꾼에게 3,000개의 지시를 따로 외치는 대신, 준비된 체크리스트를 한 번 건네며 "이 목록 전부 하라"고 하는 것과 같습니다.
| CUDA graph 없음 | CUDA graph 있음 | |
|---|---|---|
| CPU 지시 횟수 | 커널마다 한 번, 3,000번 | 기록된 그래프 실행 1번 |
| GPU | 지시 사이사이 대기 | 3,000개 커널을 연달아 혼자 실행 |
표 10.14.5 — 실행하는 커널 수는 같고 CPU는 한 번만 말합니다.
이것이 TensorRT-LLM에서 특히 잘 맞는 이유는 토큰을 쓰는 스텝이 직전 스텝과 똑같은 연산 순서를 계속 반복하기 때문입니다. 반복되고 변하지 않는 순서가 바로 CUDA graph가 기록하기 좋은 대상입니다.
다음으로 완전히 다른 문제를 노리는 **투기적 디코딩(speculative decoding)**입니다(10.6 참조). 토큰을 하나씩 쓰는 일이 느린 근본 이유는 GPU가 약해서가 아니라 각 토큰이 앞 토큰을 기다려야 하기 때문입니다. 다섯 번째 단어는 네 번째가 나와야 쓸 수 있고, 토큰마다 작은 텍스트 조각 하나를 위해 모델 전체의 가중치를 메모리에서 꺼냅니다. 일꾼은 거의 힘들지 않고 비용 전부가 가중치를 가져오는 이동입니다. 그렇다면 토큰 다섯 개를 한꺼번에 만드는 비용은 한 개와 거의 같습니다(가중치를 한 번만 꺼내므로). 문제는 다음 다섯 토큰이 무엇인지 모른다는 것뿐입니다.
투기적 디코딩은 싸고 빠른 무언가로 몇 토큰을 미리 추측하고, 진짜 모델이 그 추측 전부를 한 번에 검증해 맞은 것을 남깁니다.
- 싸고 빠른 추측기가 다음 몇 토큰, 예를 들어 네 개를 제안합니다. 추측기는 훨씬 작은 모델, 주 모델에 붙인 작은 추가 부품, 또는 앞서 본 텍스트 패턴을 단순 조회하는 방식일 수 있습니다.
- 큰 모델이 추측 네 토큰을 한 번의 패스로 검사합니다. 네 토큰을 함께 검사하는 비용이 한 토큰 만드는 비용과 거의 같다는 점이 영리한 부분입니다.
- 큰 모델이 자기가 만들었을 것과 일치하는 추측을 처음부터 남기고, 첫 오류 이후는 버립니다.
- 네 개가 모두 맞으면 한 토큰 값으로 네 토큰을 얻고, 두 번째가 틀렸으면 첫 토큰은 남기고 두 번째는 큰 모델이 고쳐 쓴 뒤 거기서 다시 시작합니다.
예로 추측기가 [the][cat][sat][on]을 제안하고 큰 모델이 앞의 셋에 동의하고 넷째에서 다르면, "the cat sat" 세 토큰에 큰 모델이 고른 올바른 토큰 하나를 더해 한 스텝에서 네 토큰을 얻습니다. 비용은 보통 한 스텝 정도입니다.
가장 중요한 약속은 최종 답이 큰 모델이 혼자 썼을 답과 정확히 같다는 것입니다. 모든 추측이 검증되고 틀린 추측은 버려지므로, 품질을 속도와 바꾸는 것이 아니라 어차피 놀던 여유 용량을 쓰는 것입니다. TensorRT-LLM은 작은 별도 모델부터 Medusa·EAGLE처럼 주 모델에 붙이는 추가 예측 헤드까지 여러 추측 방식을 지원해 환경에 맞게 고릅니다(10.1.3 참조).
다만 추측기가 자주 틀리면 추측 비용을 내고 결과를 버려 속도가 오히려 나빠질 수 있어, 실제 트래픽에서 측정해야 합니다. CUDA graph가 CPU 대기를, 투기적 디코딩이 토큰당 가중치 이동을 겨냥한다는 점을 구분해 두면 고객이 "느린 이유"를 말할 때 어느 기법이 맞는 처방인지 가를 수 있습니다.
10.14.6 다중 GPU 병렬 실행
가장 큰 모델은 수천억 개의 숫자를 가지며 양자화한 뒤에도 GPU 한 개의 메모리에 다 들어가지 않습니다. 그래서 모델을 여러 GPU에 나누어야 하고, TensorRT-LLM은 이를 내장하며 두 방식을 필요하면 함께 씁니다.
- 텐서 병렬(tensor parallelism): 모델의 각 층을 조각으로 잘라 GPU마다 한 조각씩 줍니다. 모든 GPU가 같은 토큰을 동시에 각자 몫만큼 계산하고 부분 답을 합쳐 완전한 답을 만듭니다. 모든 GPU가 한꺼번에 일해 빠르지만, 합치기 위해 몇 스텝마다 GPU끼리 통신해야 합니다. 고속 링크로 이어진 한 머신 안에서는 빠르고, 일반 네트워크로 이어진 다른 머신 사이에서는 느립니다.
- 파이프라인 병렬(pipeline parallelism): 층은 자르지 않고 첫 층 묶음은 첫 GPU에, 다음 묶음은 둘째 GPU에 주는 식으로 줄 세웁니다. 조립 라인처럼 일이 흐릅니다. GPU 사이 통신이 적어 머신을 넘나들 때 낫지만, 요청 하나는 GPU를 차례로 거치므로 한쪽이 일하는 동안 다른 쪽이 기다립니다.
| 텐서 병렬 | 파이프라인 병렬 | |
|---|---|---|
| 자르는 방식 | 각 층을 옆으로 | 층의 더미를 구간으로 |
| 예 | 층 1~3 모두를 GPU0과 GPU1이 반씩 | 층 1~20은 GPU0, 21~40은 GPU1, 41~60은 GPU2 |
| 동작 | 같은 토큰을 함께 처리하고 조각을 합침 | 요청 하나는 GPU를 한 번에 하나씩 거침 |
| 통신 | 잦음, 한 머신 안에서 유리 | 적음, 머신 사이에서 유리 |
표 10.14.6 — 텐서 병렬과 파이프라인 병렬.
고전 엔진 경로에서는 쓸 GPU 수가 빌드 시점에 정해집니다. 엔진이 처음부터 그렇게 나뉜 모델로 준비되어야 하기 때문이며, 이것도 엔진이 특정 구성에 묶이는 이유입니다. 고객이 큰 모델을 올리려 할 때는 GPU가 한 머신 안에 있는지, 머신을 넘나드는지를 먼저 묻고 그에 맞는 분할 방식을 고릅니다.
10.14.7 PyTorch 백엔드
지금까지는 엔진을 미리 빌드한 뒤 실행하는 원래 경로였습니다. 속도는 훌륭하지만 비용이 있습니다. 빌드에 시간이 들고, 엔진이 GPU 종류와 크기 한도에 묶이며, 새 모델 아키텍처 지원에 작업이 필요합니다. 새 모델이 계속 나오는데 매번 빌드를 기다리기는 불편합니다. 그래서 TensorRT-LLM은 대부분의 모델이 쓰는 인기 프레임워크 PyTorch 위에 직접 얹는 두 번째 방식을 추가했고, 최근 버전에서는 이 PyTorch 경로가 기본이 되었습니다(2026년 9월 글 기준).
새 경로에는 별도의 사전 빌드가 없습니다. 모델을 가리키면 로드하면서 최적화를 적용하고 돕니다. 속도를 잃느냐는 질문의 답은 대체로 아니오입니다. 큰 이득 대부분이 사전 빌드에 의존하지 않기 때문입니다.
- 커스텀 어텐션 커널은 어느 경로든 씁니다.
- paged KV 캐시와 in-flight batching은 런타임 메모리 관리자와 스케줄러이므로 어느 경로든 작동합니다.
- 양자화, 투기적 디코딩은 어느 경로든 적용할 수 있고, CUDA graph는 런타임에 기록되므로 어느 경로든 작동합니다.
- 사전 빌드만이 주는 것은 모델 전체에 걸친 깊은 퓨전과, 여러 커널을 실제 GPU에서 재어 승자를 남기는 철저한 자동 튜닝입니다. 이득은 진짜이므로 고정된 GPU에서 대량 트래픽을 받는 안정적인 배포에는 빌드할 가치가 있습니다.
| 상황 | 선택 |
|---|---|
| 가장 쉬운 경로, 새 모델의 빠른 지원, 구성을 바꿀 자유 | PyTorch 경로 |
| 고정된 모델 하나, 고정된 GPU 하나, 막대한 트래픽, 마지막 한 조각의 속도까지 중요 | 사전 빌드 엔진 |
표 10.14.7 — 경로 선택.
서빙 방법은 세 가지입니다. 첫째는 내장 서버로, 모델을 감싸는 서버를 시작하는 명령이 있고 OpenAI API와 같은 요청·응답 형식을 씁니다. OpenAI API에 맞춰 만든 도구가 이미 많아서 주소만 바꾸면 애플리케이션을 고치지 않고 내 모델·내 GPU로 보낼 수 있습니다(12.1 참조). 둘째는 NVIDIA의 범용 서빙 시스템인 Triton Inference Server로, TensorRT-LLM 백엔드가 있어 상태 점검, 지표, 여러 모델 병행 실행, 표준 배포 패턴을 얻습니다. 셋째는 자기 코드에서 파이썬 인터페이스로 직접 부르는 것이며 시험해 보기에 가장 쉽습니다.
from tensorrt_llm import LLM

llm = LLM(model="model-name-or-path")
output = llm.generate("What is inference in machine learning?")
print(output)
두 줄 뒤에서 퓨전 커널, paged KV 캐시, in-flight batching 등 앞서 본 장치가 모두 돕니다. 호스팅 경로도 있습니다. NVIDIA가 모델을 NIM(NVIDIA Inference Microservice)이라는 기성 컨테이너로 패키징하는데, 많은 컨테이너가 안에서 TensorRT-LLM을 쓰므로 사용자가 엔진을 손으로 빌드하지 않고도 쓰는 경우가 많습니다.
요청 하나의 전체 여정은 다음 순서입니다. 사용자가 오기 전에 엔진을 빌드하거나 PyTorch 경로가 시작하며 로드·최적화를 마치고, 그 결과 퓨전 커널이 정해지고 양자화가 적용되고 요청한 GPU들에 모델이 나뉘고 KV 캐시 메모리가 작은 블록 하나의 풀로 준비되며 서버가 대기합니다.
- 질문이 서버에 도착해 토큰으로 쪼개집니다.
- 스케줄러가 질문의 시작이 이전 요청 덕분에 KV 캐시에 이미 있는지 확인합니다(모든 대화가 같은 긴 지시문으로 시작하는 경우 등). 있으면 다시 처리하지 않고 재사용합니다.
- 새 부분을 처리하는 것이 prefill이며, 프롬프트가 길면 다른 사용자를 막지 않도록 조각으로 나눕니다.
- 요청이 살아 있는 배치에 합류합니다. 이전 요청이 방금 끝나 블록이 풀로 돌아간 덕에 in-flight batching에 빈 슬롯이 있습니다.
- 답을 한 스텝씩 씁니다. 퓨전 커널과 커스텀 어텐션 커널이 계산하고, 기록된 시퀀스 전체가 CUDA graph로 한 번에 재생되어 CPU가 병목이 되지 않으며, 투기적 디코딩이 토큰 여러 개를 시도합니다. KV 캐시가 차면 블록이 하나 더 붙습니다.
- 토큰이 만들어지는 대로 스트리밍되어 답이 끝나기 전에 읽기 시작할 수 있습니다.
- 답이 끝나면 요청이 즉시 배치를 떠나고 블록이 모두 풀로 돌아가며 대기 중인 사용자가 바로 다음 스텝에서 그 슬롯을 받습니다.
준비는 한 번 맨 처음에 일어나고, 메모리 장치는 동시에 몇 명을 받을지를, 속도 장치는 토큰 하나가 얼마나 빨리 나오는지를 정합니다. 고객에게 "어느 경로로 배포할지"와 "OpenAI 호환 주소로 기존 앱을 그대로 붙일 수 있는지"를 확인하면 도입 장벽을 빠르게 가늠할 수 있습니다.
10.14.8 TensorRT-LLM vs vLLM
vLLM(10.12 참조)은 또 하나의 인기 있는 서빙 엔진이어서 비교는 자연스럽습니다. 공통점이 많습니다. 둘 다 다수 사용자를 동시에 서빙하고, 메모리를 낭비하지 않도록 paged KV 캐시를 쓰며, 연속 배칭(TensorRT-LLM의 in-flight batching)으로 슬롯이 놀지 않게 하고, 양자화·투기적 디코딩·chunked prefill·여러 GPU 분할을 지원하며, OpenAI 호환 서버를 제공해 한쪽에서 다른 쪽으로 옮길 때 주소 정도만 바꾸면 되는 경우가 많습니다. 두 프로젝트 사이에서 아이디어가 양방향으로 오가 시간이 갈수록 가까워졌습니다.
차이는 네 가지입니다.
- 누구를 위해 만들었는가: TensorRT-LLM은 NVIDIA가 NVIDIA GPU용으로 만들었고, 이기기 위해 GPU 세대별로 튜닝한 커스텀 커널까지 내려갑니다. vLLM은 여러 회사의 폭넓은 하드웨어에서 잘 돌도록 만들어졌습니다. 전자는 이식성을 주고 깊이를, 후자는 깊이를 주고 도달 범위를 취합니다.
- 사전 준비의 양: 고전 TensorRT-LLM 경로는 먼저 GPU와 크기 한도에 묶인 엔진을 빌드하게 하고, vLLM은 사전 작업 없이 모델을 가리키면 서빙합니다. TensorRT-LLM의 새 PyTorch 경로가 이 간극을 많이 줄였지만, 오늘 시작하는 사람에게는 vLLM의 생태계·문서·관행이 여전히 더 단순합니다.
- 새 모델의 도착 속도: vLLM은 큰 오픈소스 커뮤니티가 있어 새 모델 지원이 며칠 안에 나오는 일이 흔합니다. TensorRT-LLM은 중요한 모델을 잘 지원하고 NVIDIA가 큰 릴리스에는 빠르지만, 가장 새롭거나 특이한 모델은 vLLM에서 먼저 돌 가능성이 큽니다.
- 순수 속도: 모델, GPU, 워크로드, 각 도구의 버전에 달려 있습니다. 잘 튜닝된 엔진을 쓰는 NVIDIA 하드웨어에서는 TensorRT-LLM이 가장 빠른 선택인 경우가 많은데, 이것이 이 엔진이 만들어진 목적입니다. 하지만 두 프로젝트 모두 몇 주마다 개선되고 공개된 비교는 금방 낡으므로 영구적 승자는 없고, 내 모델과 내 트래픽으로 직접 돌려 본 비교만 의미가 있습니다.
| 항목 | TensorRT-LLM | vLLM |
|---|---|---|
| 만든 곳 | NVIDIA, NVIDIA GPU용 | 오픈소스 커뮤니티, 다양한 하드웨어용 |
| 필요한 준비 | 고전 경로는 엔진 빌드, 새 PyTorch 경로는 불필요 | 없음, 모델을 가리키면 됨 |
| 튜닝 깊이 | 깊음, GPU 세대별 커널까지 | 넓고 강하지만 이식성을 지키도록 설계 |
| 새 모델 지원 | 양호, 큰 릴리스에는 빠름 | 대체로 가장 이르며, 큰 커뮤니티 덕분 |
| 시작 난이도 | 새 PyTorch 경로로 많이 개선 | 첫날부터 단순 |
| 대표 강점 | NVIDIA 하드웨어에서 최고 속도 | 유연성, 도달 범위, 가장 큰 커뮤니티 |
표 10.14.8 — TensorRT-LLM과 vLLM 비교(2026년 9월 글 기준).
선택 기준입니다. 전체 플릿이 NVIDIA이고, 모델과 구성이 안정적이며, 트래픽이 막대하고, 속도가 곧 비용을 정한다면 TensorRT-LLM이 강한 선택입니다. 빠르게 움직이고, 여러 모델을 시험하고, 혼합 하드웨어에서 돌리고, 구성을 유연하게 두고 싶다면 vLLM이 강한 선택이며, 일상적인 경우에는 둘 다 충분합니다. 정밀한 접두 공유(라딕스 트리)에 초점을 둔 세 번째 선택지가 SGLang입니다(10.13 참조).
TensorRT-LLM이 잘 맞는 곳과 실패하는 곳은 다음과 같습니다.
| 잘 맞는 곳 | 실패하는 곳 |
|---|---|
| NVIDIA가 자기 하드웨어를 직접 튜닝한 커스텀 커널과 측정된 커널 선택 덕에 NVIDIA GPU에서 뛰어난 속도 | NVIDIA GPU에서만 돌고 다른 하드웨어로의 이식성이 없음(의도된 설계) |
| paged KV 캐시와 in-flight batching이 함께 작동해 다수 사용자를 효율적으로 서빙 | 고전 경로에서는 엔진이 GPU 종류, 정밀도, 크기 한도에 묶여 하나라도 바꾸면 다시 빌드 |
| 양자화 지원이 좋아 더 큰 모델을 더 적은 메모리에 올리고 작은 숫자 형식용 하드웨어에서 더 빨리 실행 | 빌드 단계가 시간을 먹고 배포 절차에 단계를 더해 더 단순한 엔진에는 없는 마찰이 생김 |
| GPU 한 개에서 여러 GPU·여러 머신까지 확장되어 가장 큰 모델도 서빙 | 새롭거나 특이한 모델 아키텍처는 첫날 지원되지 않을 수 있고 직접 지원을 추가하는 일은 실제 작업 |
| Triton과 기성 NIM 컨테이너로 완전한 프로덕션 구성에 연결 | 양자화는 공짜가 아니어서 내 예제로 꼼꼼히 확인하지 않으면 속도 숫자는 훌륭한데 답이 조용히 나빠질 수 있음 |
| 같은 GPU에 더 많은 사용자를 얹어 요청당 비용 하락 | 추측기가 자주 틀리면 투기적 디코딩이 오히려 속도를 떨어뜨릴 수 있어 실제 트래픽에서 측정해야 함 |
| 배치 크기, 메모리 한도, 정밀도 등 조정할 설정이 많아 잘못 튜닝하면 합리적인 기본값의 단순 엔진보다 느릴 수 있음 |
표 10.14.8b — 적합한 곳과 실패하는 곳.
모든 아이디어는 같은 적, 강력하지만 기다리기만 하는 GPU를 겨냥합니다. 대기를 없애면 같은 칩이 훨씬 많은 사람을 서빙합니다. 학습에는 쓸 수 없고(추론 전용), 다른 회사 GPU에서는 돌지 않으며, 고전 경로의 엔진은 다른 GPU로 옮길 수 없습니다. 고객과 엔진을 정할 때는 NVIDIA 고정 여부, 모델 변경 빈도, 트래픽 규모의 세 가지를 묻고, 속도 주장은 고객의 모델과 트래픽으로 직접 측정해 확인합니다.
10.15 고객이 내일 묻는다면
각 질문에 소리 내어 답해보고, 막히면 표시된 절로 돌아가십시오. 로드맵이 제시한 통과 기준은 "내일 고객이 물어도 설명하고 결정할 수 있는가"입니다.
- "챗봇의 첫 글자가 나오기까지 5초나 걸립니다. 모델이 느린 건가요?" 어떤 지표를 먼저 보고, 어느 단계를 의심합니까? (10.2.4, 10.2.1)
- "답이 한번 나오기 시작하면 천천히 흘러나오는데, GPU는 놀고 있다고 합니다. 왜 그렇습니까?" 연산 병목과 메모리 병목으로 설명해 보십시오. (10.2.3, 10.2.2)
- "같은 문장을 매번 다시 계산하지 않게 한다던데, 무엇을 저장하고 무엇은 저장하지 않나요?" 속도와 메모리의 맞교환까지 답해 보십시오. (10.3.2, 10.3.4)
- "GPU 메모리가 남는 것처럼 보이는데 동시 사용자는 늘지 않습니다." 무엇이 낭비되고, 어떤 방식이 이를 줄입니까? (10.4.1, 10.4.2)
- "요청이 짧은 것도 긴 것도 섞여 오는데, 짧은 요청이 긴 요청 끝나기를 기다립니다." 왜 그렇고 어떻게 고칩니까? (10.5.1, 10.5.2)
- "작은 모델로 초안을 쓰게 하면 빨라진다는데, 답이 달라지지는 않나요?" 어떤 조건에서 이득이 사라집니까? (10.6.2, 10.6.4)
- "긴 문서 하나가 들어올 때마다 다른 사용자의 답이 중간에 멈춥니다." 무슨 일이고 어떤 서빙 구조를 검토합니까? 그 구조의 비용은 무엇입니까? (10.7.1, 10.7.4, 10.7.5)
- "70억 파라미터 모델을 16GB 노트북에서 돌리고 싶습니다. 4비트로 줄이면 얼마나 필요한가요?" 계산 근거와 품질 위험을 말해 보십시오. (10.8.1, 10.8.6)
- "파일 이름이 Q4_K_M인데 무슨 뜻인가요?" 어떤 기준으로 양자화 수준을 고릅니까? (10.9.3, 10.8.7)
- "인터넷이 막힌 사무실 PC 한 대에서 사내 문서 요약을 하고 싶습니다." 어떤 도구 조합을 제안하고, 그 안에서 각 도구는 어떤 일을 맡습니까? (10.10.5, 10.11.1)
- "수백 명이 동시에 쓰는 사내 챗봇인데, 어떤 서빙 엔진이 맞고 기존 OpenAI 코드는 그대로 쓸 수 있나요?" (10.12.5, 10.12.4)
- "에이전트가 같은 긴 시스템 프롬프트로 요청을 계속 보냅니다. 이 중복을 줄이는 엔진 기능이 있나요?" (10.13.1, 4.6)
- "NVIDIA GPU만 쓰는데 TensorRT-LLM으로 바꾸면 무조건 빨라지나요?" 빌드 비용과 모델 교체 부담은 어떻게 판단합니까? (10.14.1, 10.14.8)
- "여러 GPU로 쪼개 돌리면 선형으로 빨라지나요?" 무엇을 확인하고 어떤 한계를 설명합니까? (10.14.6, 10.10.4)