7. 에이전틱 엔지니어링과 코딩 에이전트로 빠르게 만들기
에이전트를 믿을 만하게 만드는 것은 모델이 아니라 모델을 감싸는 하네스, 루프, 그래프라는 제어 구조의 설계입니다. 이 구조를 알면 코딩 에이전트로 프로토타입을 빠르게 만들면서도 어디까지 맡기고 어디서 사람이 승인할지 정할 수 있습니다.
학습 동기: 이 장을 읽으면 고객이 "에이전트가 가끔 엉뚱한 일을 합니다"라고 호소할 때 하네스, 루프, 그래프 중 어느 층을 손봐야 하는지 짚을 수 있고, LangChain·LangGraph·Claude Code·Cursor가 각각 무엇을 대신해 주는지 비교해 도입 근거를 설명할 수 있습니다.
선행 가정: 프롬프트와 컨텍스트 개념(4.4), 체인(4.2), 에이전트와 에이전트 루프(6.1, 6.3), 도구 호출(6.2), 에이전틱 RAG(5.14)를 이미 알고 있다고 가정합니다. 코드는 짧은 파이썬 조각만 나오며, 프레임워크 사용 경험은 필요하지 않습니다.
7.1 하네스 엔지니어링(Harness Engineering)
원문: What is Harness Engineering?
LLM 단독으로는 입력을 받아 출력을 돌려주는 일만 할 수 있습니다. 실제 서비스에서 쓰이려면 도구 호출, 기억, 오류 처리, 평가가 필요하며, 이 모두를 모델 바깥에서 감싸는 층을 설계하는 일이 하네스 엔지니어링입니다(2026년 4월 글 기준).
7.1.1 AI 하네스의 구성 요소
**하네스(harness)**는 시스템을 효과적으로 쓰고 관리하게 해 주는 제어 계층이며, **하네스 엔지니어링(Harness Engineering)**은 그 계층을 체계적이고 믿을 수 있게 만드는 모든 작업입니다. 비유하면 LLM은 엔진이고 하네스는 차체, 조향, 브레이크, 연료 계통, 계기판입니다. 엔진만으로는 어디에도 갈 수 없습니다. 코딩 어시스턴트, 챗봇, AI 검색 엔진 같은 제품은 모두 모델 둘레에 하네스를 갖고 있으며, 제품 품질은 하네스 품질에 직접 좌우됩니다.
- 좋은 모델과 나쁜 하네스를 결합하면 나쁜 경험이 나옵니다.
- 좋은 모델과 좋은 하네스를 결합하면 훌륭한 경험이 나옵니다.
- 실제 애플리케이션에서는 하네스 코드가 모델 연동 코드보다 훨씬 큰 경우가 많습니다.
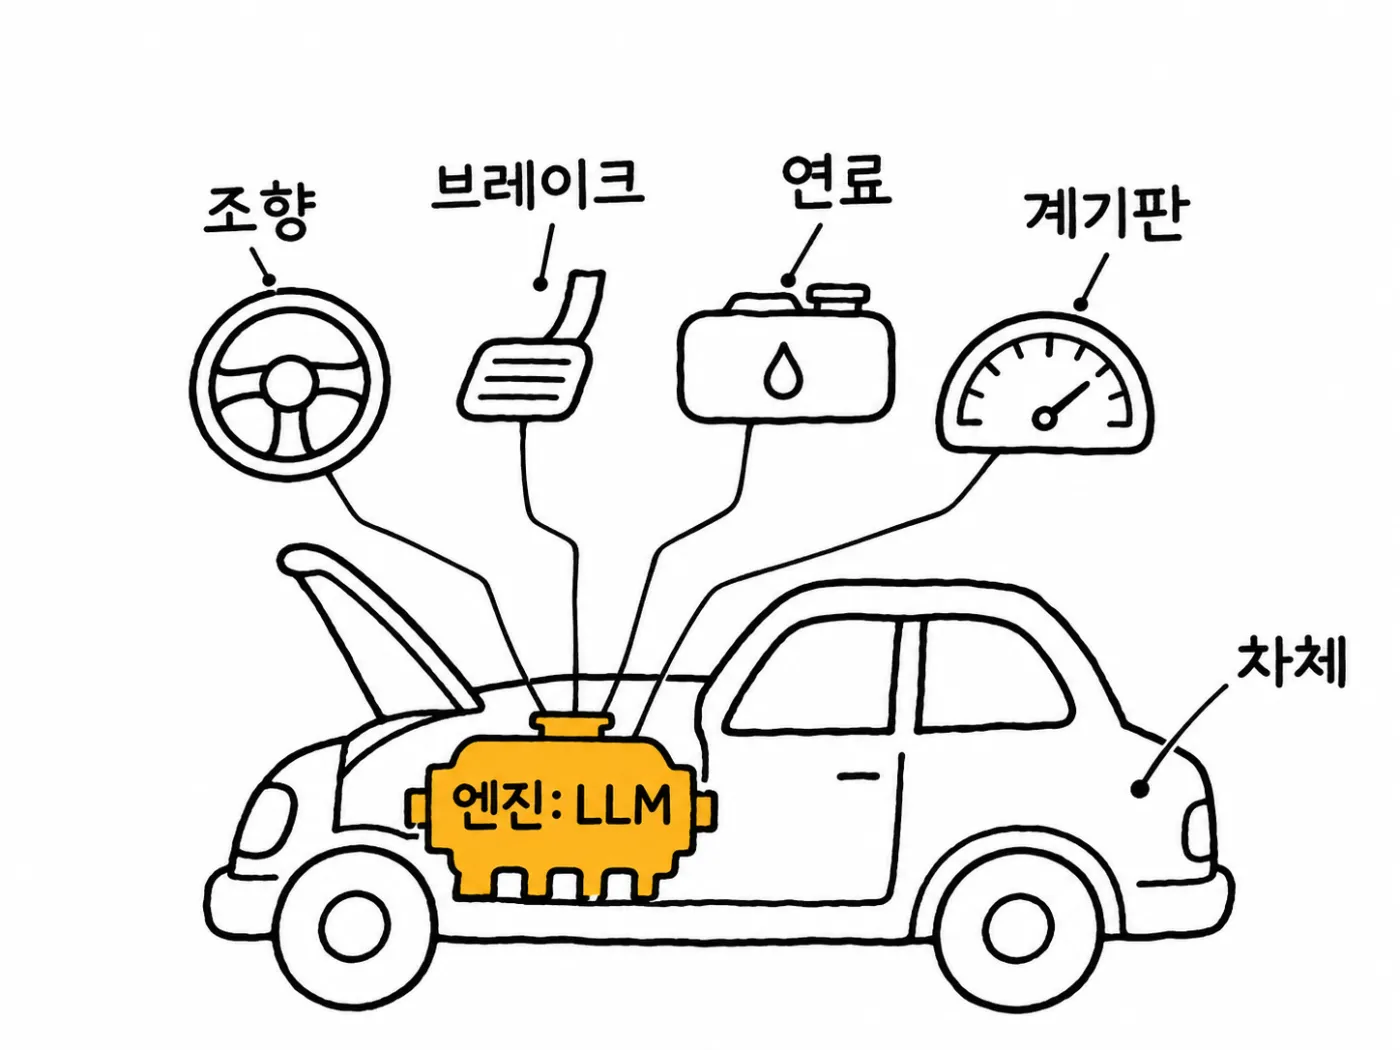
하네스가 맡는 일은 여섯 가지 구성 요소로 나뉩니다.
| 구성 요소 | 맡는 일 | 예 |
|---|---|---|
| 프롬프트 관리(Prompt Management) | 모델에 들어가는 시스템 프롬프트, 사용자 메시지, 템플릿, 컨텍스트를 관리 | 매 호출마다 올바른 지시를 보장 (4.4 참조) |
| 도구 오케스트레이션(Tool Orchestration) | 어떤 도구를 쓸 수 있는지, 어떻게 호출하는지, 결과를 어떻게 모델에 돌려주는지 관리 | 파일 읽기, 명령 실행, 웹 검색 (6.2 참조) |
| 메모리 관리(Memory Management) | 무엇을 남기고 무엇을 지울지 결정, 대화가 길어지면 오래된 메시지를 압축 | 이전 대화 요약 (4.5 참조) |
| 오류 처리(Error Handling) | 잘못된 출력, 실패한 도구 호출, API 오류를 받아 애플리케이션이 죽지 않게 함 | 재시도, 대체 경로 |
| 입출력 처리(Input and Output Processing) | 모델에 보내기 전 사용자 입력을, 사용자에게 보여주기 전 모델 출력을 파싱·포맷·검증·필터링 | JSON 형식 검증 |
| 가드레일(Guardrails) | 유해 콘텐츠 생성, 민감 정보 유출, 허용 범위 이탈을 막는 안전 검사 (9.1 참조) | 개인정보 마스킹 |
프롬프트 관리는 컨텍스트 엔지니어링이라 불리는 분야와 겹칩니다. 컨텍스트 엔지니어링은 하네스의 한 부분이며, 하네스는 그보다 넓은 범위(도구, 메모리, 오류, 가드레일)를 포함합니다. 프롬프트에 상시 올려두기에는 너무 긴 절차는 프롬프트 바깥에 두었다가 작업이 맞을 때만 하네스가 불러오게 할 수 있으며, 이것이 에이전트 스킬입니다(6.10 참조).
아래 순서도는 구성 요소가 한 요청 안에서 어떻게 이어지는지 단순화해서 보여줍니다.
flowchart TD
    A[사용자 입력] --> B[입력 처리: 정리·포맷]
    B --> C[프롬프트 관리: 컨텍스트와 지시 조립]
    C --> D[LLM: 응답 생성]
    D --> E[출력 처리: 파싱·검증]
    E --> F[도구 오케스트레이션: 필요 시 도구 실행]
    F --> G[메모리 관리: 대화 저장]
    G --> H[가드레일: 안전·규정 검사]
    H --> I[사용자에게 최종 출력]
그림 7.1.1 — 모델은 흐름의 한 칸이고 나머지 칸이 모두 하네스입니다. 도구 결과가 다시 모델로 돌아가는 반복은 에이전트 루프입니다(7.1.2 참조).
하네스를 만들 때 지켜야 할 실무 원칙은 여섯 가지입니다.
- 모듈로 나눕니다. 프롬프트, 도구, 메모리를 따로 두어야 한 부분을 바꿔도 다른 부분이 깨지지 않습니다.
- 전부 기록합니다. 입력, 출력, 도구 호출, 오류를 모두 로그로 남겨야 모델이 무엇을 했는지 추적됩니다.
- 가드레일(9.1 참조)은 첫날부터 넣습니다. 사고가 난 뒤에 붙이지 않습니다.
- 도구를 신뢰할 수 있게 만듭니다. 도구가 실패하면 재시도하거나 대체 경로를 쓰거나 모델에 실패를 알립니다.
- 모델만이 아니라 하네스를 테스트합니다. 하네스 코드에도 버그가 있으므로 다른 소프트웨어처럼 테스트를 작성합니다.
- 운영 중에 모니터링합니다. 지연, 오류, 비용, 품질을 지켜봐야 문제를 일찍 잡습니다(8.4 참조).
고객이 "모델을 더 좋은 것으로 바꾸면 되나요"라고 물을 때 FDE는 먼저 도구 실패 처리, 로그, 가드레일이 갖춰져 있는지 하네스 쪽부터 확인합니다. 모델 교체는 그다음 순서입니다.
7.1.2 에이전트용 하네스
AI 에이전트는 도구를 쓰고 판단하며 여러 행동을 이어 복잡한 작업을 끝내는 시스템입니다(6.1 참조). 에이전트용 하네스는 작업이 끝날 때까지 도는 에이전트 루프 전체를 관리해야 하므로 단순 호출용 하네스보다 복잡합니다. 단계 예산, 관찰, 종료 조건을 의도적으로 설계하는 일이 루프 엔지니어링입니다(7.2 참조).
흐름은 다섯 단계입니다.
- 하네스가 사용자 작업을 받아 시스템 지시, 사용 가능한 도구, 컨텍스트가 담긴 첫 프롬프트를 만듭니다.
- 하네스가 이를 모델에 보내 응답을 받습니다.
- 모델이 도구 사용을 제안했는지 확인하고, 그렇다면 하네스가 도구를 실행해 결과를 모델에 돌려줍니다.
- 모델이 작업 완료를 말할 때까지 2·3단계를 반복합니다.
- 최종 결과를 사용자에게 보여줍니다.
핵심은 역할 분담입니다. 모델은 어떤 도구를 부를지 결정만 하고, 도구를 실제로 실행하는 것은 하네스입니다. 모델이 생각하고 하네스가 운영하는 구조입니다.
원문의 날씨·이메일 예제를 따라가 보겠습니다. 사용자가 "델리 날씨를 찾아서 내 이메일로 보내줘"라고 요청합니다.
| 단계 | 주체 | 동작 |
|---|---|---|
| 1 | 하네스 | 도구 목록(weather_api, email_api)을 담아 프롬프트 준비 |
| 2 | 하네스 | 모델에 전송 |
| 모델 응답 | 모델 | "먼저 날씨를 확인하겠습니다" 하며 weather_api(city='Delhi') 호출을 요청 |
| 3 | 하네스 | weather_api 실행, 결과 "32°C, Sunny" |
| 4 | 하네스 | 결과를 모델에 전달 |
| 모델 응답 | 모델 | email_api(to=..., body='Weather in Delhi: 32°C, Sunny') 호출을 요청 |
| 5 | 하네스 | email_api 실행, 결과 "Email sent" |
| 6 | 하네스 | 결과를 모델에 전달 |
| 모델 응답 | 모델 | "완료했습니다. 델리 날씨(32°C, Sunny)를 찾아 이메일로 보냈습니다" |
| 7 | 하네스 | 최종 응답을 사용자에게 제시 |
모델이 한 일은 "무엇을 할지"를 말하는 세 번의 응답이고, 도구 실행과 전체 흐름 관리는 모두 하네스가 했습니다. 하네스가 없으면 에이전트는 작동하지 않으며, 하네스가 단순 모델을 강력한 에이전트로 바꿉니다. 실제 사례가 Claude Code이며 이 구조를 그대로 따릅니다(7.6 참조).
고객이 "AI가 이메일을 보냈다"고 말하더라도 실제 발송 권한은 하네스의 도구 코드에 있습니다. 권한 범위와 실패 시 동작을 점검하는 곳도 모델이 아니라 하네스입니다.
7.1.3 평가용 하네스
**평가용 하네스(evaluation harness)**는 AI 모델에 일련의 테스트를 돌려 성능을 측정하는 틀입니다. 수학 문제를 맞히는지 보려 한다면 정답이 알려진 수학 문제 데이터셋을 불러오고, 문제를 하나씩 모델에 보내고, 모델 답을 정답과 비교하고, 전체 점수를 계산합니다. 소프트웨어에서 테스트 케이스를 작성해 실행하고 결과를 확인하는 것과 같은 일을 모델에 합니다(8.1 참조).
평가용 하네스가 답해 주는 질문은 네 가지입니다.
- 모델이 얼마나 정확한가.
- 변경 뒤에 모델이 나아졌는가, 나빠졌는가.
- 한 모델이 다른 모델과 비교해 어떠한가.
- 어디에서 실패하는가.
이것이 없으면 수동으로 시험해야 하고, 느리며 믿을 수 없습니다.
정답이 하나로 정해지지 않는 열린 출력(챗봇 응답 등)은 규칙 기반 지표가 한계를 보이므로 평가용 하네스가 LLM-as-a-Judge로 품질을 채점하는 경우가 많습니다(8.2 참조). 에이전트는 최종 답만 보지 않고 궤적(trajectory), 도구 호출, 계획까지 채점합니다(8.3 참조).
용어 주의: 하네스 엔지니어링과 컨텍스트 엔지니어링은 같은 말이 아닙니다. 컨텍스트 엔지니어링은 하네스의 프롬프트 관리 부분에 해당하며, 하네스는 도구, 메모리, 오류 처리, 입출력 처리, 가드레일까지 포함합니다. 모델이 도구를 직접 실행한다는 이해도 틀립니다. 실행 주체는 하네스입니다.
고객이 "정확도가 좋아졌다"고 보고하면 FDE는 평가 데이터셋, 비교 기준, 실패 사례가 하네스에 고정되어 있는지 묻고, 수동 시험에 의존한 수치라면 변경 전후 비교가 가능하도록 평가용 하네스부터 갖추도록 제안합니다.
7.2 루프 엔지니어링(Loop Engineering)
에이전트는 한 번에 답하지 않고 생각하고, 행동하고, 결과를 보고, 다시 생각하는 순환을 반복합니다. 이 순환을 의도적으로 설계해 에이전트가 실제로 진전을 내고 알맞은 때에 알맞은 결과로 멈추게 하는 일이 **루프 엔지니어링(Loop Engineering)**입니다(2026년 8월 글 기준).
7.2.1 가장 단순한 루프와 그 문제
**루프(loop)**는 어떤 조건이 멈추라고 할 때까지 한 단계 뒤에 또 한 단계를 하는 반복이고, 엔지니어링은 그 반복을 규칙, 한도, 검사로 의도해서 설계하는 것입니다. 수프를 끓이는 요리사가 좋은 비유입니다. 맛을 보고, 간이 부족하면 소금을 한 꼬집 넣고, 다시 맛을 보다가 충분하면 내놓습니다. 맛을 전혀 보지 않는 요리사는 멈출 때를 모릅니다. 소금을 이미 넣은 사실을 잊으면 계속 넣습니다. 백 번 맛을 보면 수프가 식습니다. "충분히 좋다"를 정하지 못하면 영영 내놓지 못합니다. 루프 엔지니어링은 이런 문제를 막는 모든 작업이며, 에이전트에 그대로 대응됩니다.
| 주방 | 에이전트 |
|---|---|
| 요리사 | 다음 행동을 정하는 AI 모델 |
| 소금 한 꼬집 | 명령 실행, 파일 읽기 같은 행동 |
| 수프 맛보기 | 행동 결과 확인 |
| 이미 넣은 소금을 기억함 | 턴과 턴 사이로 이어지는 메모리 |
| "이 정도면 됐다" | 완료 기준(definition of done) |
| "식기 전에 내놓는다" | 허용되는 턴 수의 한도 |
필요한 이유는 단발 호출과 실제 작업의 차이에서 나옵니다. 이전에는 LLM을 자판기처럼 써서 질문 한 번에 답 한 번으로 끝났습니다. 그러나 "이 파일의 버그를 찾아 고쳐라"는 파일을 읽고, 테스트를 돌리고, 오류를 보고, 코드를 고치고, 다시 테스트를 돌려야 하는 연쇄입니다. 각 단계가 앞 단계의 결과에 의존하므로 자연히 루프가 됩니다. 모델이 루프 안에 들어가면 같은 말을 반복하고, 이미 한 일을 잊고, 원래 목표에서 벗어나고, 끝없이 돌며 비용을 태우고, 아무것도 되지 않았는데 성공을 선언하는 문제가 새로 생깁니다. 이는 프롬프트가 아니라 루프의 문제입니다. 실패한 테스트를 고치는 코딩 에이전트, 20페이지를 읽고 요약하는 리서치 에이전트, 주문과 환불 정책을 확인한 뒤 티켓을 올리는 지원 에이전트는 모두 뒤에서 루프로 돕니다. 같은 모델을 쓰더라도 루프를 잘 만든 쪽이 더 나은 에이전트를 내놓습니다.
여기서 반복해서 쓰는 말이 컨텍스트입니다. 컨텍스트는 이 순간 모델이 볼 수 있는 모든 것이며 에이전트의 작업 메모장입니다. 목표, 이전 단계, 모든 결과가 그 안에 있고, 모델에게는 다른 기억이 없습니다(2.16 참조). 루프 한 턴은 세 부분입니다.
- 생각(Think): 모델이 컨텍스트를 읽고 다음에 할 일을 정합니다.
- 행동(Act): 시스템이 모델이 요청한 일을 실행합니다. 모델은 바깥세상을 직접 만질 수 없어 도구를 요청합니다. 도구는 파일 읽기, 웹 검색, 명령 실행, 다른 서비스 조회 같은 작은 프로그램입니다(6.2 참조).
- 관찰(Observe): 행동 결과가 돌아와 컨텍스트에 추가됩니다.
그러면 턴이 끝나고 갱신된 컨텍스트로 다음 턴이 시작됩니다. 이 생각-행동-관찰 순환은 ReAct 에이전트의 패턴과 같습니다(6.4 참조). 중요한 점은 모델 자체는 루프를 돌지 않는다는 것입니다. 호출될 때마다 출력 하나를 낼 뿐이고, 루프는 우리가 모델 둘레에 쓰는 코드이므로 엔지니어링할 수 있습니다. 모델은 다음에 무엇을 할지 정하고, 루프는 실제로 무슨 일이 일어나는지 정합니다.
가장 기초적인 루프는 아래와 같습니다.
while True:
    decision = model(context)
    result = run_tool(decision.tool, decision.input)
    context = context + result
모델이 컨텍스트를 보고 도구를 고르고, 도구를 실행하고, 결과를 컨텍스트에 붙입니다. 작은 데모에서는 돌아가지만 실제에서는 네 가지로 무너집니다.
- 멈춤이 없습니다.
while True는 모델이 끝났다고 하지 않으면 천 번도 돕니다. - 컨텍스트가 늘기만 합니다. 날것의 도구 결과가 전부 붙어 스무 단계 뒤에는 거대하고 비싸고 잡음투성이가 됩니다.
- 오류 처리가 없습니다. 도구가 죽으면 루프 전체가 죽습니다.
- 완료 기준이 없습니다. 코드 어디에도 성공이 어떤 모습인지 아는 곳이 없습니다.
이 방식은 모델이 스스로를 관리할 것이라고 믿는다는 점이 근본 문제입니다. 고객이 에이전트 데모를 보여줄 때 FDE는 이 네 가지가 코드 어디에 있는지부터 묻습니다.
7.2.2 엔지니어링해야 할 루프 부품
루프에는 엔지니어가 결정해야 할 일곱 부품이 있습니다.
| 부품 | 결정할 것 | 약한 예 / 강한 예 |
|---|---|---|
| 목표(goal) | 끝났다는 것이 무엇인지 명시 | "버그를 고쳐라" / "test_login 테스트가 통과한다" (기계가 확인 가능) |
| 단계 예산(step budget) | 최대 턴 수, 소진되면 멈추고 못 끝냈다고 정직하게 보고 | 한도 없음 / 12턴 |
| 도구 | 허용된 행동 목록, 짧고 날카로운 목록이 겹치는 긴 목록보다 낫습니다. 잘못된 길이 적기 때문입니다 | 겹치는 도구 30개 / 역할이 분명한 도구 몇 개 |
| 관찰(observation) | 도구 실행 뒤 붙여 넣는 내용, 1만 줄 출력은 루프를 익사시키므로 자르거나 요약하거나 쪽으로 나눕니다 | 전체 출력 / 핵심 줄 |
| 메모리 | 턴 사이에 이어지는 것, 전체 이력은 정직하지만 비싸고 누적 요약은 싸지만 세부를 잃을 수 있습니다 (6.7 참조) | 전체 이력 vs 누적 요약 |
| 실패 피드백 | 오류 메시지는 가르침 신호 | "Error" / "src/mian.py 파일이 없음, src/main.py를 말씀하시나요" (다음 턴에 복구 가능) |
| 종료(exit) | 성공, 예산 소진, 반복 실패, 사람 요청 모두 처리 | 성공 한 가지만 처리 / 네 가지 모두 처리 |
이 부품을 코드에 반영한 개선판은 다음과 같습니다.
MAX_STEPS = 12

def run_agent(goal, context):
    for step in range(MAX_STEPS):
        decision = model(goal, context)      # 매 턴 목표를 함께 전달
        if decision.is_done:
            if verify(goal):                 # 주장을 믿지 않고 검사
                return decision.answer
            context = add(context, "Verification failed. Keep working.")
            continue
        try:
            result = run_tool(decision.tool, decision.input)
        except ToolError as e:
            result = f"Tool failed: {e}. Try a different approach."
        context = add(context, trim(result))
    return "Could not finish within the step budget."
바뀐 점은 여섯 가지입니다.
MAX_STEPS가 하드 상한이 되어 루프가 영원히 돌 수 없습니다.goal을 매 턴 전달하므로 에이전트가 가야 할 방향을 늘 압니다.decision.is_done이 모델에게 끝났다고 말할 정당한 통로를 줍니다.verify(goal)이 그 주장을 실제 코드로 검사하고, 실패하면 에이전트에게 알려 계속하게 합니다.try블록이 충돌을 메시지로 바꿔, 망가진 도구가 실행의 끝이 아니라 교훈이 됩니다.trim(result)가 관찰을 작게 유지해 컨텍스트를 깨끗하게 둡니다.
일곱 부품 가운데 가장 가치 있는 한 줄은 verify입니다. 이것이 없으면 테스트가 여전히 실패하는데도 에이전트가 버그가 고쳐졌다고 태연히 말합니다. 고객의 에이전트 요구사항을 받을 때 FDE는 "무엇이 되면 끝인가"를 기계가 검사할 수 있는 문장으로 바꾸는 일부터 합니다.
7.2.3 프롬프트 vs 컨텍스트 vs 루프 엔지니어링
세 이름은 비슷하게 들리지만 다루는 대상이 다릅니다. 프롬프트 엔지니어링은 지시 하나의 문구, 컨텍스트 엔지니어링은 메모장에 들어 있는 정보의 내용(4.4 참조), 루프 엔지니어링은 반복의 모양, 즉 몇 턴을 돌지, 턴 사이에 무엇이 바뀌고 이어지는지, 언제 끝나는지입니다.
| 비교 축 | 프롬프트 엔지니어링 | 컨텍스트 엔지니어링 | 루프 엔지니어링 |
|---|---|---|---|
| 작업 단위 | 지시 하나 | 컨텍스트 하나 | 실행 한 번 전체 |
| 핵심 질문 | 무엇을 말할까 | 모델이 무엇을 보는가 | 다음에 무슨 일이 일어나고 언제 멈추는가 |
| 전형적 수정 | 문구 다시 쓰기 | 정보 추가·삭제·재배열 | 예산, 검사, 더 나은 종료 추가 |
| 막는 실패 | 모호하거나 잘못 읽힌 답 | 혼란스럽거나 과부하된 모델 | 끝없거나 표류하거나 거짓으로 성공한 실행 |
| 통제하는 주체 | 프롬프트를 쓰는 사람 | 정보를 모으는 코드 | 모델을 거듭 호출하는 코드 |
프롬프트 엔지니어링은 모델이 무엇을 듣는지를, 컨텍스트 엔지니어링은 모델이 무엇을 아는지를, 루프 엔지니어링은 모델이 시간에 걸쳐 무엇을 하도록 허락되는지를 고칩니다. 문제 상황이 나오면 어느 층의 문제인지 먼저 가려야 합니다. 답이 모호하면 프롬프트, 모델이 헷갈려 하면 컨텍스트, 끝나지 않거나 거짓 성공이면 루프입니다. 한편 이 세 가지를 모두 포함하는 상위 개념이 하네스입니다(7.1 참조).
7.2.4 루프가 깨지는 방식
같은 실패가 반복해서 나타나며, 여섯 유형으로 분류됩니다.
| 유형 | 증상 | 원인 |
|---|---|---|
| 끝없는 루프(endless) | 계속 턴을 돌며 끝났다고 판단하지 않음 | 기계가 확인할 수 있는 완료 정의가 없음 |
| 반복하는 루프(repeating) | 같은 실패 명령을 네 번 연속 실행하며 다른 결과를 기대 | 실패 메시지에 새 정보가 없어 계획을 바꿀 이유가 없음 |
| 잊는 루프(forgetting) | 3턴에 풀었던 하위 문제를 15턴에 다시 풂 | 해결 내용이 컨텍스트에서 밀려난 메모리 설계 실패 |
| 표류하는 루프(drifting) | 로그인 버그를 고치다 DB 계층 전체를 다시 씀 | 각 단계는 합리적이나 도착지가 틀림, 원래 목표를 매 턴 반복하지 않음 |
| 거짓말하는 루프(lying) | 아무것도 검증하지 않고 완료를 선언 | 로그에는 성공으로 보이므로 가장 위험 |
| 비싼 루프(expensive) | 올바르게 끝났으나 90턴과 큰 청구서 | 날것의 도구 출력을 붙여 매 턴 다시 보냄 |
거짓말하는 루프가 가장 위험한 이유는 겉으로는 정상 종료로 기록되기 때문입니다. 고객이 에이전트 운영에서 "성공률"을 보고한다면 그 성공이 코드로 검증된 것인지, 에이전트의 자기 선언인지부터 구분해 묻습니다(8.3 참조).
7.2.5 루프 엔지니어링 기법
기법은 열한 가지이며, 위 실패와 짝지어집니다.
- 단계 예산을 둡니다. 한도에 닿으면 깨끗하게 멈춥니다. "12단계 안에 끝내지 못했고 여기까지 했다"고 보고하는 실행이 영영 돌아오지 않는 실행보다 훨씬 쓸모 있습니다.
- 완료를 기계가 확인하게 합니다. 코드가 "맞아 보인다"가 아니라 테스트를 돌려 컴퓨터가 보고하는 통과/실패를 읽게 합니다. 기계가 확인할 수 없는 목표는 루프가 안정적으로 끝낼 수 없습니다.
- 믿기 전에 검증합니다. 모델이 끝났다고 하면 우리가 직접 검사를 돌리고, 실패하면 그 사실을 컨텍스트에 넣어 루프를 이어갑니다.
- 매 턴 목표를 반복합니다. 원래 과제를 매 턴 컨텍스트 맨 위에 둡니다. 턴마다 몇 단어가 더 들지만 표류를 막는 가장 싼 처방입니다.
- 실패를 알려 주는 정보로 바꿉니다. 충돌 보고서 전체 대신 핵심 한 줄과 다음에 시도할 것을 짧게 붙입니다.
- 반복을 끊습니다. 같은 입력으로 같은 행동을 다시 시도하는 것을 감지해 막고 "이 명령은 이미 두 번 실패했으니 다른 방법을 시도하라"는 메시지를 넣습니다.
- 모든 관찰을 자릅니다. 긴 출력의 앞뒤 몇 줄, 검색 결과 상위 20개, 파일 전체 대신 관련 함수만 넣습니다.
- 이력을 압축합니다. 컨텍스트가 임계치를 넘으면 오래된 턴을 결정과 알게 된 사실만 남긴 짧은 요약으로 바꿉니다(4.5 참조).
- 먼저 계획하고 돌립니다. 첫 턴에 짧은 계획을 받아 컨텍스트에 두면 이후 턴이 모호한 기억이 아니라 적힌 목록으로 일하여 표류가 크게 줄어듭니다(6.5 참조).
- 하위 루프를 씁니다. 큰 단계는 자체 예산과 도구를 가진 별도 에이전트에 맡기고 최종 결과만 받습니다. 시끄러운 중간 단계가 자식 안에 머무르므로 부모 루프가 짧고 깨끗합니다(6.13 참조).
- 되돌릴 수 없는 단계에는 사람을 둡니다. 데이터 삭제, 이메일 발송, 송금, 운영 배포 앞에서는 루프가 멈추고 묻습니다.
| 실패 | 처방 |
|---|---|
| 끝없는 루프 | 단계 예산, 기계가 확인하는 결승선 |
| 반복하는 루프 | 더 나은 실패 메시지, 반복 행동 차단 |
| 잊는 루프 | 오래된 턴을 버리지 말고 이력 압축 |
| 표류하는 루프 | 매 턴 목표 반복, 먼저 계획 |
| 거짓말하는 루프 | 종료 전에 코드로 주장 검증 |
| 비싼 루프 | 모든 관찰 자르기, 하위 루프 |
완전한 예시로 목표를 "test_login이 통과해야 한다"로 두고 한 번 따라가 보겠습니다. 예산은 12턴입니다.
| 턴 | 일어난 일 |
|---|---|
| 1 | 목표를 읽고 테스트를 실행, 실패와 42번째 줄을 가리키는 오류. 출력은 목표, 실패한 테스트 이름, 오류 한 줄로 자름 |
| 2 | 42번째 줄과 주변 함수를 읽고 토큰이 생성되기 전에 비교됨을 발견 |
| 3 | 토큰 생성을 비교 위로 옮기도록 파일 수정 |
| 4 | 테스트 재실행, 다른 오류로 실패. 제자리걸음이 아니라 진전 중이라는 신호 |
| 5 | 새 오류에서 누락된 import를 보고 추가 |
| 6 | 테스트 통과, 에이전트가 완료를 말함 |
| 검증 | 루프가 믿지 않고 전체 테스트 스위트를 직접 한 번 더 실행, 모두 통과하여 종료하고 답을 반환 |
12턴 예산 중 6턴을 썼습니다(12 중 6, 절반 사용). 목표를 기계가 검사할 수 있어 끝이 의심스럽지 않았고, 오류 메시지가 정확히 한 줄을 가리켜 매 턴 계획이 바뀌었으며, 마지막 주장은 신뢰가 아니라 코드로 검증되었습니다.
루프가 잘 맞는 곳과 맞지 않는 곳은 분명히 갈립니다.
- 잘 맞는 곳: 테스트 통과, 빌드 성공, 파일 형식 일치처럼 기계가 확인하는 결승선이 있는 작업, 컴파일러·테스트 러너처럼 행동마다 정직한 피드백을 주는 환경, 틀린 단계를 싸게 되돌릴 수 있는 작은 단계로 쪼갤 수 있는 작업, 계획 전에 정보를 모아야 하는 긴 작업.
- 맞지 않는 곳: "이 에세이를 더 좋게"처럼 객관적 결승선이 없는 작업(너무 일찍 멈추거나 영영 멈추지 않습니다), 실수가 30분 뒤에야 드러나는 느리거나 침묵하는 피드백 환경, 되돌릴 수 없는 행동(자유롭게 실험하는 루프는 운영 시스템과 실제 돈에 맞지 않습니다), 수백 개의 사실을 컨텍스트에 담아야 하는 아주 긴 작업(요약이 정보를 떨구기 시작하며 잊는 루프가 나타납니다).
인접한 개념과의 경계는 이렇습니다. 프롬프트 엔지니어링은 한 문장, 컨텍스트 엔지니어링은 모델이 보는 것, 그래프 엔지니어링은 한 단계에서 다음 단계로 가는 경로를 정하며(7.3 참조), 루프 엔지니어링은 첫 턴부터 마지막 턴까지의 실행 전체를 정합니다. 에이전트가 더 긴 일을 맡을수록 일이 끝나는지는 프롬프트의 영리함보다 루프의 품질이 가릅니다. FDE는 고객 과제에 "기계가 검사하는 결승선이 있는가, 되돌릴 수 있는가"를 먼저 물어 에이전트 적합 여부를 가립니다.
7.3 그래프 엔지니어링(Graph Engineering)
원문: What is Graph Engineering?
작업은 한 단계로 끝나지 않고, 되돌아가고 기다리고 검사하고 승인받는 여러 단계로 이루어집니다. **그래프 엔지니어링(Graph Engineering)**은 AI 시스템을 그래프로 설계하는 실무로, 작업의 각 단계를 노드로, 한 단계에서 다른 단계로 가는 길을 엣지로 두어 어떤 단계 다음에 어떤 단계가 실행될지를 우리가 명확히 정합니다(2026년 8월 글 기준).
7.3.1 한 프롬프트·체인·루프·그래프 네 접근 비교
**그래프(graph)**는 두 가지로 이루어집니다. **노드(node)**는 무언가가 일어나는 곳이고 **엣지(edge)**는 한 곳에서 다른 곳으로 이어 주는 길입니다. 도시 지하철 노선도를 떠올리면 됩니다. 역이 노드이고 두 역 사이의 선로가 엣지입니다.
| 지하철 노선도 | AI 시스템 |
|---|---|
| 역 | 노드: 작은 작업 한 단계 |
| 두 역 사이의 선로 | 엣지: 다음 단계로 가는 길 |
| 승객이 든 가방 | 상태(state): 함께 이동하는 정보 |
| 첫 역 | 시스템이 시작하는 단계 |
| 마지막 역 | 시스템이 멈추는 단계 |
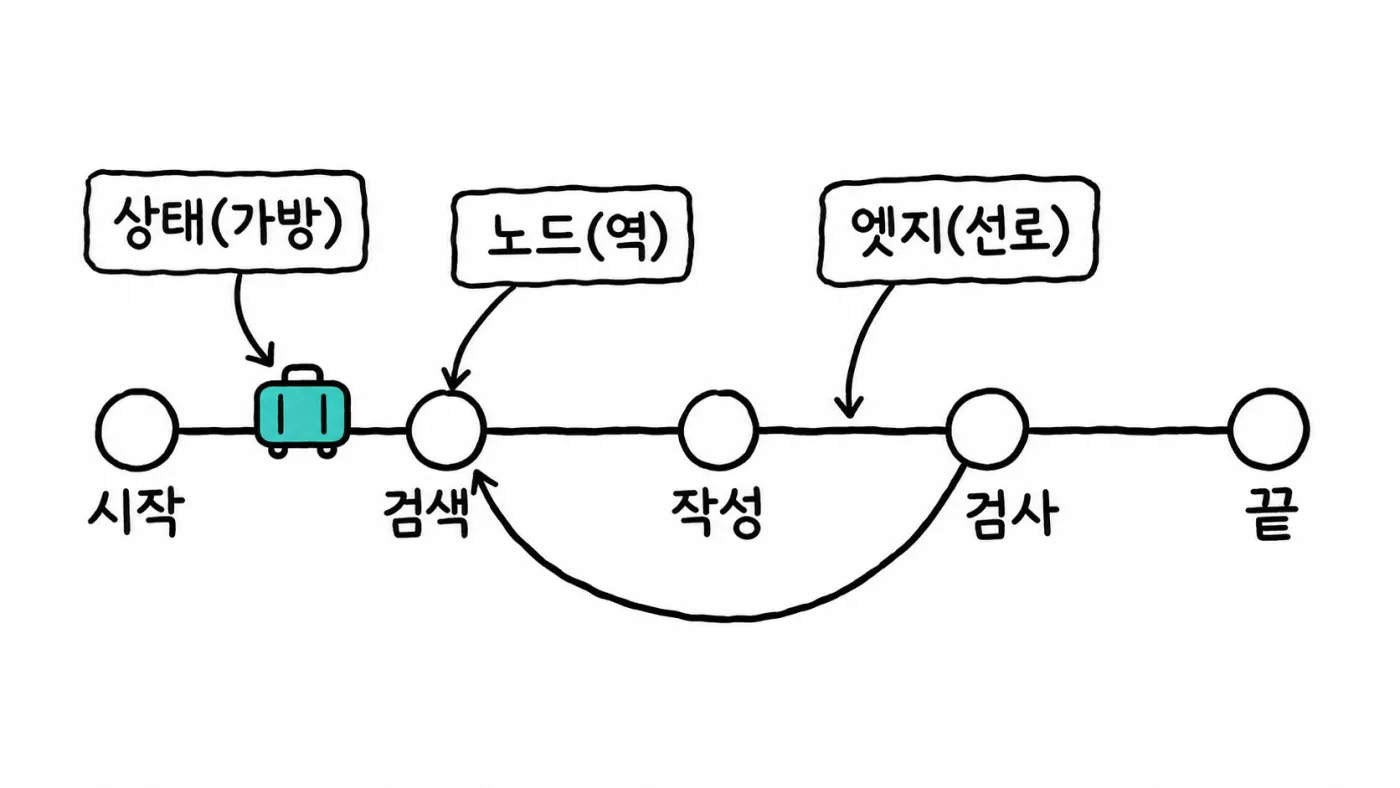
엣지는 "이 단계가 끝나면 어느 단계가 실행되는가"라는 작은 질문에 대한 답입니다. 필요성은 사내 문서에 대해 질문하면 출처가 붙은 정확한 답을 내는 시스템을 만든다고 가정하고 네 가지 접근을 차례로 보면 드러납니다.
- 접근 1, 하나의 큰 프롬프트. "질문을 읽고, 문서를 검색하고, 결과를 읽고, 답을 쓰고, 정확한지 확인하고, 출처를 붙이고, 부족하면 다시 검색하라"를 한 번에 지시합니다. 모델은 일부만 하고 나머지를 조용히 잊습니다. 검색 없이 답을 쓰거나, 검색하고도 검증하지 않습니다. 결과가 틀려도 모든 일이 호출 한 번 안에서 일어났으므로 어느 부분이 틀렸는지 알 수 없습니다. 구조가 전혀 없다는 것이 문제입니다.
- 접근 2, 단계의 체인. 이해 → 검색 → 작성 → 전송으로 호출을 나눕니다(4.2 참조). 단계마다 일이 하나이므로 실패한 단계를 압니다. 그러나 체인은 직선으로 앞으로만 가고 돌아오지 못합니다. 검색이 쓸모없는 결과를 내거나 답이 틀려 다시 써야 해도 나쁜 답을 그대로 전달합니다.
- 접근 3, 하나의 루프. 전체를 에이전트 루프에 넣으면 다시 검색하고 다시 쓰고 스스로 고칠 수 있습니다(7.2 참조). 그러나 반대쪽 극단에 도달합니다. 모든 결정을 모델이 하므로 통제가 거의 없습니다. 같은 실패 검색을 열 번 반복하고, 자신이 있다고 검증 단계를 건너뛰고, 그 순간 호출하길 원하지 않았던 위험한 도구를 부릅니다. 실행마다 경로가 달라 테스트도 어렵습니다.
- 접근 4, 그래프. 접근 2의 작은 단계와 접근 3의 되돌아가는 능력을 모두 가져오되 경로를 우리가 직접 적습니다.
flowchart LR
    U[understand] --> S[search]
    S --> W[write]
    W --> C[check]
    C -->|답이 좋음| E[send]
    C -->|출처 없음| S
    C -->|답이 약함| W
그림 7.3.1 — 모든 단계가 작고 보이며, 필요할 때 되돌아갈 수 있고, 모델은 우리가 허용한 지점에서만 결정을 내립니다.
이처럼 검색하고, 작성하고, 검사하고, 다시 검색하는 구성이 에이전틱 RAG입니다(5.14 참조). 고객이 "한 프롬프트로 다 시키고 있는데 가끔 틀린다"고 호소하면, 어느 단계가 틀렸는지 볼 수 없는 구조 자체가 원인인지부터 확인합니다.
7.3.2 노드·엣지·상태
모든 그래프는 세 부분뿐입니다.
- 노드: 작업 한 단계이며 함수입니다. 현재 정보를 받아 작은 일을 하고 갱신된 정보를 돌려줍니다. 모델 호출, 도구 호출, DB 조회, 모델 없는 일반 코드 모두 노드가 될 수 있습니다.
- 엣지: 노드에서 노드로 가는 길이며, 다음에 어떤 노드가 실행되는지만 답합니다.
- 상태: 그래프의 공용 노트입니다. 모든 노드가 여기서 읽고 여기에 씁니다. 그래서 두 번째 노드가 첫 번째 노드가 한 일을 압니다.
문서 질의응답 시스템의 상태는 다음과 같습니다.
state = {
    "question": "What is our refund policy?",
    "intent": None,
    "documents": [],
    "answer": None,
    "score": None,
    "attempts": 0,
}
비어 있는 노트이며, 그래프가 돌면서 노드가 채웁니다. understand가 intent, search가 documents, write가 answer, check가 score와 attempts를 채웁니다. 상태 설계는 그래프 엔지니어링에서 가장 중요한 설계 결정입니다. 상태가 깨끗하면 그래프가 단순하고, 임의의 키가 쌓인 쓰레기장이 되면 이해할 수 없습니다. 노드가 모델 앞에 놓는 정보도 이 상태에서 나오므로 상태를 깨끗이 유지하는 일은 컨텍스트 엔지니어링이기도 합니다(4.4 참조).
첫 그래프의 노드는 평범한 함수입니다. 각각 한 가지만 하고 갱신된 상태를 반환합니다.
def understand(state):
    state["intent"] = model.find_intent(state["question"])
    return state

def search(state):
    state["documents"] = db.search(state["intent"])
    return state

def write(state):
    state["answer"] = model.write_answer(state["question"], state["documents"])
    return state
그리고 엣지로 잇고 시작과 끝을 지정합니다.
graph = Graph(state)
graph.add_node("understand", understand)
graph.add_node("search", search)
graph.add_node("write", write)
graph.add_edge("understand", "search")
graph.add_edge("search", "write")
graph.set_entry("understand")
graph.set_finish("write")

final_state = graph.run(state)
print(final_state["answer"])
그래프가 노드에서 노드로 걷고 각 노드가 노트를 갱신하며 마지막에 같은 노트에서 답을 읽습니다. 잘 돌아가지만 아직 직선이어서 접근 2와 같습니다. 원문의 코드는 이해를 위해 단순화한 것이며, 실제 라이브러리도 노드·엣지·상태라는 같은 세 개념을 이름만 조금 달리해 제공합니다. 가장 널리 쓰이는 것이 LangGraph입니다(7.5 참조).
상태 키마다 값의 의미와 채우는 노드를 적은 표를 먼저 만들자고 제안하는 것이 FDE가 고객 팀과 설계를 시작하는 좋은 방법입니다.
7.3.3 조건부 엣지와 사이클
일반 엣지는 늘 같은 다음 노드로 갑니다. **조건부 엣지(conditional edge)**는 상태를 먼저 보고 다음에 실행할 노드를 정합니다. 답에 점수를 매기는 check 노드를 더합니다. 모델이 검토자로 쓰이는 LLM-as-a-Judge 패턴입니다(8.2 참조).
def check(state):
    state["score"] = model.rate_answer(state["answer"], state["documents"])
    state["attempts"] = state["attempts"] + 1
    return state

def route_after_check(state):
    if state["score"] >= 8:
        return "send"
    if not state["documents"]:
        return "search"
    return "write"
결정은 평범한 코드이며 완전히 우리 손에 있습니다. 점수가 좋으면 send, 문서가 없으면 search, 그 밖에는 write로 돌아가 다시 씁니다. 연결은 다음과 같습니다.
graph.add_node("check", check)
graph.add_node("send", send)
graph.add_edge("write", "check")           # 모든 답이 검토로 감
graph.add_conditional_edge("check", route_after_check)
graph.set_finish("send")                   # 끝 지점을 write에서 send로 이동
점수는 모델이 줬지만 길은 우리 코드가 골랐습니다. 이것이 그래프 엔지니어링의 핵심으로, 모델은 생각하고 흐름의 통제권은 우리가 쥡니다.
check가 write로, write가 다시 check로 가는 왕복이 **사이클(cycle)**입니다. 쓰고 검토하고 더 낫게 쓰고 다시 검토하는 자기 교정의 방식이며 Reflection 에이전트의 발상과 같습니다(6.6 참조). 그러나 사이클은 영원히 돌 수 있습니다. 검토자가 8점을 주지 않으면 돈이 바닥날 때까지 쓰고 검사합니다. 따라서 모든 사이클에는 중단 조건이 있어야 하며, check에서 시도 횟수를 세던 이유가 이것입니다.
def route_after_check(state):
    if state["score"] >= 8:
        return "send"
    if state["attempts"] >= 3:
        return "ask_human"     # 세 번 시도 후 사람에게 넘김
    if not state["documents"]:
        return "search"
    return "write"

graph.add_node("ask_human", ask_human)
graph.add_edge("ask_human", "send")
세 번 시도한 뒤에는 스스로 하지 않고 ask_human 노드로 사람에게 넘기고, 이 슬픈 경로도 send로 이어져 마지막 역에 닿습니다. 노드를 추가하고 엣지를 이어야 그래프가 길이 어디로 가는지 압니다. 완성된 그래프는 다음과 같습니다.
| 출발 | 도착 | 조건 |
|---|---|---|
| understand | search | 항상 |
| search | write | 항상 |
| write | check | 항상 |
| check | send | 점수가 좋음 |
| check | ask_human | 세 번 시도 소진 |
| check | search | 문서가 없음 |
| check | write | 답이 약함 |
| ask_human | send | 항상 |
한 번의 실행에서 노트가 어떻게 변하는지 따라가 보겠습니다. 질문은 "What is our refund policy?"입니다.
| 단계 | 노드 | 상태 변화 |
|---|---|---|
| 1 | (시작) | intent·answer·score는 None, documents는 [], attempts는 0 |
| 2 | understand |
intent = "refund policy duration and conditions" |
| 3 | search |
documents = ["policy-v3.pdf", "faq-refunds.md"] |
| 4 | write |
answer = "Refunds are allowed within 30 days." |
| 5 | check |
답에 출처가 없어 score = 5, attempts = 1 |
| 6 | 조건부 엣지 | 5점으로 8점 미만, 문서 있음, 시도 1회로 3 미만이므로 write로 복귀 |
| 7 | write |
answer = "Refunds are allowed within 30 days of purchase, as per policy-v3.pdf." |
| 8 | check |
score = 9, attempts = 2 |
| 9 | 조건부 엣지 | 8점 이상이므로 send, 종료 |
시스템이 스스로 실수를 찾아 고쳤으면서도 모든 경로를 우리가 적었기에 통제를 벗어나지 않았습니다. 이제 안전하고 예측 가능하게 실패합니다. 모든 사이클에는 하드 한도가 있어야 합니다. 고객 설계안에서 되돌아가는 화살표가 있다면 FDE는 그 화살표의 횟수 한도와 한도 소진 시 도착 노드를 먼저 확인합니다.
7.3.4 병렬 분기
서로 무관한 두 단계는 한꺼번에 돌려야 시간을 아낍니다. 사내 문서 검색과 공개 웹 검색은 완전히 독립적입니다.
graph.add_edge("understand", "search_docs")
graph.add_edge("understand", "search_web")
graph.add_edge("search_docs", "merge")
graph.add_edge("search_web", "merge")

def merge(state):
    state["documents"] = state["doc_results"] + state["web_results"]
return stateunderstand에서 나가는 엣지가 둘이라 두 검색이 함께 시작되며 이를 **팬아웃(fan-out)**이라 합니다. 두 검색이 같은 merge 노드를 가리키므로 그래프는 둘이 모두 끝나기를 기다린 뒤 계속하며 이를 **팬인(fan-in)**이라 합니다. merge가 두 결과를 documents에 합치므로 그래프의 나머지는 검색이 두 번 있었다는 사실을 알 필요가 없습니다. 팬아웃과 팬인은 여러 단계를 조율하는 대표 패턴입니다(6.15 참조).
주의할 규칙은 하나입니다. 동시에 도는 노드는 상태의 서로 다른 키에 써야 합니다. 같은 키에 쓰면 한쪽이 조용히 다른 쪽을 덮어써서 원인을 찾는 데 몇 시간이 듭니다. 병렬 설계를 검토할 때 FDE는 각 분기가 쓰는 키를 표로 적어 겹침을 확인합니다.
7.3.5 체크포인트: 중단과 재개
긴 그래프는 모델과 도구와 느린 서비스를 기다립니다. 실행 도중 서버가 재시작되면 단순 루프는 모든 것을 잃고 사용자가 처음부터 다시 시작해야 합니다. **체크포인팅(checkpointing)**은 각 노드가 끝날 때마다 상태를 저장하는 방식이며, 저장된 상태가 체크포인트입니다. 문제가 생기면 마지막 체크포인트를 불러 그 노드부터 이어갑니다.
graph = Graph(state, checkpointer=Database())
final_state = graph.run(state, thread_id="user-123")
그래프에 저장소를 주고 이 실행에 id를 붙였습니다. 노드가 끝날 때마다 이 id로 상태가 저장되므로, search 노드 뒤에서 실행이 깨졌다면 같은 thread_id로 run을 다시 호출했을 때 understand가 아니라 write부터 시작합니다. 시스템의 전체 진행이 평범한 상태 객체 하나에 있기 때문에 가능하며, 상태를 깨끗이 유지하는 또 하나의 이유입니다. 장시간 작업을 약속하는 고객에게는 저장소가 어디이고 thread_id를 무엇으로 묶는지를 묻습니다.
7.3.6 휴먼 인 더 루프(Human in the Loop)
고객에게 이메일 보내기, 환불 처리, 레코드 삭제, 운영 앱에 코드 올리기는 사람의 승인 없이 일어나서는 안 됩니다. 작업이 노드로 나뉘어 있으므로 그런 노드 앞에서 그래프를 멈출 수 있습니다.
graph.add_node("send_email", send_email, interrupt_before=True)그래프가 send_email에 이르면 상태를 저장하고 일시 정지하며 아직 아무것도 보내지 않습니다. 사람이 대기 중인 작업을 열어 초안을 읽고 판단합니다.
if human_says_yes:
    graph.resume(thread_id="user-123")
else:
    graph.update_state(thread_id="user-123", changes={"answer": edited_answer})
    graph.resume(thread_id="user-123")
사람은 계속 진행을 허락하거나, 상태 안의 답을 먼저 고친 뒤 허락할 수 있습니다. 그래프는 사람이 만졌는지 알지 못하며 상태를 읽고 앞으로 갈 뿐입니다. 자동화의 속도와 사람 검토의 안전을 함께 얻는 방법입니다. 일시 정지는 체크포인트 덕분에 가능하므로 두 기능은 한 묶음입니다. FDE는 고객의 업무에서 되돌릴 수 없는 행동을 목록으로 만들어 각각 앞에 승인 노드를 두자고 제안합니다.
7.3.7 그래프 내부 오류 처리
도구도 네트워크도 실패하고 모델도 깨진 출력을 냅니다. 큰 프롬프트 하나에서는 실패가 전체를 죽이지만, 그래프에서는 한 노드가 잘못 동작했을 뿐이며 그 실패를 다른 정보처럼 상태에 담을 수 있습니다.
def search(state):
    try:
        state["documents"] = db.search(state["intent"])
        state["error"] = None
    except Exception:
        state["error"] = "search service is down"
    return state

def route_after_search(state):
    if state["error"]:
        return "search_web"
    if not state["documents"]:
        return "ask_human"
    return "write"

graph.add_conditional_edge("search", route_after_search)
실패를 잡아 상태에 쓰고, 그 오류를 읽어 다음을 정하는 라우팅 함수로 search의 일반 엣지를 바꿨습니다. 이제 실패는 그래프의 정상 경로입니다. 자체 검색이 내려가면 웹 검색으로 대체하고, 답할 근거가 전혀 없으면 사람에게 묻습니다. 아무것도 죽지 않고 사용자는 항상 어떤 응답을 받습니다. 하네스의 오류 처리 원칙을 그래프 구조로 구현한 것입니다(7.1 참조). 고객과 장애 시나리오를 점검할 때 FDE는 "이 도구가 죽으면 어느 노드로 가는가"를 노드마다 묻습니다.
7.3.8 그래프 vs 루프 엔지니어링
루프 엔지니어링은 에이전트 하나가 루프 안에서 생각하고 다음 행동을 스스로 정하며 일이 끝났다고 느끼면 멈추는 방식입니다. 그래프 엔지니어링은 작은 단계 여럿을 두고 단계 사이의 경로를 우리가 적어 둡니다.
| 비교 축 | 루프 엔지니어링 | 그래프 엔지니어링 |
|---|---|---|
| 다음 단계 결정 | 모델이 결정 | 모델 출력을 쓰되 우리 코드가 결정 |
| 구조 | 생각-행동의 루프 하나 | 엣지로 이어진 여러 노드 |
| 실행마다의 경로 | 매번 다름 | 같은 상황이면 같은 경로 |
| 테스트 | 경로가 계속 바뀌어 어려움 | 노드 하나씩 테스트 가능 |
| 버그 찾기 | 모델이 한 모든 일의 긴 이력을 읽음 | 실패한 노드 하나를 봄 |
| 모델의 자유 | 높음 | 우리가 허용한 곳에서만 |
| 적합한 일 | 열려 있고 미지의 작업 | 단계가 분명한 알려진 작업 |
그래프가 잘 맞는 일은 다음과 같습니다.
- 단계가 분명한 일. 지원 티켓, 환불 처리, 문서 검토, 보고서 작성은 자연스러운 단계의 모양이 있습니다.
- 승인이 필요한 일. 어느 노드에서든 멈출 수 있어 사람 검토가 자연스럽게 들어갑니다.
- 반복 가능해야 하는 일. 같은 입력이 같은 경로를 타므로 테스트하고 신뢰할 수 있습니다.
- 오래 걸리는 일. 체크포인트로 재시작을 견디며 몇 시간, 며칠도 이어갑니다.
- 독립된 부분이 있는 일. 병렬 분기가 여러 검색이나 검사를 함께 끝냅니다.
- 설명해야 하는 일. 노드별로 지나간 경로를 그대로 보여줄 수 있어 은행, 의료, 법률에서 의미가 큽니다.
잘 맞지 않는 경우도 있습니다.
- 완전히 열려 있는 일. 단계의 이름조차 붙일 수 없으면 그래프는 추측이므로 루프가 낫습니다.
- 아주 단순한 일. 모델 호출 하나로 답이 나오면 그래프는 일만 늘립니다.
- 관리 없이 커진 그래프. 노드 60개에 엣지가 사방으로 뻗으면 큰 프롬프트보다 나쁩니다. 혼란이 여러 파일로 퍼집니다.
- 지저분한 상태. 노드마다 키를 더하고 아무도 지우지 않으면 상태가 폐기장이 되어 노드를 단독으로 이해할 수 없습니다.
- 숨은 의존성. 어떤 이전 노드만 쓰는 키를 다른 노드가 몰래 필요로 하면 노드 순서를 바꿀 때 찾기 어려운 방식으로 깨집니다.
- 한도 없는 사이클. 중단 조건 하나가 빠지면 밤새 맴돌고 한 바퀴마다 비용을 냅니다.
설계 실무 원칙은 열 가지로 요약됩니다.
- 노드는 작게. 한 노드 한 일이며, 한 문장으로 설명할 수 없으면 둘로 쪼갭니다.
- 상태를 먼저 설계. 노드를 쓰기 전에 모든 키, 담는 값, 채우는 노드를 적습니다.
- 결정은 산문이 아니라 코드에. 모델은 점수, 라벨, 선택을 내고 우리 코드가 읽어 길을 고릅니다. 이 습관 하나가 통제의 대부분을 줍니다.
- 모든 사이클에 한도. 시도 횟수를 상태에 세고 초과 시 출구를 둡니다.
- 항상 출구. 슬픈 경로까지 모든 경로가 끝에 닿아야 합니다. 어디에도 가지 않는 경로는 멈춘 시스템입니다.
- 실패를 경로로. 오류를 상태에 쓰고 그것으로 라우팅합니다.
- 종이에 그려 봅니다. 그릴 수 없으면 팀원도 사용자도 이해하지 못하며, 그릴 수 없는 그래프는 너무 복잡합니다.
- 노드마다 로그. 어느 노드가 실행됐고 무엇이 들어가 무엇이 나왔는지 남기면 문제 노드로 곧장 갑니다(8.4 참조).
- 노드별 테스트. 노드는 상태에서 상태로 가는 함수이므로 고정된 상태로 모델 없이 단독 테스트할 수 있습니다.
- 직선에서 시작. 가장 단순한 경로부터 만들고 분기, 사이클, 병렬은 실제 문제가 요구할 때 더합니다.
용어 주의: 프롬프트 체이닝은 직선으로만 가고 돌아오지 못하는 점에서 그래프와 다릅니다. LangGraph는 그래프 엔지니어링이라는 실무를 구현한 가장 대표적인 라이브러리이지 같은 말이 아닙니다. 노드가 모두 AI 모델을 호출해야 하는 것도 아닙니다.
아이디어는 단순합니다. 작업을 작은 단계로 쪼개고, 단계 사이의 경로를 적고, 모든 진행을 하나의 공유 상태에 둡니다. 그러면 AI 시스템은 가끔 되는 블랙박스에서 보고, 테스트하고, 멈췄다 재개하고, 고치고, 누구에게든 설명할 수 있는 시스템이 됩니다. 모델은 계속 생각하고, 그 생각이 어디로 가는지는 그래프가 정합니다. FDE는 고객의 업무가 단계가 분명한 일인지, 열린 일인지를 먼저 가려 그래프와 루프 중 어느 쪽 비중을 둘지 판단 기준을 제시합니다.
7.4 LangChain
LLM을 부르는 일 자체는 쉽지만, 자체 문서 검색, 대화 기억, 계산기·검색 호출, 답변 정리를 직접 이어 붙이면 코드가 지저분해집니다. LangChain은 이 부품들을 미리 만들어 두고 조립하게 해 주는 프레임워크입니다(2026년 7월 글 기준).
7.4.1 핵심 아이디어
LangChain은 LLM 기반 애플리케이션을 만들도록 돕는 프레임워크이며, 우리와 LLM 사이에 놓여 LLM을 우리의 데이터, 도구, 로직과 연결합니다. 이름은 Lang(언어 모델)과 Chain(여러 단계를 차례로 잇는 것)의 결합입니다. 한 프롬프트의 출력이 다음 프롬프트의 입력이 되도록 이어 붙이는 발상이 프롬프트 체이닝입니다(4.2 참조). LLM 자체가 아니라는 점에 유의해야 합니다. 텍스트를 받아 텍스트를 내는 모델은 LLM이고, LangChain은 그 둘레를 구성하는 틀입니다.
필요한 이유는 실제 앱의 요구에서 나옵니다. 질문을 받고, 자체 문서에서 답을 찾고, 앞선 대화를 기억하고, 필요할 때 계산기나 검색 엔진을 부르고, 최종 답을 깔끔한 형식으로 내야 합니다. 이를 손으로 하면 모든 부품을 붙이는 접착 코드를 쓰고, 단계 순서를 관리하고, 단계 사이로 넘어가는 데이터를 처리해야 합니다. 만들기도 어렵고 유지하기는 더 어렵습니다. LangChain은 레고 조각 같은 블록을 주고, 블록은 각자 한 가지 일을 하며 LangChain이 이어 줍니다.
핵심 발상은 "작은 블록을 사슬로 이어 완성된 흐름을 만든다"입니다. 자동차 조립 라인과 같습니다. 차체를 만들고, 엔진을 달고, 바퀴를 고정하고, 도색합니다. 각 작업대가 한 가지 일을 하고 차를 다음 작업대로 넘깁니다.
| 조립 라인 | LangChain |
|---|---|
| 들어오는 원재료 | 사용자 입력 |
| 작업대 하나 | 블록 하나 |
| 앞으로 가는 차 | 다음 단계로 넘어가는 데이터 |
| 완성된 차 | 최종 답 |
고객이 "LangChain으로 만들었다"고 하면 FDE는 어떤 블록(템플릿, 메모리, 검색, 도구)을 쓰고 있는지를 묻고, 그 블록마다 책임이 분리되어 있는지를 봅니다. 하네스의 구성 요소와 거의 겹치는 이름이므로 대응시켜 읽을 수 있습니다(7.1 참조).
7.4.2 LLM과 프롬프트 템플릿
첫 블록은 앱의 두뇌인 LLM입니다. LLM에 보내는 텍스트, 즉 LLM에게 주는 지시가 프롬프트입니다. 그런데 프롬프트의 일부는 사용자에 따라 바뀌므로 **프롬프트 템플릿(Prompt Template)**이 필요합니다. 런타임에 채울 빈칸이 있는 미리 만든 프롬프트입니다.
from langchain_core.prompts import PromptTemplate

template = PromptTemplate.from_template(
    "Explain {topic} in simple words for a beginner."
)
prompt = template.format(topic="LangChain")topic이라는 빈칸이 있는 템플릿을 만들고 format에 topic="LangChain"을 넘기면 빈칸이 채워져 "Explain LangChain in simple words for a beginner."라는 최종 프롬프트가 됩니다. 같은 프롬프트를 값만 바꿔 재사용하게 해 줍니다. 템플릿을 쓰지 않고 문자열을 여기저기서 이어 붙이면 어느 변수가 어디에 들어가는지 추적하기 어려워집니다. FDE는 고객의 프롬프트가 코드 곳곳에 흩어져 있다면 템플릿 한 곳으로 모으자고 제안합니다(4.4 참조).
7.4.3 체인(Chain)과 출력 파서
**체인(Chain)**은 여러 블록을 이어 한 블록의 출력이 다음 블록으로 흐르게 한 파이프라인입니다. 템플릿이 사용자 주제를 채우고 LLM이 그 프롬프트를 읽어 답하는 두 단계가 가장 단순한 체인입니다.
from langchain_openai import ChatOpenAI
from langchain_core.prompts import PromptTemplate

llm = ChatOpenAI(model="gpt-4o-mini")
template = PromptTemplate.from_template("Explain {topic} in simple words for a beginner.")

chain = template | llm
result = chain.invoke({"topic": "LangChain"})
| 기호는 파이프이며 "왼쪽의 출력을 오른쪽으로 보낸다"는 뜻입니다. template | llm은 채워진 프롬프트가 곧장 LLM으로 들어간다는 의미이고, invoke에 주제를 넘기면 데이터가 체인을 따라 흘러 결과가 나옵니다. 작은 블록을 파이프로 잇는 것이 LangChain의 심장입니다.
그런데 LLM은 평범한 텍스트를 냅니다. 과일 세 개를 물으면 "apple, banana, mango"라는 문자열이 오지만, 코드에서는 세 항목이 나뉜 실제 리스트가 필요합니다. **출력 파서(Output Parser)**가 LLM의 원본 텍스트를 깨끗한 구조로 바꿔 줍니다.
from langchain_core.output_parsers import StrOutputParser

parser = StrOutputParser()
chain = template | llm | parser
result = chain.invoke({"topic": "LangChain"})
체인에 parser 블록이 하나 더 붙어 데이터가 세 블록을 지납니다. 템플릿이 프롬프트를 채우고, LLM이 답을 내고, 파서가 그 답을 단순한 문자열로 정리합니다. StrOutputParser는 전체 메시지 객체 대신 깨끗한 텍스트만 돌려줍니다.
flowchart LR
    A["사용자 입력 {topic}"] --> T[Template: 빈칸을 채움]
    T -->|"채워진 프롬프트"| L[LLM: 읽고 답함]
    L -->|"답변 텍스트"| P[Parser: 깨끗한 결과로 정리]
    P --> R[결과]
그림 7.4.3 — 데이터가 왼쪽에서 오른쪽으로 흐르고, 블록 사이의 파이프가 앞 블록의 출력을 다음 블록으로 나릅니다.
출력 파서가 중요한 이유는 하네스의 입출력 처리와 같은 맥락입니다(7.1 참조). 고객 시스템이 LLM 답을 후속 코드에 넘긴다면 FDE는 형식 검증 지점이 파서 단계에 있는지 확인합니다.
7.4.4 메모리
앱과 대화하며 "Albert Einstein이 누구야?"라고 묻고 정확한 답을 받은 뒤 "그는 어디서 태어났어?"라고 묻는다고 합시다. 앱은 "그"가 누구인지 모릅니다. LLM 호출은 매번 새로 시작하며 스스로 과거를 기억하지 않기 때문입니다. **메모리(Memory)**는 대화의 이전 메시지를 저장해 앱이 맥락을 기억하게 하는 LangChain의 부분입니다(6.7 참조).
작동은 이렇습니다. 사용자가 새 메시지를 보낼 때마다 LangChain이 메모리에서 이전 메시지를 꺼내 새 프롬프트에 붙입니다. 그러면 LLM은 마지막 메시지만이 아니라 전체 대화를 봅니다.
# 1턴: 메모리에 저장 "User: Who is Albert Einstein?"
# 2턴: 메모리 + 새 메시지를 함께 전송
#  User: Who is Albert Einstein?
#  AI: Albert Einstein was a famous physicist.
#  User: Where was he born?
2턴에서 이전 대화가 새 질문 앞에 붙기 때문에 LLM은 "he"가 Albert Einstein임을 압니다. 메모리가 맥락을 앞으로 나릅니다. 다만 이 방식은 대화가 길수록 프롬프트가 길어지므로, 길어진 이력을 어떻게 줄일지는 별도 설계가 필요합니다(4.5 참조). FDE는 고객 챗봇이 "그건 무슨 뜻이죠" 같은 지시어에 답하지 못하면 이전 메시지가 프롬프트에 실제로 포함되고 있는지부터 확인합니다.
7.4.5 검색과 RAG
LLM은 인터넷의 일반 데이터로 학습되어서 우리 회사 문서, 개인 메모, 최신 파일은 모릅니다. 200쪽짜리 회사 핸드북에서 답하게 하려면 검색(Retrieval), 즉 우리 데이터에서 가장 관련 있는 조각을 가져와 질문과 함께 LLM에 주는 방식을 씁니다. 이 패턴 전체가 **RAG(Retrieval-Augmented Generation)**이며, 먼저 알맞은 정보를 검색하고 LLM이 그 정보를 써서 답을 생성합니다.
다섯 단계로 진행됩니다.
- 큰 문서를 청크라는 작은 조각으로 나눕니다(5.6 참조).
- 각 청크를 임베딩, 곧 의미를 비교할 수 있도록 텍스트를 숫자 목록으로 바꾼 표현으로 변환합니다(2.6 참조).
- 임베딩을 **벡터 저장소(Vector Store)**에 저장합니다. 정확한 단어가 아니라 의미로 검색하도록 만든 데이터베이스입니다(5.1 참조).
- 사용자가 질문하면 질문도 임베딩으로 바꿔 벡터 저장소에서 가장 가까운 청크를 찾습니다(5.3 참조).
- 맞는 청크와 질문을 LLM에 보내고 LLM이 이를 활용해 답합니다.
flowchart TD
    D[문서] --> C[청크] --> E[임베딩] --> V[(Vector Store)]
    Q[사용자 질문] --> QE[질문 임베딩] -->|의미로 검색| V
    V --> M[일치하는 청크]
    M --> PR[질문 + 청크를 한 프롬프트로 결합]
    PR --> LLM[LLM] --> A[답변]
그림 7.4.5 — 위쪽 절반은 데이터를 한 번 준비하는 과정이고, 질문이 들어올 때마다 검색과 생성이 실행됩니다.
단순화한 코드는 다음과 같습니다.
relevant_chunks = vector_store.similarity_search("What is the leave policy?")
chain = prompt_with_context | llm | parser
result = chain.invoke({
    "context": relevant_chunks,
    "question": "What is the leave policy?"
})
휴가 정책과 관련된 청크를 벡터 저장소에서 찾아 질문과 함께 체인에 넘기면 LLM이 우리 데이터를 읽고 답합니다. 이 패턴을 더 확장한 것이 에이전틱 RAG입니다(5.14 참조). 답이 틀릴 때 FDE는 청크 분할, 검색 결과, 프롬프트에 들어간 문맥을 순서대로 열어 어느 단계가 문제인지 가립니다.
7.4.6 도구와 에이전트
LLM은 언어에는 강하지만 정확한 계산은 약하고 지금의 실시간 정보도 모릅니다. "델리의 지금 날씨는?"은 날씨 서비스와 연결이 없어 답할 수 없습니다. **도구(Tool)**는 계산기, 검색 엔진, 날씨 서비스처럼 LLM이 스스로 못 하는 일을 대신 하도록 실행되는 외부 함수입니다.
사람들이 자주 틀리는 점이 있습니다. LLM은 도구를 직접 실행하지 않습니다. 어떤 도구를 어떤 입력으로 쓸지 추천할 뿐이고, 실제 호출은 우리 코드가 합니다. LLM은 조언자이고 코드는 실행자입니다(6.2 참조). 그렇다면 그 추천을 받아 실제로 도구를 돌리는 쪽이 **에이전트(Agent)**입니다. 에이전트는 LLM을 써서 어떤 도구를 어떤 순서로 쓸지 정하고, 도구를 실행하고, 결과를 받아 LLM에 주는 일을 작업이 끝날 때까지 하는 똑똑한 제어기입니다. 루프로 일합니다(6.3 참조). 에이전트는 LLM을 두뇌로, 도구를 손으로 씁니다.
"25 곱하기 18은 얼마이며, 400보다 큰가?"를 따라가 보겠습니다.
| 단계 | 일어난 일 |
|---|---|
| 1 | 에이전트가 질문을 LLM에 보내고, LLM이 계산기 도구와 입력 25 * 18을 추천 |
| 2 | 에이전트가 계산기에 25 * 18을 실행, 결과 450 |
| 3 | 에이전트가 450을 LLM에 돌려주고, LLM이 450과 400을 비교해 450이 크다고 판단 |
| 4 | LLM이 최종 답을 구성: "25 times 18 is 450, which is more than 400." |
곱셈은 추측하지 않았고 에이전트가 실제 도구로 계산한 뒤 LLM이 그 결과를 추론했습니다. 그래서 답을 믿을 수 있습니다. 에이전트의 단계, 결정, 루프가 복잡해지면 그래프로 펼쳐 프레임워크가 돌리게 할 수 있습니다(7.5 참조).
이제 전체 흐름을 한 이야기로 이어 보겠습니다. 사용자가 회사 핸드북에 관한 질문을 합니다. 1) 질문을 입력합니다. 2) LangChain이 메모리에서 이전 메시지를 꺼내 맥락으로 추가합니다. 3) 검색으로 벡터 저장소에서 일치하는 청크를 가져옵니다. 4) 프롬프트 템플릿이 질문, 메모리, 검색된 청크를 하나의 최종 프롬프트로 결합합니다. 5) 이 프롬프트가 체인을 따라 LLM으로 흐릅니다. 6) 행동이 필요하면 LLM이 도구를 추천하고 에이전트가 실행해 결과를 LLM에 돌려줍니다. 7) LLM이 답을 만듭니다. 8) 출력 파서가 답을 깔끔한 형태로 정리합니다. 9) 정리된 답이 사용자에게 가고 새 메시지는 다음 턴을 위해 메모리에 저장됩니다.
| 블록 | 역할 | 흐름 속 위치 |
|---|---|---|
| Memory | 이전 메시지 보관 | 프롬프트 앞에 맥락을 공급, 마지막에 새 메시지 저장 |
| Retrieval / Vector Store | 관련 청크 검색 | 프롬프트에 근거 공급 |
| Prompt Template | 질문·메모리·청크 결합 | LLM 직전 |
| LLM | 추론, 도구 추천 | 중심 |
| Agent / Tools | 도구 실행 | 필요할 때 LLM과 왕복 |
| Parser | 답 정리 | LLM 직후 |
각 블록이 한 가지 일을 하고 결과를 다음 블록에 넘기는 것이 처음에 본 조립 라인입니다. 고객이 LangChain 기반 앱의 품질을 호소하면 FDE는 이 여섯 블록 가운데 어느 블록의 입출력이 문제인지 하나씩 열어 확인하는 순서로 진단을 진행합니다.
7.5 LangGraph
LangGraph는 그래프 엔지니어링을 코드로 쓸 수 있게 만든 프레임워크입니다(7.3 참조). 작업을 노드와 엣지의 그래프로 기술하면, 공유 상태가 단계 사이를 오가고 프레임워크가 그 그래프를 실행해 줍니다(2026년 7월 글 기준).
7.5.1 그래프와 상태(State)
LangGraph는 작업을 단계의 그래프로 조직하는 LLM 기반 애플리케이션 프레임워크입니다. 이름은 Lang(언어 모델)과 Graph(단계를 잇는 방식)의 결합이며, LangChain과 같은 팀이 만들어 그 발상 위에 그래프, 루프, 분기를 더했습니다(7.4 참조). 앱을 단계의 집합으로 기술하면 어떤 단계가 어떤 순서로 실행되고 다음에 무슨 일이 일어나는지를 LangGraph가 통제합니다.
필요한 이유는 고객 지원 어시스턴트를 만들어 보면 드러납니다. 사용자 메시지를 읽고, 결제 문의인지 기술 문제인지 판단하고, 맞는 문서를 검색하고, LLM으로 답을 쓰게 하고, 때로는 보내기 전에 사람의 승인을 받아야 합니다. 이 단계들은 직선이 아닙니다. 결정을 내리고, 되돌아가 재시도하고, 이전 일을 기억하고, 사람을 기다려 멈춰야 합니다. 이를 if와 else로만 쓰면 코드가 빠르게 지저분해져 읽기도 바꾸기도 어렵습니다. LangGraph는 이 단계와 결정을 그래프로 명확히 기술하고 실행합니다.
그래프는 선으로 이어진 점들의 모음입니다. 노드는 점이며 일의 한 조각이고, 엣지는 한 점을 다음 점으로 잇는 선입니다. A, B, C 세 원과 A→B, B→C 화살표가 그래프이며, 그래프는 A에서 시작해 B를 거쳐 C로 갑니다. 집에서 사무실로 가고 다시 집으로 돌아오는 지도에서 집과 사무실이 노드, 길이 엣지입니다.
**상태(State)**는 그래프를 따라 이동하는 공유 메모리, 즉 모든 노드가 읽고 쓸 수 있는 정보 상자입니다. 주문 처리라면 노드 1이 사용자 메시지를 상태에 넣고, 노드 2가 그 메시지를 읽어 장바구니 항목을 넣고, 노드 3이 모두 읽어 최종 답을 씁니다. 노드끼리 서로 직접 호출하지 않고 공유 상태를 읽고 쓰기만 하며, 상태는 그래프 전체를 붙잡는 접착제입니다(7.3.2 참조).
from typing import TypedDict

class State(TypedDict):
    message: str
reply: strTypedDict는 담을 값의 이름과 타입을 선언하는 사전입니다. 이 상태는 사용자 입력 message와 만들어낼 답 reply 두 가지를 담습니다.
다음 표는 단순 LLM 호출과 LangGraph를 가르는 기준을 보여줍니다.
| 상황 | 단순 LLM 호출 | LangGraph |
|---|---|---|
| 질문 하나, 답 하나 | 가장 알맞음 | 불필요 |
| 순서가 있는 여러 단계 | 관리 어려움 | 관리 쉬움 |
| 결정과 분기 | if/else로 지저분 |
조건부 엣지로 깔끔 |
| 재시도 위한 되돌아감 | 어려움 | 내장 지원 |
| 도구·행동 호출 | LLM은 추천만 가능 | 에이전트가 도구 호출 |
| 이전 실행 기억 | 수작업 | 체크포인터가 처리 |
| 사람을 위한 일시 정지 | 어려움 | 휴먼 인 더 루프 지원 |
질문 하나에 답 하나면 프레임워크 없이 호출 하나로 충분합니다. 고객 요구에 분기, 루프, 도구, 기억, 사람 검토가 둘 이상 나오면 그때 LangGraph를 검토 대상으로 올립니다.
7.5.2 노드·엣지·조건부 엣지
노드는 현재 상태를 받아 상태의 갱신을 돌려주는 파이썬 함수입니다. 상태를 읽고 무언가를 하고 바꾸고 싶은 부분만 돌려줍니다.
def write_reply(state: State):
    user_message = state["message"]
    answer = "Thanks for your message: " + user_message
return {"reply": answer}write_reply는 message를 읽어 짧은 답을 만들고 새 reply를 담은 사전을 돌려줍니다. LangGraph가 이 반환값으로 공유 상태를 갱신하며, 노드는 반환한 것 외에는 아무것도 바꾸지 않습니다. 엣지는 노드가 끝난 뒤 어디로 갈지 알려 주는 화살표입니다. 모든 그래프에는 시작점 START와 끝점 END가 있으며 첫 노드를 START에, 마지막 노드를 END에 연결합니다.
일반 엣지는 늘 같은 다음 노드로 갑니다. **조건부 엣지(conditional edge)**는 현재 상태를 보고 다음 노드를 고르는 엣지로, 길의 갈림길과 같습니다. 메시지가 결제 문의면 결제 노드로, 기술 문의면 기술 노드로 가는 결정이 조건부 엣지에서 이루어집니다.
def route_message(state: State):
    if "bill" in state["message"]:
        return "billing"
    return "technical"
메시지에 bill이 들어 있으면 문자열 billing을, 아니면 technical을 돌려주고, LangGraph가 이 반환 문자열을 읽어 일치하는 노드로 그래프를 보냅니다. 그래프가 서로 다른 방향으로 갈라질 수 있게 됩니다. 이 라우팅은 키워드 한 개로 가른 단순화한 예이므로 실제 분류는 더 정교해야 합니다. 라우팅 함수는 평범한 코드이므로 FDE가 고객 규칙(예: 환불 금액이 기준을 넘으면 승인 경로)을 그대로 적어 넣고 테스트할 수 있습니다(7.3.3 참조).
7.5.3 전체 예제
위의 결제/기술 지원 예제를 처음부터 끝까지 조립합니다. 먼저 상태와 두 노드를 정의합니다.
from typing import TypedDict
from langgraph.graph import StateGraph, START, END

class State(TypedDict):
    message: str
    reply: str

def billing(state: State):
    return {"reply": "This is the billing team. We will help you with your payment."}

def technical(state: State):
    return {"reply": "This is the technical team. We will help you fix the issue."}
billing 노드는 결제 팀의 답을, technical 노드는 기술 팀의 답을 씁니다. StateGraph는 그래프를 만드는 빌더이고, START와 END는 시작과 끝점입니다. 그다음 앞의 route_message 함수를 다시 쓰고 그래프를 짜 맞춥니다.
builder = StateGraph(State)
builder.add_node("billing", billing)
builder.add_node("technical", technical)

builder.add_conditional_edges(START, route_message)
builder.add_edge("billing", END)
builder.add_edge("technical", END)

graph = builder.compile()State를 주고 StateGraph를 만들고, add_node로 두 노드를 더하고, START에서 add_conditional_edges로 route_message가 다음 노드를 고르게 하고, 두 노드에서 END로 엣지를 잇습니다. 마지막 compile이 기술한 내용을 실행 가능한 그래프로 바꿉니다.
flowchart LR
    S([START]) -->|"메시지에 bill 포함"| B[billing]
    S -->|"그 외"| T[technical]
    B --> E([END])
    T --> E
그림 7.5.3 —
START에서 조건부 엣지가 갈림길을 만들고 두 노드 모두END로 끝납니다.
실행해 보겠습니다.
| 호출 | 경로 | 출력 |
|---|---|---|
graph.invoke({"message": "I have a question about my bill"}) |
bill이 있어 결제 경로 |
"This is the billing team. We will help you with your payment." |
graph.invoke({"message": "My app is not working"}) |
bill이 없어 기술 경로 |
"This is the technical team. We will help you fix the issue." |
invoke에 시작 상태를 넘기면 그래프가 메시지를 읽고, 조건부 엣지가 경로를 고르고, 노드가 reply를 쓰고, 최종 상태가 돌아옵니다. 최종 상태에는 message와 reply가 모두 채워져 있습니다. 두 번째 호출에서 알 수 있듯 bill이라는 단어가 없으면 결제 문의여도 기술 경로로 갑니다. 규칙 기반 라우팅의 경계 사례를 고객 데이터로 시험해 보는 것이 첫 점검 항목입니다.
7.5.4 도구를 호출하는 주체
LLM은 텍스트를 받아 텍스트만 돌려줍니다. 웹을 검색하거나, DB를 읽거나, 이메일을 보내지 못하고 단어만 만들 수 있습니다. **도구(tool)**는 웹 검색이나 DB 읽기 같은 실제 행동을 하는 평범한 함수입니다. 혼동하기 쉬운 지점이 있습니다. LLM은 도구를 호출하지 않고 어떤 도구를 쓸지 추천만 합니다. 사용자 요청을 읽고 "검색 도구를 쓰고 입력은 weather in Delhi여야 한다"라는 텍스트를 반환할 뿐 아무것도 실행하지 않습니다.
tool:  search
input: weather in Delhi
실제로 도구를 부르는 쪽은 LLM 둘레에서 도는 코드, 곧 에이전트입니다. LangGraph가 그 에이전트 역할을 합니다. 추천을 읽고, 실제 도구 함수를 호출하고, 결과를 받아 LLM에 돌려줍니다. LLM은 환자를 보고 처방전을 쓰는 의사이고 에이전트는 처방전을 읽고 약을 실제로 내주는 약사입니다. 의사는 약을 추천할 뿐 건네지 않습니다. 이 구조의 이름이 함수 호출입니다(6.2 참조).
| 단계 | 일어난 일 |
|---|---|
| 1 | 사용자가 질문 |
| 2 | LLM이 질문을 읽고 도구와 입력을 추천, 실행하지 않음 |
| 3 | 에이전트가 추천을 읽고 도구를 실제로 호출 |
| 4 | 도구가 실행되어 결과를 반환 |
| 5 | 에이전트가 결과를 LLM에 돌려줌 |
| 6 | LLM이 결과를 읽고 최종 답을 씀 |
LangGraph에서는 LLM이 한 노드이고 도구가 다른 노드입니다. LLM 노드 뒤의 조건부 엣지가 "LLM이 도구를 추천했는가"를 확인해 그렇다면 도구 노드로 가 도구를 돌리고 결과를 가진 채 LLM 노드로 되돌아오며, 아니라면 최종 답과 함께 END로 갑니다. 추천, 호출, 응답의 루프를 깔끔하게 돌릴 수 있어 에이전트 제작에 유용합니다(6.3 참조).
flowchart TD
    Q[사용자 질문] --> L1[LLM 노드: 도구 추천, 호출은 하지 않음]
    L1 -->|도구 추천 있음| T[도구 노드: 실제 호출·결과 획득]
    T -->|결과 전달| L1
    L1 -->|추천 없음| E([END: 최종 답])
그림 7.5.4 — 조건부 엣지가 LLM 노드와 도구 노드 사이의 루프를 열고 닫습니다.
고객이 "AI가 삭제했다"고 말해도 삭제 함수를 부른 쪽은 에이전트 코드입니다. 권한과 확인 절차를 거는 곳이 거기라는 점을 설계 검토에서 짚습니다(7.1.2 참조).
7.5.5 메모리와 영속성
LangGraph의 메모리는 그래프가 여러 실행에 걸쳐 상태를 기억하는 것입니다. 메모리가 없으면 그래프는 끝나는 순간 모든 것을 잊고, 있으면 상태를 저장했다가 같은 지점에서 이어갑니다. 채팅 어시스턴트에서 사용자가 "My name is Amit"라고 말한 뒤 나중에 "What is my name?"이라고 물으려면 첫 메시지를 기억해야 합니다.
LangGraph는 **체크포인터(checkpointer)**로 메모리를 더합니다. 체크포인터는 각 단계 뒤 상태를 저장하는 작은 도우미이며, 사용자가 돌아오면 저장된 상태를 불러와 이어갑니다. 앱이 긴 대화를 하고 떠난 자리에서 정확히 이어갈 수 있고 상태가 사라지지 않고 안전하게 저장되므로 이를 **영속화(persisted)**라 부릅니다(7.3.5 참조). 에이전트 메모리의 일반 구조는 6.7을 참조합니다. 고객 서비스가 재시작이나 사용자 재방문에 이전 맥락을 잃는다면 저장소와 대화 식별자가 연결되어 있는지가 첫 질문입니다.
7.5.6 휴먼 인 더 루프
**휴먼 인 더 루프(Human-in-the-loop)**는 그래프가 멈춰 사람이 한 단계를 확인하거나 승인한 뒤에 앞으로 가게 하는 기능입니다. AI가 전부 혼자 행동하길 원하지 않는 작업을 위한 것입니다. 어시스턴트가 고객에게 환불이 걸린 답을 썼다면 자동으로 환불해서는 안 되므로 그래프를 멈추고, 사람이 답을 검토하고, 승인 후에야 계속합니다.
체크포인터가 상태를 저장하므로 어떤 노드에서든 멈추고 기다릴 수 있습니다. 사람이 상태를 확인하고 결정하면 그래프가 정확히 그 지점에서 재개되므로, 중요한 업무 흐름에서 통제와 안전을 얻습니다. 즉 휴먼 인 더 루프가 체크포인터에 의존하는 이유는 저장된 상태가 있어야 멈춘 자리를 되찾기 때문입니다(7.3.6 참조).
LangGraph의 각 부품은 일상의 역할로 옮겨 기억할 수 있습니다.
| LangGraph 부품 | 일상의 역할 |
|---|---|
| State | 모두가 쓰는 공유 노트 |
| Node | 한 가지 일을 하는 작업자 |
| Edge | 한 작업자에서 다음 작업자로 가는 길 |
| Conditional edge | 갈림길 |
| Tool | 웹 검색 같은 실제 행동 |
| LLM | 도구를 추천만 하는 조언자 |
| Agent | 도구를 실제로 호출하는 작업자 |
| Checkpointer | 저장 버튼 |
| Human-in-the-loop | 일을 승인하는 관리자 |
용어 주의: LangGraph의 노드는 서로 직접 호출하지 않고 공유 상태를 읽고 씁니다. 에이전트는 별도 제품이 아니라 LLM 둘레에서 도구를 실행하는 코드를 가리킵니다. 그래프 엔지니어링은 실무이고(7.3 참조), LangGraph는 그 실무를 돕는 프레임워크입니다.
LangGraph로 앱을 짠다는 것은 노드와 엣지로 AI 앱을 기술하고, 공유 상태로 데이터를 나르고, 조건부 엣지로 결정하고, 체크포인터로 기억과 사람 승인을 얻는다는 뜻입니다. FDE는 고객 요구를 이 아홉 개 부품으로 번역해 보고, 부품에 대응되지 않는 요구가 있는지 확인하는 방식으로 도입 여부를 판단합니다.
7.6 Claude Code
원문: How does Claude Code work?
Claude Code는 에이전트 하네스의 실제 사례입니다(7.1 참조). 모델이 판단하고, 도구가 눈과 손이 되며, 루프가 둘을 잇고, 메모리·권한·훅이 통제를 맡는 구조를 한 제품에서 모두 볼 수 있습니다(2026년 7월 글 기준).
7.6.1 에이전트 루프
Claude Code는 Anthropic이 만든, 터미널에서 도는 코딩 에이전트입니다. 평범한 영어로 작업을 주면 코드를 읽고, 파일을 고치고, 명령을 실행하고, 스스로 결과를 확인해 작업을 끝냅니다. 터미널은 명령을 입력해 텍스트로 결과를 받는 창이고, 에이전트는 질문에 답하는 데 그치지 않고 목표를 이루기 위해 스스로 행동하는 프로그램입니다(6.1 참조). 새로 입사한 개발자에게 "로그인 페이지에 버그가 있으니 고쳐 주세요"라고 하면 파일을 일일이 복사해 달라고 하지 않고 프로젝트를 열어 로그인 코드를 검색하고, 읽고, 고치고, 테스트를 돌린 뒤 끝났다고 알려 줍니다. Claude Code가 그 개발자처럼 일합니다. 중심에는 Anthropic이 만든 모델 Claude가 있습니다.
일반 AI 챗봇과의 차이는 버그를 상담하는 상황에서 드러납니다. 프로젝트의 코드를 복사해 채팅에 붙이면 챗봇이 고친 코드를 답하고, 그것을 다시 프로젝트에 복사해 넣고, 테스트는 직접 돌립니다. 실패하면 오류를 복사해 다시 붙입니다. 챗봇에는 세 가지 한계가 있습니다.
- 프로젝트를 볼 수 없습니다. 실제 프로젝트는 파일이 수백, 수천 개인데 붙여 넣은 일부만 봅니다.
- 아무것도 할 수 없습니다. 텍스트만 만들 수 있어서 모든 변경을 사람 손으로 해야 합니다.
- 답을 검증할 수 없습니다. 제안한 코드가 실제로 도는지 모릅니다.
사람이 챗봇과 컴퓨터 사이의 전령이 되어 복사와 붙여넣기를 반복하는 구조입니다. Claude Code는 모델에 한 번도 가져 본 적 없는 눈과 손, 곧 도구를 줍니다. 모델은 무엇을 할지 결정하는 두뇌이고 도구는 그것을 실제로 하는 수단입니다.
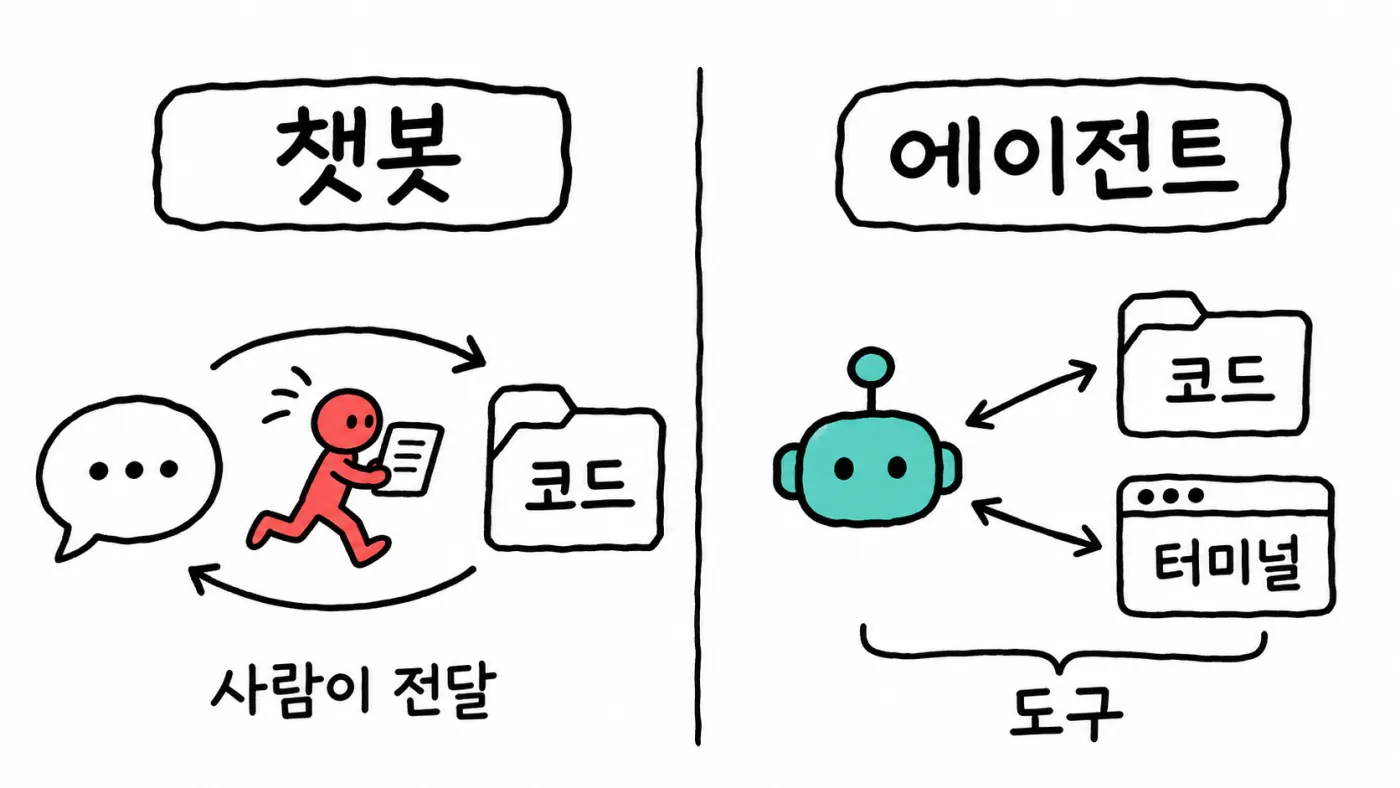
Claude Code의 심장은 **에이전트 루프(agent loop)**입니다. 작업을 받으면 세 단계를 거칩니다(6.3 참조).
| 단계 | 하는 일 |
|---|---|
| 맥락 수집(gather context) | 프로젝트 파일을 검색하고 읽어 손대기 전에 코드를 이해 |
| 행동(take action) | 파일 수정·생성, 명령 실행 |
| 결과 검증(verify results) | 테스트나 프로그램을 돌려 변경이 실제로 동작하는지 확인 |
검증이 실패하면 멈추지 않고 되돌아가 오류를 읽고 다시 시도하며, 작업이 끝날 때까지 이어집니다. 단계 예산, 되먹임하는 오류 메시지, 종료 조건을 의도적으로 설계하는 일이 루프 엔지니어링입니다(7.2 참조). 사람도 이 루프의 일부로서 언제든 끼어들어 고치거나 정보를 더할 수 있습니다. 스스로 일하되 사람의 말을 듣습니다.
flowchart TD
    R[사용자 요청] --> G[맥락 수집]
    G --> A[행동]
    A --> V[결과 검증]
    V -->|미완료| G
    V -->|완료| D[작업 완료]
그림 7.6.1 — 세 단계가 미완료인 동안 되돌아가며 반복됩니다.
고객이 코딩 에이전트 도입을 검토하면 FDE는 챗봇식 복사-붙여넣기 흐름에서 에이전트 흐름으로 바꿀 때 사람의 일이 무엇에서 무엇으로 이동하는지를 먼저 그려 보여줍니다.
7.6.2 Claude Code의 도구
도구는 Claude Code가 모델에 주는 작은 능력 하나입니다. 모델은 컴퓨터를 직접 만질 수 없고 도구를 요청만 하며, 도구가 일을 하고 결과가 모델에 돌아가면 모델이 그 결과로 다음 단계를 정합니다. 이 요청-응답 방식이 함수 호출입니다(6.2 참조). 도구는 많지만 여섯 개가 대부분의 일을 합니다.
| 도구 | 하는 일 | 개발자의 행동에 비유하면 |
|---|---|---|
Read |
파일을 읽어 내용을 반환 | 파일을 열어 코드를 읽음 |
Grep |
모든 파일에서 단어나 패턴을 검색 | 편집기의 "모든 파일에서 찾기" |
Glob |
이름이 패턴에 맞는 파일을 찾음 | 이름으로 파일을 찾음 |
Edit |
파일의 특정 부분을 변경 | 코드 몇 줄을 수정 |
Write |
새 파일 생성 또는 파일 교체 | 프로젝트에 새 파일을 만듦 |
Bash |
어떤 터미널 명령이든 실행 | 테스트 실행, 앱 빌드 |
Grep은 텍스트 검색입니다. loginUser를 검색하면 프로젝트의 모든 파일 안을 보고 그 단어가 있는 파일과 줄을 알려 줍니다. 프로젝트 전체에 대한 Ctrl+F와 같습니다. Glob은 파일 이름 검색이며 *.js는 이름이 .js로 끝나는 모든 파일을 뜻하므로 파일을 하나도 열지 않고 "이 프로젝트에 어떤 테스트 파일이 있는가"에 답합니다. Bash는 테스트 실행, 패키지 설치, git, 서버 시작 등 터미널에서 칠 수 있는 모든 명령을 돌릴 수 있는 가장 강력한 도구이며, Claude Code가 스스로 작업을 검증할 수 있는 이유입니다.
도구들이 함께 일하는 모습을 실패한 테스트 하나로 따라가 보겠습니다. 프로젝트 폴더에서 claude를 실행하고 "Fix the failing login test"라고 요청합니다. 어느 파일에 버그가 있는지는 말하지 않았습니다.
| 단계 | 도구 | 결과 |
|---|---|---|
| 1 | Bash로 npm test 실행 |
테스트 하나 실패: "loginUser should return a token" |
| 2 | Grep으로 loginUser 검색 |
auth.js 안에서 함수 발견 |
| 3 | Read로 auth.js 열기 |
한 경우에 값을 반환하지 않는 코드를 이해 (원문의 가정 사례) |
| 4 | Edit으로 해당 줄 수정 |
버그 수정 |
| 5 | Bash로 npm test 재실행 |
모든 테스트 통과 |
모든 도구 결과가 다음 결정을 먹입니다. 실패한 테스트가 무엇을 검색할지, 검색이 무엇을 읽을지, 읽기가 무엇을 고칠지 알려 주었고, 마지막 테스트가 수정이 통했음을 증명했습니다. Bash, Grep, Read로 맥락을 모으고, Edit으로 행동하고, 다시 Bash로 검증한 에이전트 루프입니다. FDE는 도구 목록이 곧 에이전트의 능력과 위험의 목록이므로, 고객 환경에 맞는 도구를 어디까지 열지 도구별로 정합니다(7.1.1 참조).
7.6.3 큰 프로젝트 검색 방식
Claude Code는 모두 읽지 않고 먼저 검색합니다. 이유는 컨텍스트 윈도우 때문입니다. 컨텍스트 윈도우는 AI 모델의 작업 기억이며 한 번에 제한된 양의 텍스트만 담습니다(2.16 참조). 대화, 파일, 명령에 대해 모델이 아는 모든 것이 그 안에 들어가야 합니다. 정해진 크기의 화이트보드로 생각하면 읽는 파일마다 보드에 적히고, 가득 차면 새것을 위해 오래된 것을 지워야 합니다. 프로젝트에 파일이 수천 개이므로 전부 읽으려 하면 보드가 즉시 넘칩니다. 그래서 똑똑한 개발자처럼 먼저 검색하고 중요한 것만 읽습니다. 무엇을 보드에 올리고 무엇을 빼는지 정하는 일이 컨텍스트 엔지니어링입니다(4.4 참조).
그래서 Grep과 Glob이 등장합니다. 단순하고 빠른 텍스트 검색이라 수천 개 파일을 순식간에 훑고 일치하는 파일과 줄의 짧은 목록만 돌려주며, 이 목록은 보드에서 차지하는 자리가 작습니다. 그런 다음 관련 있는 두세 파일만 읽습니다.
flowchart TD
    A[수천 개 파일] -->|Grep·Glob으로 검색| B[일치하는 파일 몇 개]
    B -->|Read는 이것만 열기| C[보드에는 중요한 코드만]
그림 7.6.3 — 단계마다 범위가 좁아져 화이트보드가 넘치지 않습니다.
특별한 데이터베이스도 코드의 특수 색인도 없으며, 개발자가 수십 년간 써 온 단순한 텍스트 검색으로 길을 찾습니다. 지능은 검색 도구가 아니라 무엇을 검색할지 정하는 모델에 있습니다. 고객이 대규모 저장소에서 에이전트가 느리거나 엉뚱한 파일을 읽는다고 하면 검색어를 정하는 단계와 읽는 파일 수를 먼저 봅니다.
7.6.4 자기 작업 검증
원문 저자는 이 부분이 Claude Code에서 가장 중요하다고 봅니다. 일반 챗봇의 가장 큰 약점은 자기 답을 확인하지 못하는 것이며, 맞아 보이는 코드를 쓰지만 맞아 보이는 것과 맞는 것은 다릅니다. Claude Code는 코드를 실행해 이 간극을 좁힙니다. 변경 뒤에 프로젝트의 테스트를 돌려 결과를 읽고, 컴파일러나 빌드를 돌려 오류를 읽고, 프로그램 자체를 돌려 출력을 확인할 수 있습니다.
무엇이든 실패하면 오류 메시지가 곧바로 루프로 돌아갑니다. 모델이 오류를 읽고 무엇이 잘못됐는지 이해해 고치며, 사람이 아무것도 하지 않아도 여러 번 반복될 수 있습니다. 에이전트가 자기 출력을 점검해 스스로 고치는 이 패턴이 리플렉션입니다(6.6 참조). 실패한 테스트는 작업의 끝이 아니고, 오류가 루프로 돌아가 코드가 고쳐지고 테스트가 다시 돌며 통과해야 끝납니다. 좋은 개발자가 코드를 돌려 보지 않고 "버그를 고쳤다"고 말하지 않는 규율과 같습니다.
사람이 도울 수도 있습니다. 대조할 대상을 주면 성능이 훨씬 좋아집니다. "먼저 실패하는 테스트를 쓰고, 코드를 고치고, 테스트를 돌려라"처럼 지시하면 분명한 목표가 생기고 에이전트가 목표에 닿을 때까지 돕니다. 이는 "기계가 확인할 수 있는 완료 정의"(7.2 참조)를 사람이 요청 안에 직접 적는 방법입니다. 고객의 에이전트 요청서에는 "무엇이 통과하면 끝인가"를 한 줄 넣도록 안내합니다.
7.6.5 CLAUDE.md: 프로젝트 메모리
새 Claude Code 세션은 항상 비어 있는 새 컨텍스트 윈도우, 즉 깨끗한 화이트보드로 시작합니다. 그러나 프로젝트에는 바뀌지 않는 규칙이 있습니다. 어떤 언어를 쓰는지, 테스트를 어떻게 돌리는지, 어느 폴더를 건드리면 안 되는지입니다. 세션마다 다시 설명하기는 번거롭습니다. CLAUDE.md는 프로젝트 폴더에 두는 단순 텍스트 파일로 Claude Code가 세션을 시작할 때 자동으로 읽습니다. 여기에 쓴 내용은 상시 지시가 됩니다.
# Project Notes

- We use Kotlin for all new code.
- Run the tests with: ./gradlew test
- Do not edit files inside the generated/ folder.
프로젝트의 언어, 정확한 테스트 명령, 절대 건드리면 안 되는 폴더를 적었으므로 Claude Code는 설명을 반복하지 않아도 매 세션에서 이를 압니다. 새 팀원에게 "우리 팀은 이렇게 일한다"는 한 장짜리 메모를 건네는 것과 같은 역할입니다. 규칙 하나가 자체 단계와 파일을 가진 완전한 절차로 커지면, 상시 로드되는 이 메모에 두지 않고 에이전트 스킬로 써서 작업에 필요할 때만 불러오게 합니다(6.10 참조). 에이전트 메모리의 일반론은 6.7을 참조합니다. FDE는 고객 저장소마다 CLAUDE.md에 테스트 명령과 건드리면 안 되는 경로부터 적어 두도록 안내합니다.
7.6.6 권한 제어
파일을 고치고 명령을 실행하는 에이전트는 강력하므로 안전을 지키는 장치가 **권한(permissions)**입니다. 원문은 Claude Code가 기본적으로 파일을 수정하거나 무언가를 바꾸는 명령을 실행하기 전에 승인을 묻는다고 설명합니다. 다만 공식 문서 기준으로 시작 권한 모드는 버전과 요금제에 따라 다르며, 최근 버전에서는 자동 모드가 기본 시작 모드가 될 수 있으므로 도입 시점에 확인해야 합니다. 프롬프트는 단순화하면 다음과 같습니다.
Claude wants to run: npm test
Do you want to allow this?
> 1. Yes
  2. Yes, and do not ask again for this command
  3. No, and tell Claude what to do differently
승인하기 전에는 컴퓨터에서 아무것도 바뀌지 않으며, npm test처럼 믿는 명령은 영구 허용해 다시 묻지 않게 할 수 있습니다. 권한 모드는 원문 기준으로 네 가지입니다(공식 문서에는 모든 프롬프트를 건너뛰는 bypassPermissions 모드도 있으며, 격리된 컨테이너나 VM 용도로 안내합니다).
| 모드 | 동작 | 쓰는 때 |
|---|---|---|
| 수동(Manual) | 모든 파일 수정과 명령 전에 묻는 기본값 | 처음 쓰거나 위험한 저장소 |
| 편집 수락(Accept edits) | 파일 수정과 mkdir·mv 같은 흔한 파일 명령은 작업 폴더 안에서 자동 승인, 다른 명령은 여전히 승인 필요 |
작업 방향을 이미 신뢰할 때 |
| 계획(Plan) | 읽고 생각만 하며 아무것도 수정하지 못함 | 큰 변경 전 (7.6.7 참조) |
| 자동(Auto) | 묻지 않고 일하며, 별도 분류 모델이 위험한 행동을 뒤에서 점검해 막음(안전을 보장하지는 않음) | 키보드 앞에 사람이 없는 자동화 환경 |
또 하나의 안전망이 체크포인트입니다. 파일을 수정하기 전에 그 파일의 스냅샷을 저장하므로 결과가 마음에 들지 않으면 이전 상태로 되돌릴 수 있습니다. 다만 공식 문서에 따르면 체크포인트는 Claude의 파일 편집 도구가 바꾼 파일을 대상으로 하며, Bash 명령만으로 바뀐 파일, 서브에이전트가 고친 다른 파일, 데이터베이스·API 같은 외부 시스템의 변경은 되돌리지 못합니다. 이런 변경에는 git 같은 버전 관리를 함께 씁니다. 권한 구조는 하네스의 가드레일과 같은 역할입니다(7.1.1 참조). 고객이 자동 모드를 요구하면 키보드 앞에 사람이 없는 환경인지, 되돌림 수단이 무엇인지를 묻고, 그렇지 않다면 수동 또는 편집 수락 모드로 시작하도록 권합니다.
7.6.7 플랜 모드·서브에이전트·훅
핵심 위에 더해지는 세 가지 기능입니다.
플랜 모드(plan mode). 읽기 전용입니다. 프로젝트를 탐색하고 생각한 뒤 "무엇을 왜 바꾸겠다"는 계획을 제시하며 파일은 하나도 건드리지 않습니다. 사람이 계획을 읽고 대화로 고친 다음에야 구현을 허락합니다. 집을 짓기 전에 설계도에 합의하는 것과 같아서, 큰 변경에서는 곧바로 코드부터 쓰는 것보다 두 단계 접근이 훨씬 나은 결과를 줍니다.
서브에이전트(subagent). 긴 작업은 컨텍스트 윈도우를 빠르게 채웁니다. 큰 탐색 하나가 보드 전체를 채울 수 있습니다. 서브에이전트는 자기만의 새 컨텍스트 윈도우, 즉 별도의 화이트보드를 가진 도우미 에이전트입니다(6.13 참조). 메인 에이전트가 집중된 작업 하나를 주면 서브에이전트가 자기 보드에서 지저분한 탐색을 다 하고 짧은 요약만 돌려줍니다. 서브에이전트 두 개가 방대한 코드를 읽어도 메인 에이전트는 짧은 요약 두 개만 받으므로 메인 보드가 깨끗하게 남고, 서브에이전트끼리 동시에 일할 수도 있습니다. 보드를 깨끗이 유지하는 다른 방법은 오래된 이력을 요약해 줄이는 것입니다(4.5 참조).
훅(hook). 특정 이벤트가 Claude Code 안에서 일어날 때 자동 실행되는 작은 스크립트입니다. 예를 들어 파일을 수정할 때마다 코드 포매터를 돌립니다. 중요한 차이는 CLAUDE.md의 지시는 모델이 따르는 요청이고, 훅은 시스템이 강제하는 규칙이라는 점입니다. 훅은 예외 없이 매번 실행되므로 반드시 일어나야 하는 일에 씁니다.
전체 그림은 두뇌와 몸입니다. 두뇌는 읽고 추론하고 결정하는 Claude 모델이고, 몸은 Read, Grep, Glob, Edit, Write, Bash 도구입니다. 에이전트 루프가 맥락 수집, 행동, 결과 검증을 이어 완료될 때까지 반복하며, CLAUDE.md는 프로젝트에 대한 기억을, 권한과 체크포인트는 사람의 통제를, 플랜 모드는 생각과 실행의 분리를, 서브에이전트는 작업 기억의 청결을, 훅은 건너뛰면 안 되는 규칙의 강제를 맡습니다. 마법은 없고 좋은 개발자가 따르는 단순한 루프가 있을 뿐입니다. 코드를 이해하고, 코드를 바꾸고, 바뀐 것이 동작함을 증명합니다. 고객 조직의 규칙을 정리할 때 FDE는 "부탁하면 되는 규칙"은 CLAUDE.md에, "항상 일어나야 하는 규칙"은 훅에 배치하도록 구분합니다.
7.7 Cursor
코딩 에이전트를 고객 개발팀에 도입하는 자리에서는 "어떤 코드가 어디로 나가고, 누가 변경을 승인하는가"가 먼저 나옵니다. Cursor는 그 답이 편집기 한 곳에 모여 있는 도구이므로, 내부 구조를 알면 질문에 근거를 갖고 답할 수 있습니다. 이 절은 2026년 7월 글 기준의 설명을 따릅니다.
Cursor는 널리 쓰이는 코드 편집기 VS Code 위에 만들어진 AI 코드 편집기입니다. 파일 탐색기, 상단 탭, 버튼 배치가 VS Code와 같아서 써 본 사람은 곧바로 익숙해집니다. 달라지는 점은 편집기가 강력한 AI 모델과 연결되어, 코드를 읽고 설명하고 새로 쓰는 일을 도와준다는 것입니다. 다음 틀을 기억하면 이후 소절이 모두 같은 구조로 읽힙니다.
- AI 모델은 Cursor 안에 있지 않고, 모델을 만드는 회사의 서버에 있습니다.
- Cursor는 사용자와 코드가 있는 쪽과 서버의 모델 사이를 잇는 다리입니다.
- 도움을 요청하면 Cursor는 (1) 코드의 적절한 조각, 곧 컨텍스트(4.4 참조)를 모으고 (2) 질문과 컨텍스트를 함께 모델에 보내고 (3) 돌아온 답을 코드에 반영합니다.
flowchart LR
    A["Cursor<br/>(편집기 + 내 코드)"] -- "코드 조각 + 질문" --> B["AI 모델<br/>(서버)"]
    B -- "답변" --> A
그림 7.7 — Cursor는 AI를 직접 실행하지 않고, 필요한 조각만 서버의 모델에 보내 답을 받아 옵니다.
전화로 의사에게 상담받는 상황과 같습니다. 의사가 아무리 뛰어나도 환자를 볼 수 없으므로 증상을 정확히 설명해야 좋은 조언을 받습니다. 모델은 내 프로젝트를 본 적이 없기 때문에, 코드를 어떻게 골라 설명하느냐가 Cursor의 실력입니다.
7.7.1 코드베이스 인덱싱
파일이 천 개인 프로젝트에서 질문 하나에 천 개를 모두 보내면 느리고 비용도 큽니다. 그래서 Cursor는 질문과 관련 있는 몇 개만 골라야 하고, 그 선택을 가능하게 하는 사전 작업이 **인덱싱(indexing)**입니다. 모든 파일을 한 번 읽어 나중에 빠르게 검색할 수 있는 형태로 준비해 두는 일입니다. "사용자 비밀번호는 어디서 검사하나요?"라는 질문에 비밀번호 처리 파일만 보내고, 앱 색상이나 이미지 처리 파일은 보내지 않는 것이 목표입니다.
인덱싱은 세 단계로 진행됩니다.
- 청크 분할: 코드를 작은 조각인 **청크(chunk)**로 자릅니다. 함수 하나, 또는 함께 묶이는 몇 줄이 보통의 단위입니다(5.6 참조).
- 임베딩 변환: 각 청크를 임베딩, 곧 의미를 담은 숫자 목록으로 바꿉니다. 비슷한 뜻의 청크는 비슷한 숫자를, 다른 뜻의 청크는 크게 다른 숫자를 받습니다(2.6 참조). 비밀번호 검사 청크와 사용자 로그인 청크는 서로 가깝고, 앱 색상 변경 청크는 멀리 떨어집니다.
- 벡터 DB 저장: 숫자들을 가까운 숫자를 빠르게 찾는 데 특화된 데이터베이스에 넣습니다(5.1 참조).
flowchart TD
    A["코드 파일"] -- "작게 자르기" --> B["청크<br/>(함수 하나 또는 관련된 몇 줄)"]
    B -- "숫자 목록으로 변환" --> C["임베딩<br/>(의미를 담은 숫자)"]
    C -- "저장" --> D["벡터 데이터베이스<br/>(의미로 검색할 준비 완료)"]
그림 7.7.1 — 인덱싱 파이프라인: 파일에서 청크, 임베딩, 벡터 DB로 이어집니다.
질문이 들어오면 Cursor는 질문도 같은 방식으로 숫자로 바꾼 뒤, 데이터베이스에서 질문과 숫자가 가장 가까운 청크를 찾습니다. 가장 가까운 청크가 질문과 관련 있을 가능성이 높으므로, 프로젝트 전체를 읽지 않고도 필요한 조각만 모을 수 있습니다. 이렇게 단어가 아닌 의미로 찾는 방식이 시맨틱 검색입니다(5.3 참조).
- 원문은 대부분의 요금제에서 Cursor가 실제 코드를 자기 서버에 저장하지 않고 주로 이 숫자들을 저장한다고 설명합니다(7.7.7 참조). 다만 Cursor의 현재 공식 문서는 코드를 서버에 일시 캐시하며 영구 저장하지 않는다고 밝히고, 로컬 검색(Instant Grep)은 임베딩을 저장하지 않는다고 적고 있어 저장 방식은 버전에 따라 달라질 수 있습니다. 도입 시점에 공식 문서로 확인해야 합니다.
- 한계도 있습니다. 검색은 가까운 청크를 가져올 뿐이므로, 질문과 관련된 코드가 질문과 의미상 멀면 놓칠 수 있습니다. 이때는 사용자가 파일을 직접 지정해 보완합니다(7.7.3 참조).
FDE는 고객의 저장소 규모와 구조를 보고 "인덱싱 대상에 무엇이 들어가는가, 모노레포라면 어떤 범위를 색인하는가"를 확인하고, 질문에 엉뚱한 파일이 따라온다면 검색이 놓친 것인지 코드 배치가 뒤섞인 것인지부터 가려야 합니다.
7.7.2 Tab 자동완성
Tab은 Cursor에서 가장 먼저 눈에 띄는 기능으로, 코드를 입력하면 다음 줄 제안이 회색으로 나타나고 Tab 키를 누르면 실제 코드가 됩니다. 일반 편집기의 자동완성이 단어 하나를 채우는 것과 달리, Cursor는 다음 편집 전체를 예측합니다. 여러 줄을 한 번에 제안하고, 입력 중인 곳에서 몇 줄 떨어진 위치의 수정까지 제안할 수 있습니다.
- 이 기능에는 다음 편집 예측 한 가지만 하도록 훈련된 별도 모델이 쓰입니다.
- 입력할 때마다 모델에 보내는 재료는 세 가지입니다: 커서 위아래의 코드, 방금 한 최근 변경, 프로젝트의 다른 부분에서 가져온 관련 조각.
- 모델은 이를 보고 다음에 쓸 가능성이 가장 높은 내용을 추측해 회색 제안으로 보여 줍니다.
핵심 제약은 속도입니다. 제안이 1초의 일부 안에 나타나지 않으면 방해가 되므로, Tab에는 크고 무거운 모델 대신 작고 빠른 모델을 씁니다. 예를 들어 사용자 이름을 담은 변수를 만드는 줄을 방금 썼다면 모델은 그 이름으로 사용자에게 인사하는 줄이 이어질 것으로 추측해 제안하고, 사용자는 Tab 한 번으로 받아들입니다. 반복적인 타이핑이 사라지는 대신, 제안은 추측이므로 받아들이기 전에 읽는 습관이 필요합니다.
FDE는 Tab을 "답을 찾는 기능"이 아니라 "입력 속도를 높이는 기능"으로 구분해 설명해야 합니다. 고객이 지연이나 부정확한 제안을 호소하면 이 기능이 빠른 소형 모델 위에 있다는 점이 첫 번째 판단 기준이 됩니다(7.7.6 참조).
7.7.3 Chat
Chat은 편집기 옆 대화창으로, 코드에 대한 질문("이 함수는 무엇을 하나요?", "이 테스트가 왜 실패하나요?")에 답하고 새 코드도 써 줍니다. 처리는 다섯 단계입니다.
- 사용자가 질문을 입력합니다.
- Cursor가 컨텍스트를 모읍니다. 인덱스(7.7.1 참조)로 질문에 중요한 청크를 찾고, 현재 열어 둔 파일을 더하며, 사용자가 직접 가리킨 파일도 포함합니다.
- 질문과 컨텍스트를 합쳐 AI 모델에 보낼 완전한 메시지, 곧 프롬프트를 만듭니다.
- 이 프롬프트를 서버의 큰 모델에 보냅니다.
- 모델이 읽고 답을 쓰면 답이 돌아와 채팅창에 나타납니다.
Chat은 결국 똑똑한 대화이며, 똑똑하게 느껴지는 이유는 컨텍스트입니다. 프로젝트의 실제 코드 조각을 보내기 때문에 모델이 일반론이 아니라 이 프로젝트에 대해 답할 수 있습니다. 반대로 인덱스가 엉뚱한 조각을 가져오면 답도 엉뚱해지고, 사용자가 필요한 파일을 직접 가리키면 이 실패를 막을 수 있습니다.
고객 개발자가 "답이 우리 코드와 안 맞는다"고 하면 FDE는 모델 성능보다 먼저 어떤 컨텍스트가 프롬프트에 실렸는지를 묻습니다. 컨텍스트 설계의 일반 원리는 4.4를 참조합니다.
7.7.4 Agent 모드
Chat에서 AI는 말만 하지만, Agent 모드에서는 AI가 직접 일합니다. 파일을 읽고 쓰며 명령까지 실행하고, 작업이 끝날 때까지 한 걸음씩 계속합니다. "내 앱에 다크 모드를 추가해 줘"라고 하면 일반 채팅은 방법을 알려 주는 데서 끝나지만, Agent는 실제로 작업을 수행합니다.
이것이 가능한 이유는 모델에 도구가 주어지기 때문입니다. 도구는 모델이 취할 수 있도록 허락된 행동 하나입니다(6.2 참조).
- 파일을 읽는 도구
- 코드베이스를 검색하는 도구
- 파일에서 편집을 수행하는 도구
- 터미널에서 명령을 실행하는 도구
- 내장 도구 밖의 데이터베이스나 이슈 트래커 등은 개방형 표준인 MCP로 연결합니다(6.9 참조).
Agent는 루프로 움직입니다. 먼저 모델이 작업을 생각해 다음 단계를 정하고(예: 설정 파일을 먼저 읽기), 읽기 도구로 파일을 열면 Cursor가 도구를 실행해 내용을 모델에 돌려줍니다. 내용을 읽은 모델은 다음 단계(다크 모드 옵션 추가를 위한 파일 편집)를 정하고, 편집 도구로 변경하며, 앱을 실행해 동작을 확인하기도 합니다.
flowchart TD
    A["다음 단계 생각"] --> B["도구 사용<br/>(읽기 / 편집 / 실행)"]
    B --> C["결과 확인"]
    C -- "작업이 끝나지 않음" --> A
    C -- "작업 완료" --> D["멈추고 최종 결과 표시"]
그림 7.7.4 — 생각, 행동, 결과 확인을 반복하는 에이전트 루프.
생각하고, 행동하고, 결과를 보고, 다시 생각하는 이 반복이 에이전트를 에이전트로 만듭니다(6.3 참조). 한 번에 모두 처리하지 않고 작은 걸음마다 결과를 확인한다는 점이 중요합니다. 이 루프를 몇 턴 허용하고, 매 턴에 무엇을 보여 주며, 언제 멈추게 할지 설계하는 일이 루프 엔지니어링입니다(7.2 참조).
사용자의 통제권도 유지됩니다. 명령 실행처럼 위험한 작업 전에 Cursor가 허락을 구할 수 있고, 모든 변경은 수락하기 전에 검토할 수 있습니다. 즉 Agent 모드는 말하는 도우미를 일하는 도우미로 바꾸되, 승인 지점은 남겨 둡니다.
FDE는 고객과 Agent를 도입할 때 어떤 도구(특히 명령 실행과 외부 연동)를 허용할지, 어느 단계에서 사람의 허락을 받게 할지를 먼저 합의해야 합니다. 같은 구조의 터미널형 도구는 7.6과 비교할 수 있습니다.
7.7.5 변경 적용 방식
모델이 새 코드를 쓰면 그것이 어떻게 파일에 들어가는지가 다음 질문입니다. 500줄짜리 파일에서 10줄만 바꾸는데 매번 새 파일 전체를 받으면 느리고 낭비입니다. 그래서 큰 모델은 파일 전체를 다시 쓰지 않고 변경만 서술합니다. "이 함수에서 이 줄들을 이 새 줄들로 바꿔라" 같은 식입니다.
그다음 Apply 모델이 나섭니다. 원문은 이 작고 빠른 별도 모델이 하는 일이 서술된 변경을 실제 파일에 매끄럽게 병합하는 하나뿐이라고 설명합니다. 외부 공식 문서로는 이 구조를 확인하지 못했습니다. 병합이 끝나면 Cursor는 변경을 diff로 보여 줍니다. diff는 이전 줄을 빨간색, 새 줄을 초록색으로 나란히 보여 주는 화면으로, 무엇이 바뀌는지 정확히 확인할 수 있습니다.
- 마음에 들면 Accept를 눌러 변경을 실제로 반영합니다.
- 마음에 들지 않으면 Reject를 눌러 아무것도 바꾸지 않습니다.
- 수락 전에는 파일이 바뀌지 않으므로 통제권이 항상 사용자에게 있습니다.
다만 diff를 보는 일은 사람의 몫입니다. 변경이 크거나 빈번하면 검토가 형식적으로 흐르기 쉽습니다.
FDE는 고객의 코드 리뷰 관행을 확인해 "AI가 쓴 변경도 diff 검토와 기존 리뷰를 거친다"는 원칙을 세워 주어야 합니다.
7.7.6 용도별 다른 모델 사용
Cursor는 하나의 모델만 쓰지 않고 작업마다 다른 모델을 씁니다. 크고 무거운 모델은 똑똑하지만 느리고 비용이 큽니다. 작고 빠른 모델은 즉각적이지만 덜 똑똑합니다. 그래서 일에 맞는 모델을 고릅니다.
| 작업 | 쓰는 모델 | 이유 |
|---|---|---|
| Tab 자동완성 | 작고 빠른 모델 | 입력하는 동안 제안이 즉시 나타나야 함 |
| Chat과 Agent | 크고 똑똑한 모델 | 어려운 사고와 코드 작성에 가장 똑똑한 모델이 필요함 |
| 변경 적용 | 작고 빠른 Apply 모델 | 서술된 변경을 파일에 병합하는 단순하고 빠른 작업 |
표 7.7.6 — 작업별 모델 선택. 큰 모델은 깊은 사고를, 작은 모델은 빠른 작업을 맡습니다.
각 모델은 한 가지 분명한 일만 맡고, 이 조합이 Cursor를 똑똑하면서도 빠르게 만듭니다. 이 분업은 지연, 비용, 품질을 한 모델로 모두 해결할 수 없다는 사실을 보여 줍니다.
FDE는 고객이 "응답이 느리다"거나 "비용이 많이 든다"고 할 때 어느 작업(Tab, Chat/Agent, 적용)에서 발생하는지를 먼저 구분해, 모델 교체와 사용 습관 중 어디를 손볼지 판단합니다.
7.7.7 코드 프라이버시
코드는 중요한 자산이므로 안전한지 묻는 것은 당연합니다. Cursor에는 프라이버시 모드(Privacy Mode) 설정이 있습니다. 원문은 이 모드가 켜져 있으면 요청이 끝난 뒤 Cursor가 코드를 저장하지 않는다고 설명합니다. Cursor 공식 문서는 프라이버시 모드에서 데이터를 학습에 쓰지 않으며, 지연을 줄이려 파일 내용을 서버에 일시 캐시하되 영구 저장하지 않는다고 밝힙니다.
한 가지는 분명히 해야 합니다. 질문에 답하려면 코드 일부를 서버의 AI 모델에 반드시 보내야 합니다. AI가 내 컴퓨터가 아니라 서버에 있기 때문입니다. 프라이버시 모드는 그 코드를 나중을 위해 저장하지 않는다는 보장이지, 코드가 나가지 않는다는 뜻이 아닙니다. 또 앞서 본 대로 코드베이스 인덱스는 코드 전문이 아니라 대부분 임베딩 숫자를 저장하므로 보호가 한 겹 더해집니다(7.7.1 참조).
- 코드가 서버로 나가는가: 필요한 조각은 나갑니다.
- 나간 코드를 저장하는가: 프라이버시 모드가 켜져 있으면 학습에 쓰지 않고 영구 저장하지 않습니다(일시 캐시는 있을 수 있음).
- 인덱스에는 무엇이 있는가: 대부분 임베딩이며, 코드 전문이 아닙니다.
FDE는 보안 담당자에게 "코드가 외부로 나가지 않습니다"라고 말해서는 안 됩니다. 정확한 설명은 "필요한 조각이 모델 서버로 전송되며, 프라이버시 모드에서는 저장하지 않습니다"이고, 고객 정책이 이 수준을 허용하는지 계약과 설정 양쪽에서 확인합니다. 이 구조는 휘발성이 있으므로 요금제별 저장 정책은 도입 시점의 공식 문서로 다시 확인해야 합니다.
전체 흐름을 한 번에 보면 이렇습니다. 프로젝트를 한 번 읽어 임베딩으로 저장하고(인덱싱), 입력할 때는 빠른 Tab 모델이 다음 편집을 제안하고, Chat에서는 인덱스로 청크를 찾아 프롬프트를 만들어 큰 모델에 보내며, Agent 모드에서는 모델이 도구로 읽고 편집하고 실행하는 루프를 돌고, Apply 모델이 변경을 파일에 병합해 diff로 수락 또는 거절을 받습니다.
FDE가 확인해야 할 자주 나오는 질문은 다음과 같습니다.
- VS Code와 무엇이 다른가: 외형은 같지만 편집기가 AI 모델과 연결되어 코드를 읽고 답하고 씁니다.
- AI가 내 컴퓨터에서 실행되는가: 아닙니다. 모델은 서버에 있고 Cursor가 다리 역할을 합니다.
- 프로젝트 전체가 모델에 전송되는가: 아닙니다. 인덱스에서 의미로 찾은 소수의 청크만 컨텍스트로 보냅니다.
- Chat과 Agent의 차이: Chat은 대답만 하고, Agent는 도구로 읽기, 검색, 편집, 명령 실행을 루프로 수행합니다.
- 승인 없이 코드가 바뀌는가: 아닙니다. 모든 변경은 diff로 보이고 Accept 전에는 바뀌지 않으며, 위험한 작업 전에는 허락을 구할 수 있습니다.
7.8 고객이 내일 묻는다면
각 질문에 소리 내어 답해보고, 막히면 표시된 절로 돌아가십시오. 통과 기준은 "내일 고객이 물어도 설명하고 결정할 수 있는가"입니다.
- "모델을 더 좋은 걸로 바꾸면 에이전트가 덜 틀리겠죠?" 모델 교체 전에 어떤 층을 점검합니까? (7.1.1, 7.1.2)
- "에이전트가 같은 검색을 열 번씩 반복하며 비용만 씁니다." 루프의 어떤 부품이 빠졌고 무엇을 넣습니까? (7.2.2, 7.2.4)
- "프롬프트를 고치면 되나요, 컨텍스트를 손봐야 하나요, 루프를 다시 짜야 하나요?" 무엇으로 구분합니까? (7.2.3)
- "한 프롬프트에 모든 단계를 적어 뒀는데 가끔 검증을 건너뜁니다." 왜 그런지 설명하고 어떤 구조로 바꾸겠습니까? (7.3.1)
- "답이 약하면 다시 쓰고 출처가 없으면 다시 검색하게 하고 싶어요." 그래프에서 무엇으로 표현합니까? (7.3.3)
- "환불 승인은 사람이 해야 하고, 서버가 중간에 죽어도 이어서 처리돼야 합니다." 어떤 장치 두 가지가 필요합니까? (7.3.5, 7.3.6)
- "LangChain이면 충분한가요, LangGraph가 필요한가요?" 무엇을 보고 고릅니까? (7.4.1, 7.5.1)
- "문서 검색 챗봇을 LangChain으로 만든다면 부품이 어떻게 이어집니까?" 단계를 말해 보십시오. (7.4.3, 7.4.5)
- "LangGraph에서 도구는 누가 실행하나요?" LLM 노드와 도구 노드의 역할을 구분해 보십시오. (7.5.4)
- "Claude Code가 제 저장소의 파일을 마음대로 지우면 어떡하나요?" 어떤 통제 수단을 설명합니까? (7.6.6, 7.6.7)
- "수천 개 파일이 있는 저장소에서 에이전트가 어떻게 필요한 코드를 찾나요?" 두 도구의 방식을 비교해 보십시오. (7.6.3, 7.7.1)
- "Cursor를 쓰면 저희 소스 코드가 외부로 나가나요?" 무엇이 어디로 가는지 묻고 답할 기준은 무엇입니까? (7.7.7)
- "Cursor가 고친 내용을 한 번에 다 덮어쓰나요?" 변경이 어떻게 적용되고 누가 승인합니까? (7.7.5)