11. 파인튜닝과 모델 커스터마이징
모델을 고객에게 맞추는 일은 어떤 가중치를 얼마나 바꾸느냐의 선택이며, 바꿀수록 얻는 것과 잃는 것이 함께 커집니다. FDE는 이 선택지(풀 파인튜닝, LoRA, 프리픽스 튜닝, 증류, 정렬 학습)를 비용과 위험으로 비교해 고객에게 권할 수 있어야 합니다.
학습 동기: 이 장을 읽으면 "파인튜닝을 해야 하나요, 어떤 방식으로 하나요"라는 고객의 질문에 학습 파라미터 수, 메모리, 망각 위험, 데이터 형태를 근거로 답할 수 있고, 모델을 작게 만들거나 사람의 선호에 맞추는 학습이 각각 무엇을 바꾸는지 말로 설명할 수 있습니다.
선행 가정: 손실과 에폭은 1.7, 역전파와 경사하강법은 1.9.4와 1.13, 강화학습의 정책과 보상은 1.14, Softmax와 온도는 1.11.3, 어텐션의 Query·Key·Value는 2.8과 2.9, 한 줄 정의로서의 파인튜닝은 0.4.5를 전제로 합니다.
11.1 파인튜닝(Fine-Tuning)
원문: How does Fine-Tuning work?
사전학습된 모델을 처음부터 만들 수 없는 조직이 대부분이므로, 이미 학습된 모델에 우리 데이터를 조금 더 학습시키는 절차가 필요합니다. 0.4.5에서는 한 줄로 정의했던 파인튜닝을 여기서는 단계, 수치, 방식 비교, 사용 판단의 순서로 풉니다. 아래 내용은 2026년 7월 글 기준입니다.
11.1.1 단계별 절차
**파인튜닝(Fine-Tuning)**은 이미 학습된 모델을 우리 고유의 데이터로 조금 더 학습시켜 특정 과제에 강하게 만드는 과정입니다. 이미 여러 요리를 아는 요리사에게 이탈리아 요리 레시피만 한동안 훈련시키는 것과 같습니다. 요리를 처음부터 가르치지 않으므로 금방 이탈리아 요리 전문가가 되고, 기존 요리 감각도 대부분 남습니다. 다만 최근 연습이 전부 이탈리아 요리였기에 예전 기술 일부는 무뎌지는데, 모델에서도 같은 일이 생기므로 늘 염두에 두어야 합니다.
- 출발점이 되는 모델을 기본 모델(base model) 또는 **사전학습 모델(pre-trained model)**이라 부릅니다. 비유 속의 "이미 일반 요리를 아는 요리사"입니다.
- 모델 안에는 수백만에서 수십억 개의 작은 숫자가 있고, 이것이 **가중치(weight)**입니다. 가중치는 무엇에 얼마나 비중을 둘지 정하는 숫자이며, 모델의 지식 그 자체입니다. 파인튜닝은 우리 예제를 보여주면서 이 숫자를 조금씩 고치는 일입니다.
- 같은 이유로 처음부터 학습하는 방식은 비용이 문제입니다. 대규모 데이터, 강력하고 비싼 컴퓨터, 몇 주에서 몇 달의 시간이 필요해 대부분의 조직이 감당하지 못합니다. 이미 언어, 문법, 사실, 일반 추론을 아는 기본 모델에서 출발하면 이 비용을 건너뜁니다.
- 일반 모델은 우리 요구를 모릅니다. 의료 회사라면 모델이 여러 주제를 말할 수는 있어도 원하는 의료 문체와 정확도로 답하지 못하는데, 수백만 달러를 들여 새 모델을 만들 이유는 없고 기존 모델만 조정하면 됩니다.
절차는 여섯 단계입니다.
| 단계 | 하는 일 | 핵심 |
|---|---|---|
| 1. 기본 모델 선택 | 이미 학습된 모델을 고릅니다 | 가중치가 이미 좋은 값을 가집니다 |
| 2. 데이터셋 준비 | 입력과 정답 쌍을 모읍니다 | 데이터 품질이 모델 품질을 정합니다 |
| 3. 예제 입력 | 예제를 하나씩 모델에 넣어 예측을 얻습니다 | |
| 4. 오류 측정 | 예측을 정답과 비교해 **손실(loss)**을 구합니다 | 손실은 0 이상이며 0이면 정확히 맞은 것입니다 |
| 5. 가중치 조정 | 역전파와 경사하강법(1.13 참조)으로 손실이 줄어드는 방향으로 조금씩 옮깁니다 | 각 가중치를 어느 쪽으로 밀지 모델이 스스로 계산합니다 |
| 6. 반복 | 3~5단계를 전체 예제에 대해 되풀이합니다 | 데이터를 한 바퀴 도는 것이 1 에폭(epoch) |
- 예를 들어 정중한 고객 지원 담당자처럼 답하게 하려면 데이터셋은 고객 질문(입력)과 이상적인 정중한 답변(출력)으로 구성합니다. 좋은 예제는 좋은 모델을, 나쁜 예제는 나쁜 모델을 만듭니다.
- 손실은 오류의 크기를 재므로 방향과 무관하게 0 이상입니다. 큰 손실은 큰 실수, 작은 손실은 정답에 가까움을 뜻합니다(1.7 참조).
- 가중치 조정의 수학은 역전파(1.9.4 참조)와 경사하강법(1.13 참조)에 있습니다. 여기서는 각 가중치를 어느 쪽으로 밀면 다음 예측이 조금 나아지는지 모델이 알아낸다는 점만 기억하면 됩니다.
flowchart LR
    A[입력 예제] --> B[모델이 출력 예측]
    B --> C[정답과 비교해 손실 계산]
    C --> D[가중치 조정으로 손실 감소]
    D -->|갱신된 가중치| B
그림 11.1 — 예제마다 입력, 예측, 비교, 조정을 거치고 갱신된 가중치가 다시 모델에 들어갑니다. 손실이 충분히 작아질 때까지 이 순환을 반복합니다.
고객 요청을 받으면 먼저 "입력과 이상적 출력 쌍이 몇 건, 어떤 품질로 있는가"를 묻는 것이 이 절차의 2단계에 해당하는 판단입니다.
11.1.2 수치 예제
가중치 하나(w)만 가진 모델로 학습이 어떻게 보이는지 확인합니다. 모델의 규칙은 입력 × w, 현재 w = 2.0, 입력은 4, 정답은 10입니다.
- 예측은
4 × 2.0 = 8.0이고 오차는10 − 8.0 = 2.0입니다. 모델이 정답에서 2.0만큼 모자랍니다. - 학습률(learning rate) 0.05로 조정량을 구하면
0.05 × 2.0 × 4 = 0.4이고, 가중치는2.0 + 0.4 = 2.4가 됩니다. - 새 가중치로 다시 예측하면
4 × 2.4 = 9.6으로 정답 10에 훨씬 가까워집니다.
학습률은 한 번의 조정 크기를 정하는 작은 수입니다. 작게 잡는 이유는 과하게 고쳐 정답을 지나쳐 버리는 일을 피하기 위해서입니다. 같은 계산을 반복하면 다음과 같이 수렴합니다. python3로 다시 계산한 값입니다.
| 회차 | 가중치 w | 예측 | 오차 |
|---|---|---|---|
| 시작 | 2.0 | 8.0 | 2.0 |
| 1회 후 | 2.4 | 9.6 | 0.4 |
| 2회 후 | 2.48 | 9.92 | 0.08 |
| 3회 후 | 2.496 | 9.984 | 0.016 |
| 4회 후 | 2.4992 | 9.9968 | 0.0032 |
원문은 이 흐름을 8.00, 9.60, 9.92, 9.98, 10.00으로 적었는데, 소수 둘째 자리까지 반올림한 값이며 위 표와 일치합니다. 오차가 매번 5분의 1로 줄어드는 것도 눈에 띕니다(1 − 0.05 × 4 = 0.2). 이 예제는 가중치 하나지만 실제 모델은 같은 일을 수십억 개의 가중치에 대해 동시에 합니다. 차이는 규모뿐입니다.
학습 곡선이 이렇게 빠르게 내려가는 것은 장난감 예제에서만이며, 현장에서 손실이 내려가지 않거나 진동하면 학습률부터 의심합니다(1.13.4 참조).
11.1.3 풀 파인튜닝 vs LoRA
파인튜닝에는 두 가지 흔한 방식이 있습니다. **풀 파인튜닝(Full Fine-Tuning)**은 모델의 모든 가중치를 조정합니다. 깊게 배우고 크게 바꿀 수 있는 것이 장점이지만, 수십억 개의 가중치를 갱신하고 저장해야 하므로 메모리와 고성능 장비가 많이 들어 큰 모델에서는 무겁고 비쌉니다.
**LoRA(Low-Rank Adaptation)**는 원래 가중치를 얼려 두고(frozen), 옆에 작은 추가 가중치만 학습합니다. 이미 인쇄된 두꺼운 책을 다시 찍는 대신 쪽마다 작은 포스트잇을 붙이는 것과 같습니다. 책은 그대로이고 새 정보는 포스트잇에 담깁니다(11.2 참조).
| 항목 | 풀 파인튜닝 | LoRA |
|---|---|---|
| 바꾸는 대상 | 모델의 모든 가중치 | 작은 추가 가중치만 |
| 필요한 메모리 | 아주 많음 | 적음 |
| 속도 | 느림 | 빠름 |
| 비용 | 높음 | 낮음 |
flowchart LR
    subgraph F[풀 파인튜닝]
        F1[모든 가중치 갱신<br/>수십억 개]
    end
    subgraph L[LoRA]
        L1[원래 가중치 고정] --- L2[작은 추가 가중치만 학습]
    end
그림 11.2 — 풀 파인튜닝은 모든 가중치를 갱신하고, LoRA는 고정된 원본 옆의 작은 추가분만 학습합니다.
- 가중치를 얼려 두는 또 다른 저비용 방식으로 프리픽스 튜닝이 있습니다. 옆에 추가 가중치를 두는 대신, 모든 어텐션 층을 이끄는 작은 프리픽스를 학습합니다(11.3 참조).
- 선택 기준은 단순합니다. 장비가 제한적이면 LoRA가 현실적이고, 자원이 충분하고 깊은 변화가 필요하면 풀 파인튜닝이 맞습니다.
고객의 GPU 예산과 필요한 변화의 깊이를 먼저 묻고, 확신이 없으면 LoRA로 시작하는 것이 안전한 기본값입니다.
11.1.4 사용 시점과 사전 팁
파인튜닝은 지시문만으로는 얻기 어려운 특정 문체, 어조, 기술을 모델에 익히고 싶을 때 씁니다. 브랜드 고유의 목소리로 모든 답을 내거나, 엄격한 의료·법률 서식을 따르거나, 회사 내부 전문 용어를 이해시키는 경우가 해당합니다.
- 파인튜닝이 항상 첫 번째 답은 아닙니다. 모델에게 읽을 사실만 주면 된다면 프롬프트에 정보를 직접 넣는 단순한 방법으로 대개 충분합니다. 모델의 행동을 바꾸고 싶을 때 파인튜닝하고, 사실을 먹이는 일에는 쓰지 않습니다.
- 가장 유명한 사례는 InstructGPT입니다. 사람이 쓴 답변으로 파인튜닝한 것이 GPT-3를 어시스턴트로 바꾼 첫 단계였습니다(11.6 참조).
- 파인튜닝 후에는 일부 기존 능력이 무뎌질 수 있습니다. 모델은 일반 능력 대부분을 유지하지만 최근 학습이 특정 과제에만 쏠렸기 때문입니다(11.5 참조).
시작 전 팁은 네 가지입니다.
- 데이터 품질을 우선합니다. 깨끗하고 정확한 소량의 예제가 지저분한 대량의 예제보다 낫습니다. 많은 데이터가 필요하다는 생각은 맞지 않습니다.
- 예제를 일관되게 유지합니다. 정중한 어조를 원하면 모든 예제가 정중해야 합니다. 신호가 섞이면 모델이 혼란스러워합니다.
- 장비가 제한적이면 LoRA로 시작합니다. 낮은 비용으로 좋은 결과를 줍니다.
- 학습 후 반드시 시험합니다. 학습 중 보지 못한 새 예제로 확인해야 실제로 배운 것인지 단순히 외운 것인지 알 수 있습니다(8.1 참조).
고객이 "새 문서 내용을 모델이 알게 해달라"고 하면 사실 주입인지 행동 변경인지부터 가르고, 앞의 경우는 프롬프트나 검색으로 해결하고 뒤의 경우만 파인튜닝으로 갑니다. 파인튜닝 이후의 검증 세트는 학습 데이터와 겹치지 않게 별도로 확보하도록 합의해 둡니다.
11.2 LoRA(Low-Rank Adaptation)
원문: What is LoRA (Low-Rank Adaptation) and How Does It Fine-Tune LLMs?
11.1에서 풀 파인튜닝과 LoRA를 표 한 장으로 비교했는데, 고객과 실제 견적을 논의하려면 왜 파라미터가 수백 분의 1로 줄어드는지 숫자로 설명할 수 있어야 합니다. 이 절은 그 비교의 LoRA 쪽을 행렬 수준까지 풉니다. 2026년 4월 글 기준입니다.
11.2.1 풀 파인튜닝이 비싼 이유
현대 LLM은 수십억 개의 파라미터를 가지며, 70억 파라미터 모델이면 70억 개의 숫자가 들어 있습니다. 풀 파인튜닝은 이 숫자를 하나도 빼지 않고 모두 갱신합니다. 여기서 네 가지 문제가 생깁니다.
- GPU 메모리가 폭발합니다. 가중치, 기울기, 옵티마이저 상태를 모두 메모리에 올려야 합니다. Adam 옵티마이저를 쓰면 모델 크기의 3~4배에 이를 수 있습니다.
- 학습이 느립니다. 수십억 개 파라미터를 갱신하는 연산량이 큽니다.
- 저장 공간이 무겁습니다. 파인튜닝한 사본은 원본과 크기가 같아서, 과제가 10개이면 수 기가바이트짜리 모델 사본이 10개 필요합니다.
- 공유가 어렵습니다. 과제마다 수 기가바이트 체크포인트를 사용자에게 보내기 어렵습니다.
요구는 모델의 대부분을 건드리지 않고 새 과제에 적응시키는 방법입니다. 고객 현장에서 "과제별 모델 사본이 몇 개 필요한가"를 세어 보면 저장·배포 비용이 곧바로 드러나며, 사본 수가 많은 구조일수록 LoRA의 이점이 커집니다.
11.2.2 저랭크 분해라는 핵심 아이디어
LoRA는 Low-Rank(저랭크)와 Adaptation(적응)을 합친 이름입니다. 적응은 모델을 새 과제나 새 문체에 맞춘다는 뜻이고, 저랭크는 가중치에 가하는 변화를 작은 행렬 두 개의 곱으로 압축해 표현한다는 뜻입니다.
- 바탕은 Microsoft의 원 논문이 한 관찰입니다. 큰 모델을 파인튜닝할 때 실제로 가중치에 가해지는 변화량은 랭크가 아주 낮아서, 거대한 갱신 행렬 전체가 필요 없고 훨씬 작은 행렬로 충분하다는 것입니다.
- 이유는 사전학습 모델이 이미 문법, 사실, 추론, 일반 패턴을 알고 있기 때문입니다. 새 과제를 가르치는 일은 다시 쓰기가 아니라 몇 개의 중요한 방향으로 살짝 미는 일이며, 그것이 "저랭크"의 뜻입니다.
- 비유하면 사전학습 모델은 거대한 교과서입니다. 풀 파인튜닝은 새 주제에 맞게 모든 쪽을 고쳐 쓰는 것이고, LoRA는 교과서를 그대로 두고 새 지식이 적힌 포스트잇을 붙이는 것입니다.
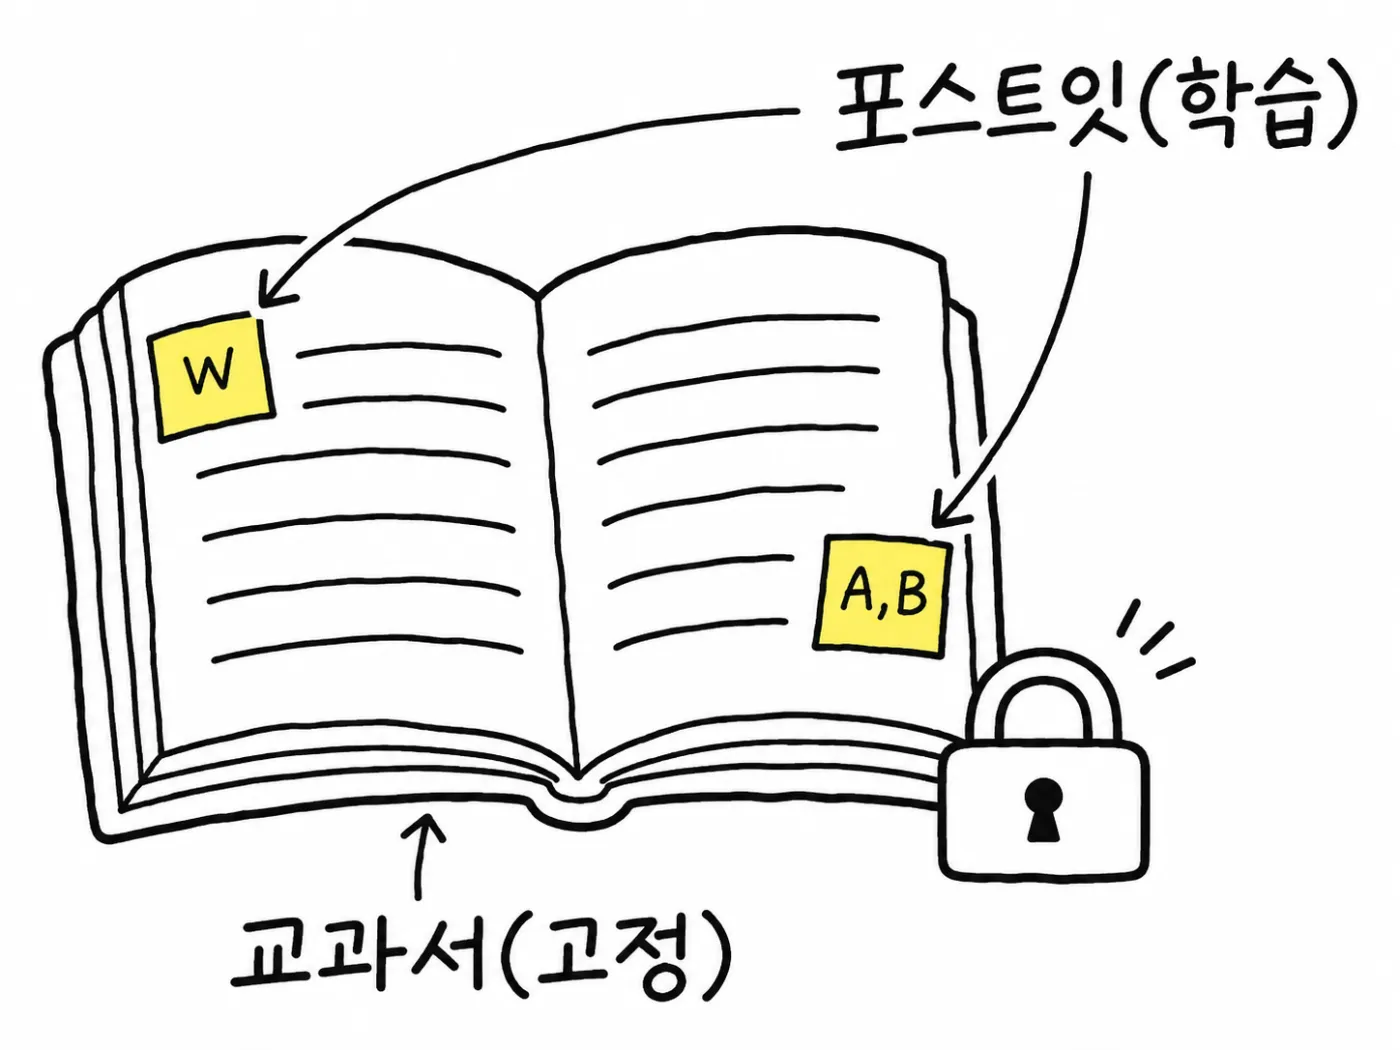
수식으로 쓰면 다음과 같습니다. 모델 안의 가중치 행렬 W의 크기를 d × d라 하면, 풀 파인튜닝은 같은 크기의 W_new = W + ΔW를 학습합니다. ΔW가 바로 적용할 변화이고 W와 ΔW 모두 거대합니다. LoRA는 이 ΔW를 작은 행렬 두 개의 곱으로 바꿉니다.
| 기호 | 크기 | 의미 |
|---|---|---|
A |
r × d |
가늘고 짧은 행렬 |
B |
d × r |
가늘고 긴 행렬 |
r |
4, 8, 16, 32, 64 같은 작은 수 | 랭크(rank) |
d |
보통 4096 이상 | 원래 차원 |
ΔW = BA는 모양으로는 여전히 d × d이지만 전체 d × d를 저장하지 않고 A와 B만 저장하므로 W에 비해 아주 작습니다. 입력 벡터 x에 대한 순전파는 h = Wx + (BA)x이고, W는 고정이며 A와 B만 학습합니다.
flowchart LR
    X[입력 x] --> W[W 고정]
    X --> A[A 학습 r x d] --> B[B 학습 d x r]
    W --> S((합))
    B --> S
    S --> H[출력 h = Wx + BAx]
그림 11.4 — 입력이 고정된 W와 작은 A, B 경로로 나뉘어 흐르고, 두 경로의 결과를 더해 최종 출력을 만듭니다.
설명을 위해 W를 정사각 d × d로 가정했지만 실제 LLM에서 어텐션 투영 행렬은 정사각이고 피드포워드 층은 d × 4d 또는 4d × d 같은 직사각입니다. LoRA는 어떤 직사각 행렬에도 적용되며, W가 d × k이면 B는 d × r, A는 r × k가 되고 원리는 같습니다.
11.2.3 단계별 동작과 수치 예제
동작은 다섯 단계입니다.
- 사전학습 모델의 원래 가중치를 모두 고정합니다. 학습 중 원본은 어떤 것도 갱신되지 않습니다.
- 적응시킬 가중치 행렬마다 옆에 작은 행렬
A와B를 추가합니다.A는 작은 난수(가우시안)로,B는 모두 0으로 초기화합니다. - 학습 중에는
A와B만 기울기 갱신을 받고W는 그대로입니다. - 순전파는
h = Wx + (alpha / r) × (BA)x로 계산합니다.alpha는 스케일 계수이며alpha / r비율이 LoRA 갱신이 출력에 미치는 영향의 세기를 정합니다. 흔한 선택은alpha = 2 × r입니다. - 학습이 끝나면 과제 지식을 담은 작은
A,B가 남고 원본 모델은 그대로입니다.
B를 0으로 두는 것이 중요합니다. 학습 시작 시 BA = 0이라 모델이 사전학습 모델과 완전히 똑같이 동작하고, 학습이 BA를 0에서 서서히 밀어냅니다. 교과서 비유로 보면 포스트잇이 처음에는 비어 있다가 학습이 진행되면서 교정 내용으로 채워집니다.
랭크 r은 가장 중요한 LoRA 하이퍼파라미터입니다(1.5.1 참조). r이 작으면 학습 파라미터가 적고 빠르지만 복잡한 변화를 담을 용량이 적고, r이 크면 용량은 늘지만 효율 이점이 일부 줄어듭니다. 실무에서는 8~64를 시작 범위로 흔히 씁니다. 원 논문은 GPT-3 175B 실험에서 랭크 1~4처럼 아주 낮은 값으로도 충분한 경우를 보였고, 8~64가 대부분 과제에 맞는다는 범위는 원문(2026년 4월 글)의 설명이며 외부 출처로는 확인하지 못했습니다.
4096 × 4096 행렬 하나로 계산해 보겠습니다. python3로 다시 확인한 값입니다.
| 항목 | 계산 | 파라미터 수 |
|---|---|---|
풀 파인튜닝 W |
4096 × 4096 | 16,777,216 (약 1,680만) |
A (r=8) |
8 × 4096 | 32,768 |
B (r=8) |
4096 × 8 | 32,768 |
| LoRA 합계 (r=8) | 32,768 × 2 | 65,536 |
- 행렬 하나당 파라미터가 정확히 256배 적습니다(16,777,216 ÷ 65,536). 절감은 모델의 모든 층에 걸쳐 곱해집니다.
- 같은
4096 × 4096행렬에서 랭크를 바꾸면 합계는r=4일 때 32,768(512배 감소),r=16일 때 131,072(128배),r=64일 때 524,288(32배)입니다. 랭크는 용량과 절감 폭을 맞바꾸는 손잡이입니다. - 70억 파라미터 모델에서 풀 파인튜닝은 70억 개를 갱신하는 반면, 랭크 8의 LoRA는 보통 수백만 개만 갱신합니다. 원문은 적용 위치와 랭크에 따라 약 1000배 이상 줄어든다고 했습니다. 가정을 하나 놓고 확인하면, 32개 층에서
W_Q와W_V에만r=8을 붙이는 경우 학습 파라미터는 32 × 2 × 65,536 = 4,194,304개로 70억 개의 약 1/1,669입니다. 이 층 수와 적용 행렬 수는 설명용 가정이며 실제 모델마다 다릅니다.
고객이 "학습 가능한 파라미터가 얼마나 되느냐"고 물으면 랭크와 적용 대상 행렬 수를 곱한 값을 바로 제시할 수 있어야 하고, 그 값이 GPU 메모리 견적의 출발점이 됩니다.
11.2.4 트랜스포머에서 적용되는 위치
LoRA는 모델의 모든 선형 층에 적용할 수 있지만 실무에서는 어텐션 투영 행렬에 가장 흔히 붙입니다. 각 어텐션 블록에는 투영 행렬 네 개가 있습니다(2.8, 2.9 참조).
| 행렬 | 역할 |
|---|---|
W_Q |
Query 투영 |
W_K |
Key 투영 |
W_V |
Value 투영 |
W_O |
Output 투영 |
- 원 논문은
W_Q와W_V만 적응시켜도 추가 파라미터를 최소로 하면서 강한 성능을 얻는 경우가 많다고 보고했습니다. - 품질을 더 높이려면 네 투영 모두 또는 피드포워드 층에도 적용할 수 있고, 대신 학습 파라미터가 늘어납니다.
- 각 행렬에서 두 경로(고정된
W를 지나는 경로와A,B를 지나는 경로)가 합쳐져h = Wx + (BA)x가 됩니다.
적용 대상은 품질과 비용 사이의 선택입니다. 처음에는 W_Q, W_V만 붙여 기준선을 잡고 품질이 모자랄 때 대상을 넓히는 순서가 비용을 통제하기 쉽습니다.
11.2.5 모델에 병합하기
LoRA의 가장 좋은 성질 중 하나는 학습이 끝나면 BA를 W에 병합(merge)할 수 있다는 점입니다. W_merged = W + (alpha / r) × (BA)로 계산하며, 이후 모델은 원본처럼 가중치 행렬 하나만 씁니다. 추가 행렬도 추가 연산도 없으므로 병합하면 추론 지연이 늘지 않습니다. 교과서 비유로는 포스트잇을 교과서에 영구히 적어 넣는 일입니다.
A,B를W와 분리해 두면 런타임에 과제를 바꿔 끼울 수 있고, 이것이 **어댑터 교체(adapter swapping)**의 기반입니다.- 병합은 일방향 연산입니다. 합친 뒤에는 그 어댑터를 다른 것으로 쉽게 빼고 갈 수 없습니다. 한 기본 모델로 여러 과제를 서비스하려면 어댑터를 병합하지 않고 필요할 때 불러옵니다.
- 사용자에게 어댑터를 배포할 때는 작은
A,B행렬만 보내면 되고 보통 수 메가바이트입니다. 수 기가바이트의 풀 파인튜닝 모델과 비교되며, 공유, 교체, 버전 관리가 쉬운 이유입니다. - 병합이 가능하다는 점이 다른 PEFT(파라미터 효율적 파인튜닝) 방식과 LoRA를 가르는 차이입니다. 프리픽스 튜닝은 아무것도 병합하지 않고 학습된 작은 프리픽스가 고정된 모델의 모든 어텐션 층을 이끕니다(11.3 참조).
실무 활용은 다음과 같습니다.
- 오픈소스 LLM(LLaMA, Mistral, Qwen 등)을 GPU 한 장에서 파인튜닝합니다. LoRA 없이는 고가 GPU 클러스터가 필요합니다.
- 요약, 코드 생성, 고객 지원처럼 과제별 어댑터를 따로 학습하고 필요한 것만 불러옵니다. 기본 모델은 같습니다.
- 특정 문체, 의료·법률 같은 도메인, 특정 페르소나를 가르칩니다.
- Stable Diffusion 같은 이미지 모델에서 새 캐릭터, 화풍, 개념을 전체 재학습 없이 추가합니다. 커뮤니티가 수천 개의 작은 LoRA 파일을 공유합니다.
- QLoRA의 기초 구성 요소입니다. LoRA에 4비트 양자화를 결합해 아주 큰 모델도 소비자용 GPU 한 장에서 파인튜닝합니다(10.8 참조).
- 기본 모델을 고정하고 작은 어댑터만 학습하므로 이미 가진 지식을 덮어쓰지 않고 새 과제를 가르치는 지속 학습 방법으로도 쓰입니다(11.5 참조).
고객이 여러 부서 과제를 한 모델로 서비스하려 한다면 어댑터 분리 운영(병합하지 않음)을 기본안으로 놓고, 단일 과제에 지연 민감도가 높다면 병합을 선택합니다. 어떤 배포 형태인지 확인한 뒤 병합 여부를 정하는 것이 순서입니다.
11.3 프리픽스 튜닝(Prefix Tuning)
원문: How does Prefix Tuning work?
프리픽스 튜닝은 LoRA와 같은 PEFT 계열이지만, 가중치 옆에 행렬을 붙이는 대신 모든 어텐션 층이 참조하는 학습된 키와 값을 얹는다는 점에서 구조가 다릅니다. 이 절은 프리픽스가 정확히 무엇이고 어디에 들어가는지, 얼마나 작은지를 숫자로 확인합니다. 2026년 8월 글 기준입니다.
11.3.1 프리픽스는 실제 단어가 아니다
**프리픽스 튜닝(Prefix Tuning)**은 대규모 언어 모델 전체를 얼려 두고, 모든 층이 작업하면서 함께 참조하는 작은 숫자 묶음인 **프리픽스(prefix)**만 학습하는 방법입니다. 풀 파인튜닝(11.1 참조)은 과제마다 수십억 파라미터의 전체 사본을 만들어 과제 10개이면 사본 10개가 쌓이지만, 프리픽스 튜닝은 거대 모델 하나를 공유하고 과제마다 작은 프리픽스만 둡니다.
- Prefix(앞에 붙는 것, "rewrite"의 "re")와 Tuning(기타를 조율하듯 조금씩 맞추는 일)을 합친 이름입니다. 큰 모델은 조율하지 않고 프리픽스만 조율합니다.
- 동결(frozen)은 모델의 숫자를 전혀 바꾸지 않고 잠근다는 뜻입니다. 학습 대상은 전체의 1% 미만인 경우가 많습니다.
- 이 방식은 소수의 파라미터만 학습해 파인튜닝의 이점을 얻는 PEFT(Parameter-Efficient Fine-Tuning) 계열입니다.
가장 흔한 오해는 프리픽스를 문장 앞에 붙이는 텍스트로 생각하는 것입니다. "Please write a polite reply:" 같은 단어가 아닙니다. 입력의 일부가 아니라 모델 내부 장치에 매 층마다 건네는 숫자 블록입니다.
- 모델은 글자를 직접 이해하지 못하고 먼저 단어를 숫자 목록인 **임베딩(embedding)**으로 바꿉니다(2.6 참조). 일반 단어도 임베딩이 된 뒤에야 처리됩니다.
- 프리픽스는 단어 단계를 건너뛰고 모델이 직접 다룰 수 있는 자유로운 숫자 블록으로, 어떤 실제 단어로도 되돌릴 수 없습니다. 이를 **가상 토큰(virtual token)**이라 부릅니다. 실제 단어가 참조할 수 있는 추가 위치처럼 동작하지만 실제 토큰이 아니며 입력 텍스트에서 오지 않습니다.
- 단어의 가짓수는 한정되어 있지만 자유로운 숫자는 그렇지 않으므로, 사람이 손으로 쓴 어떤 문장보다 과제를 잘 담은 프리픽스를 학습이 찾아낼 수 있습니다. 올바른 단어를 사람이 추측할 필요도 없습니다.
고객이 "프롬프트 앞부분에 지시문을 넣는 것과 같은가"라고 물으면, 같지 않고 사람이 읽을 수 없는 학습된 숫자라는 점을 먼저 짚습니다. 읽을 수 없다는 것은 감사나 수정이 어렵다는 뜻이기도 합니다.
11.3.2 프리픽스 삽입 위치와 학습 방식
프리픽스가 들어가는 곳은 어텐션의 키(Key)와 값(Value) 쪽입니다. 모델은 쌓인 여러 층으로 되어 있고 각 층 안에 어텐션이 있어 어떤 단어에 집중할지 정합니다(2.8, 2.9 참조). 어텐션에서 각 위치는 세 가지를 만듭니다.
| 구성 | 역할 | 비유 |
|---|---|---|
| 쿼리(query) | 이 위치가 찾는 것 | 던지는 질문 |
| 키(key) | 이 위치가 무엇에 관한 것인지 | 간판 |
| 값(value) | 이 위치를 보는 쪽에 건네는 실제 정보 | 내용물 |
각 단어는 자기 쿼리를 모든 키와 비교해 볼 만한 곳을 정하고 그곳의 값을 가져옵니다. 프리픽스 튜닝의 핵심은 다음 한 문장입니다. 프리픽스는 묻지 않고 답하기만 합니다. 모든 층에서 프리픽스는 추가 키와 추가 값만 제공하고, 모든 쿼리는 여전히 실제 단어에서 나옵니다. 실제 단어는 평소처럼 질문하고 학습된 추가 참조 위치가 생길 뿐입니다.
flowchart TB
    R[실제 단어] --> Q[쿼리]
    R --> K[키, 값]
    P[학습된 프리픽스] --> PK[추가 키, 추가 값]
    Q --> ATT[어텐션]
    K --> ATT
    PK --> ATT
    ATT --> O[이 층의 출력]
그림 11.5 — 한 층에서 프리픽스는 쿼리를 만들지 않고 키와 값만 더합니다. 어텐션은 프리픽스의 키·값과 실제 키·값을 함께 봅니다.
- 프리픽스는 입구에만 있지 않고 모든 층에 있습니다. 층마다 자기 키·값 블록이 따로 있으며 1층의 프리픽스가 2층으로 전달되는 것이 아닙니다.
- 모든 층에 존재하므로 모델의 동작을 처음부터 끝까지 꾸준히 이끌고, 학습하는 숫자가 적은데도 잘 동작하는 큰 이유입니다. 키·값 쪽에 있다는 점은 KV 캐시와도 연결됩니다(10.3 참조).
- 가상 토큰 하나는 층당 숫자 목록 하나가 아니라 키 목록과 값 목록 정확히 둘입니다. 쿼리가 없기 때문입니다. 개수를 셀 때 2를 곱하는 이유입니다(11.3.3 참조).
학습은 일반 학습과 같은 순서입니다.
- 프리픽스를 난수로 채워 시작합니다. 이 시점에서는 쓸모가 없고 과제 답도 대체로 나쁩니다.
- 학습 예제를 얼린 모델에 넣습니다. 프리픽스가 모든 층에서 추가 키·값을 제공하고 모델이 답을 냅니다.
- 답과 정답의 차이인 손실을 구합니다.
- 프리픽스 숫자만 조금 고쳐 손실을 줄입니다. 큰 모델은 얼려 있어 건드리지 않습니다.
- 많은 예제로 반복합니다. 난수였던 프리픽스가 숫자로 된 강력한 과제 지시로 변해 갑니다.
프리픽스 숫자를 직접 고치면 학습이 불안정해 잘 수렴하지 않을 수 있어서, 원 논문은 **재매개변수화(reparameterization)**라는 기법을 씁니다. 같은 숫자를 직접 학습하는 대신 다른 방식으로 만들어 내는 것으로, 더 작은 블록을 학습해 작은 네트워크로 실제 프리픽스 키·값을 만들고, 학습이 끝나면 그 네트워크는 버리고 최종 프리픽스만 남깁니다. peft 라이브러리에서는 prefix_projection 옵션이며 기본값은 꺼짐입니다. 켜면 학습 중에 출력되는 학습 가능 파라미터 수가 최종 저장되는 프리픽스보다 훨씬 크게 나오는데, 임시 네트워크까지 세기 때문입니다.
11.3.3 프리픽스 크기
프리픽스가 얼마나 작은지 숫자로 셉니다. 파라미터 약 13억 개, 은닉 크기(hidden size) 2048, 24층 모델을 가정합니다. 은닉 크기는 모델 내부에서 한 위치를 표현하는 숫자의 개수이고, 층은 텍스트가 거치는 쌓인 단계입니다. 가상 토큰 20개를 모든 층에 두고 키와 값 각각 한 목록씩이라는 전제로 python3로 다시 계산하면 다음과 같습니다.
| 단계 | 계산 | 결과 |
|---|---|---|
| 1. 목록 하나의 숫자 수 | 은닉 크기 | 2,048 |
| 2. 토큰 1개, 1개 층 | 2 × 2,048 (키+값) | 4,096 |
| 3. 토큰 20개, 1개 층 | 20 × 4,096 | 81,920 |
| 4. 24개 층 전체 | 81,920 × 24 | 1,966,080 |
- 풀 파인튜닝은 13억 개를 학습하고 프리픽스 튜닝은 1,966,080개를 학습하므로 전체의 약 0.15%이며, 나머지 99.85%는 얼려 공유됩니다.
- 이 계산은 프리픽스가 모든 층의 키·값 숫자를 직접 저장하는 가장 단순한 기본 설정을 가정합니다. 다른 방식으로 키·값을 만드는 설정(앞의
prefix_projection)에서는 학습 중 개수가 다르게 나옵니다.
코드 한 조각으로 확인하면 peft와 transformers로 다음처럼 설정합니다.
config = PrefixTuningConfig(task_type="CAUSAL_LM", num_virtual_tokens=20)
model = get_peft_model(model, config)   # 프리픽스만 학습 대상이 됨
model.print_trainable_parameters()gpt2(12층, 은닉 크기 768)에서 출력은 trainable params: 368,640 || all params: 124,808,448 || trainable%: 0.2954입니다. 위 공식으로 20 × 2 × 768 × 12를 계산하면 368,640으로 일치하고, 약 1억 2,400만 개 중 약 0.3%만 학습합니다.
견적에서는 가상 토큰 수 × 2 × 은닉 크기 × 층 수를 곱하면 학습 파라미터 수가 나오므로, 고객 모델의 층 수와 은닉 크기만 알면 바로 규모를 말할 수 있습니다.
11.3.4 풀 파인튜닝·프롬프트 튜닝과의 비교
풀 파인튜닝은 모든 파라미터를 바꾸고 과제마다 전체 사본을 저장하며, 프리픽스 튜닝은 모델을 얼리고 과제마다 작은 프리픽스만 학습합니다.
| 항목 | 풀 파인튜닝 | 프리픽스 튜닝 |
|---|---|---|
| 바뀌는 것 | 모델의 모든 파라미터 | 작은 프리픽스만 |
| 과제당 저장 | 거대한 전체 사본 하나 | 작은 프리픽스 하나 |
| 학습 비용 | 아주 높음 | 아주 낮음 |
| 최고 정확도 | 더 높음, 여기서 우위 | 근접하나 대체로 조금 뒤짐 |
| 과제 전환 | 모델 전체를 새로 로드 | 프리픽스만 교체 |
| 망각 위험 | 높음, 기존 능력을 잃을 수 있음 | 낮음, 기본 모델이 그대로 유지됨 |
데이터와 연산 자원이 충분해 한 과제에서 최고 정확도를 짜내야 하면 풀 파인튜닝이 이기고, 여러 과제를 서비스하는 대부분의 경우 프리픽스 튜닝이 적은 비용으로 이득 대부분을 줍니다.
혼동하기 쉬운 방법이 Lester 등(2021)의 **프롬프트 튜닝(Prompt Tuning)**입니다. 프롬프트 튜닝도 학습 가능한 숫자 블록을 쓰지만 모델 입력의 입구, 첫 번째 층 앞에 한 번만 붙입니다. 그 숫자는 다른 입력처럼 모델을 통과하고 안쪽 층은 별도로 받는 것이 없습니다. 프리픽스 튜닝은 입력을 건드리지 않고 학습된 키·값을 모든 층의 어텐션에 직접 주입합니다.
| 항목 | 프롬프트 튜닝 | 프리픽스 튜닝 |
|---|---|---|
| 붙는 위치 | 입력에 한 번 | 모든 층의 어텐션 키·값 |
| 학습 파라미터(위 모델 기준) | 20 × 2,048 = 40,960 | 1,966,080 |
| 특징 | 더 단순하고 훨씬 작음 | 비용이 더 들지만 훨씬 강하게 이끎 |
- 프롬프트 튜닝은 층마다 키·값을 따로 두지 않으므로 약 48배 적은 숫자를 학습합니다(1,966,080 ÷ 40,960 = 48).
- 프리픽스 튜닝은 모든 층에서 이끌기 때문에 과제가 어려울수록 성능이 더 낫습니다. 프롬프트 튜닝은 아주 큰 모델에서 쉬운 과제에 좋은 선택이 될 수 있습니다.
과제 난이도와 모델 크기를 보고 둘 중 하나를 고르며, 어려운 과제에 프롬프트 튜닝이 부족하면 프리픽스 튜닝으로 올립니다.
11.3.5 장점과 한계
장점은 다섯 가지입니다.
- 학습이 저렴합니다. 작은 프리픽스만 학습하므로 얼린 수십억 파라미터의 기울기와 옵티마이저 상태를 들고 있지 않아 메모리가 크게 절약됩니다. 다만 학습 신호가 프리픽스에 닿으려면 모든 층을 거슬러 가야 하므로 매 스텝 전체 순전파와 역전파는 그대로 실행됩니다. 절약은 대부분 메모리와 저장 공간이고 속도는 크게 빨라지지 않습니다.
- 과제당 저장이 작습니다. 전체 사본 대신 작은 프리픽스입니다.
- 모델 하나로 여러 과제를 처리합니다. 얼린 모델 하나를 공유하고 프리픽스만 바꿔 과제를 즉시 전환합니다. 요약, 번역, 지원 답변을 프리픽스 세 개로 한 모델에서 서비스하는 식입니다.
- 망각 위험이 낮습니다. 기본 모델이 얼려 있어 원래 파라미터가 그대로 보존됩니다(11.5 참조).
- 배포가 쉽습니다. 모델을 한 번만 올려 여러 과제를 서비스하므로 운영 메모리를 아낍니다.
한계도 있습니다.
- 모든 어텐션 단계에 일이 늘어납니다. 층마다 추가 키·값이 붙어 어텐션이 더 긴 목록을 훑으므로 연산과 메모리가 더 들고, 프리픽스가 길수록 비용이 커집니다. 이것이 실제로 입력 길이를 얼마나 줄이는지는 구현과 모델에 따라 다르므로 가정하지 말고 자기 환경에서 확인해야 합니다.
- 프리픽스가 길다고 항상 좋은 것은 아닙니다. 품질은 어느 지점까지 오르다가 그 뒤에는 오히려 나빠지므로 길이 역시 여러 값을 시도해 조정하는 설정입니다. 원 논문은 표를 문장으로 바꾸는 과제에서 최적점이 가상 토큰 약 10개, 요약에서 약 200개라고 보고했습니다. 어려운 과제일수록 긴 프리픽스를 원합니다.
- LoRA보다 학습시키기 어렵습니다. 프리픽스 숫자는 쉽게 안정되지 않아 원 논문도 추가 기법이 필요했습니다. LoRA는 더 매끄럽게 학습되고 학습된 가중치를 모델에 병합하면 답변 시점에 추가로 짊어질 것이 없습니다(11.2 참조). 이것이 실무에서 LoRA가 프리픽스 튜닝보다 훨씬 흔한 이유 중 하나입니다.
프리픽스 튜닝이 맞는 경우는 매 층에서 이끌기를 원하고 프리픽스 길이와 입력 크기에서 추가 어텐션 비용을 감당할 수 있을 때입니다. 일상적인 적응 작업에서는 LoRA를 먼저 시도하는 쪽이 쉽습니다.
실무 사용처는 과제가 여럿인데 모델은 하나인 조직, 비싼 장비가 없는 팀, 전체 파인튜닝을 세팅하지 않고 새 과제를 시험하려는 연구자, 고객마다 다른 문체나 도메인에 맞춰 작은 프리픽스를 따로 두는 개인화입니다. 고객 상담에서는 과제 수, 하드웨어 예산, 입력 길이 여유를 순서대로 묻고, 별다른 제약이 없으면 LoRA를 기본안으로 제시합니다.
11.4 지식 증류(Knowledge Distillation)
원문: How does Knowledge Distillation work?
큰 모델은 정확하지만 느리고 비쌉니다. 지식 증류는 큰 모델의 행동을 작은 모델이 따라 하도록 학습시켜, 소형 모델이 작아도 유능한 이유(3.1 참조)를 만드는 학습 기법입니다. 2026년 6월 글 기준입니다.
11.4.1 하드 라벨 vs 소프트 라벨
**지식 증류(Knowledge Distillation)**는 작은 모델이 큰 모델의 행동을 따라 하도록 학습시키는 기법입니다. 큰 모델이 교사(teacher), 작은 모델이 **학생(student)**입니다. 경험 많은 선임 교사는 수천 권을 읽었지만 비싸고 느리고 한 명뿐이므로, 이 교사가 젊은 학생을 가르쳐 거의 비슷하게 답하게 만들면 학생은 깊이는 덜해도 빠르고 싸고 일상 업무에 충분합니다.
필요한 이유는 다음과 같습니다.
- 큰 모델은 메모리와 고가 하드웨어가 필요하고 답을 내는 데 시간이 걸립니다. 질문과 응답 사이의 이 지연이 **지연 시간(latency)**입니다.
- 스마트폰, 스마트워치, 카메라, 자동차 같은 작은 기기는 데이터 센터에서 멀리 사용자 곁에 있다는 뜻에서 **엣지 기기(edge device)**라 부르며, 메모리와 배터리가 적어 거대 모델이 들어가지 않습니다.
- 10초 걸리는 채팅 응답은 고장처럼 느껴지고, 수백만 사용자에게 거대 모델을 돌리면 비용이 큽니다.
- 요약하면 큰 모델은 정확하나 느리고 비싸며, 작은 모델은 빠르고 싸지만 혼자서는 덜 정확합니다. 증류는 두뇌를 작은 몸에 옮기면서 지능 대부분을 유지하려는 방법입니다.
사진에서 cat, dog, car, horse 중 무엇이 있는지 맞히는 모델로 라벨의 차이를 봅니다. 각 선택지를 **클래스(class)**라 합니다. 고양이 사진을 보여줄 때의 두 가지 라벨은 다음과 같습니다.
| 클래스 | 하드 라벨 | 소프트 라벨(교사 출력) |
|---|---|---|
| cat | 1 | 0.90 |
| dog | 0 | 0.08 |
| car | 0 | 0.01 |
| horse | 0 | 0.01 |
- **하드 라벨(hard label)**은 정답 하나만 알려주는 라벨로,
cat에 만점을 주고 나머지는 0입니다. 추가 정보가 없는 순수한 진실입니다. - 교사 모델은 단어 하나가 아니라 모든 클래스에 대한 확률(0~1, 합이 1)을 냅니다. 이 전체 확률 분포가 **소프트 라벨(soft label)**입니다.
- 하드 라벨은 "고양이다"만 말하고, 소프트 라벨은 "대부분 고양이이고 약간 개를 닮았고 자동차와는 전혀 다르다"고 말합니다.
고객이 이미 큰 모델을 쓰고 있다면 그 모델의 출력 확률(logprobs 포함)을 얻을 수 있는지가 증류 가능성의 첫 확인 사항입니다(2.14 참조).
11.4.2 다크 널리지(dark knowledge)
소프트 라벨에는 하드 라벨이 버리는 숨은 정보가 있고, 이것이 **다크 널리지(dark knowledge)**입니다. 클래스들이 서로 어떻게 관련되는지에 대해 교사가 아는 것입니다.
- 교사는
dog에 8%,car에 거의 0%를 줍니다. 고양이는 개와 어느 정도 닮았지만 자동차와는 아무 공통점이 없다는 세상에 대한 진짜 지식입니다. 고양이와 개는 둘 다 털이 있는 네발 동물이라 혼동될 수 있고, 고양이와 자동차는 혼동되지 않습니다. - 하드 라벨은 이를 가르치지 못합니다.
dog과car를 똑같이 틀린 것으로 취급합니다. 그러나 약간 개라고 하는 것은 합리적 실수이고 자동차라고 하는 것은 어처구니없는 실수입니다. - 학생이 소프트 라벨로 배우면 고양이와 개는 가깝고 고양이와 자동차는 멀다는 관계를 배웁니다. 정답 하나를 외우는 것보다 훨씬 풍부합니다.
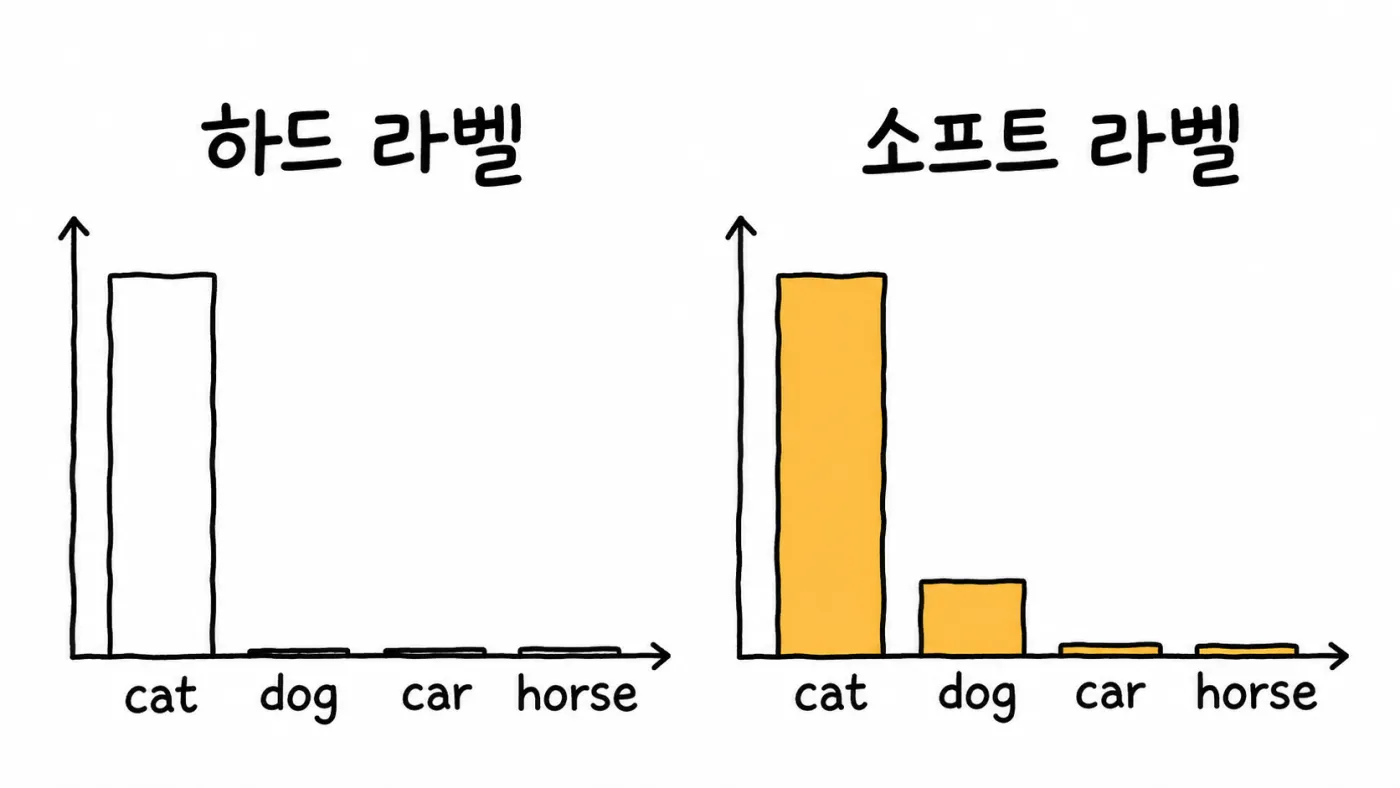
이것이 증류의 핵심이며, 교사의 소프트 라벨은 평범한 하드 라벨이 가르칠 수 있는 것보다 훨씬 많이 가르칩니다. 다만 교사가 지나치게 확신해 cat = 0.99처럼 나머지에 거의 아무것도 주지 않으면 유용한 다크 널리지가 너무 작아져 보이지 않습니다. 그때 쓰는 손잡이가 온도입니다.
11.4.3 Softmax의 온도
모델은 예측할 때 먼저 클래스별 가공 전 점수를 냅니다. 이 원점수가 **로짓(logit)**이며 8.2나 -1.4처럼 어떤 수든 될 수 있어 직접 읽기 어렵습니다(1.12 참조). 합이 1인 깨끗한 확률로 바꾸는 함수가 Softmax입니다(1.11 참조). Softmax에는 돌릴 수 있는 손잡이인 온도(temperature) T가 있어 확률이 얼마나 뾰족하거나 부드럽게 나올지 정합니다(1.11.3 참조).
- 낮은 온도(
T = 1)는 한 클래스가 아주 높고 나머지는 아주 작은 뾰족한 확률을 만듭니다. - 높은 온도(
T = 4)는 더 부드럽고 퍼진 확률을 만들어, 작은 값이 커져 눈에 띕니다.
원문은 같은 예측을 다음과 같이 보여줍니다.
| 온도 | cat | dog | car | horse |
|---|---|---|---|---|
T = 1 |
0.95 | 0.04 | 0.005 | 0.005 |
T = 4 (원문 값) |
0.70 | 0.22 | 0.05 | 0.03 |
dog 값이 0.04에서 0.22로 뛰어 고양이와 개의 관계라는 다크 널리지가 또렷해집니다. 다만 같은 로짓에 T = 4를 실제로 적용해 python3로 계산하면 위 원문 값과 다릅니다. T = 1의 확률 0.95, 0.04, 0.005, 0.005에서 로짓을 역산하고 로짓을 T로 나눠 Softmax를 다시 적용하면 다음과 같습니다.
| 온도 | cat | dog | car | horse |
|---|---|---|---|---|
T = 1 |
0.950 | 0.040 | 0.005 | 0.005 |
T = 2 |
0.741 | 0.152 | 0.054 | 0.054 |
T = 4 |
0.502 | 0.227 | 0.135 | 0.135 |
원문의 T = 4 수치는 방향(뾰족함이 풀리고 작은 값이 커짐)을 보이는 설명용 숫자이고, 같은 로짓의 엄밀한 결과는 위 표와 같습니다. 어느 쪽이든 온도를 올릴수록 car와 horse도 커지며, dog의 상대적 크기가 드러난다는 결론은 같습니다.
- 증류 중에는 온도를 올려 교사의 소프트 라벨이 미묘한 관계를 드러내게 하고, 학생이 더 선명하고 풍부한 수업을 받습니다.
- 높은 온도는 학습 때만 씁니다. 완성된 학생을 실제 서비스에 쓸 때는 원래 온도로 돌아갑니다.
온도는 증류 하이퍼파라미터이므로 값을 바꿔 가며 학생의 검증 성능으로 고르고, 서빙 설정에는 그 값을 옮기지 않도록 구분합니다.
11.4.4 증류 손실
**손실(loss)**은 모델이 얼마나 틀렸는지 재는 값이며, 학습은 모델 숫자를 서서히 바꿔 손실을 줄이는 일입니다. 증류에서 학생은 두 가지를 동시에 해야 합니다.
- 증류 손실(distillation loss): 학생이 같은 사진으로 낸 소프트 확률을 교사의 소프트 확률과 비교해 최대한 가깝게 만듭니다. 두 확률 분포가 얼마나 다른지 재는 척도가 **KL 발산(KL divergence)**이며, 수식은 몰라도 작을수록 두 분포가 비슷하다는 점만 알면 됩니다.
- 일반 손실(normal loss): 학생의 예측을 실제 하드 라벨, 진짜 정답과 비교합니다. 처음부터 모델을 학습할 때 쓰는 손실과 같으며(1.4.3 참조), 이때는 원래 온도를 씁니다.
둘을 모두 두는 이유는 각자 역할이 있어서입니다. 증류 손실은 교사의 풍부한 다크 널리지를 가르치고, 일반 손실은 학생이 실제 정답에 발을 붙이게 해 교사의 실수를 맹목적으로 따라 하지 않게 합니다. 전체 손실은 둘의 가중 혼합입니다.
flowchart TB
    P[같은 사진] --> T[교사 큰 모델]
    P --> S[학생 작은 모델]
    T -->|교사 소프트 라벨| D[증류 손실]
    S -->|학생 소프트 라벨| D
    S -->|학생 예측| N[일반 손실]
    L[진짜 하드 라벨] --> N
    D --> TOT[전체 손실 가중 혼합]
    N --> TOT
그림 11.7 — 같은 사진이 교사와 학생에 모두 들어가고, 증류 손실과 일반 손실이 하나의 전체 손실로 섞입니다.
식으로는 전체 손실 = weight × 증류 손실 + (1 − weight) × 일반 손실입니다. weight는 학생이 교사의 말과 진짜 정답 중 어느 쪽을 얼마나 들을지 정하는 값이며, 추가 지식이 소프트 라벨에 있으므로 교사 쪽에 더 큰 가중을 두는 경우가 많습니다. 이 전체 손실을 작게 만들면 학생이 정답과 교사의 지혜를 함께 배웁니다.
11.4.5 학습 단계별 워크스루
동물 사진 예제로 과정을 따라갑니다.
| 단계 | 하는 일 |
|---|---|
| 1 | 이미 학습되어 정확한 교사를 준비합니다. 증류 중 교사는 전혀 바뀌지 않고 수업만 합니다 |
| 2 | 난수로 시작하는 새 학생을 만듭니다 |
| 3 | 학습 데이터에서 사진 한 장을 뽑습니다(예: 고양이 사진) |
| 4 | 교사에 통과시킵니다. 높은 온도로 다크 널리지가 가득한 소프트 라벨을 얻습니다(cat = 0.70, dog = 0.22, car = 0.05, horse = 0.03) |
| 5 | 같은 사진을 학생에 통과시켜 같은 높은 온도의 소프트 라벨을 얻습니다(cat = 0.50, dog = 0.30, car = 0.15, horse = 0.05) |
| 6 | 두 소프트 라벨을 KL 발산으로 비교해 증류 손실을 구합니다. 아직 다르므로 손실이 큽니다 |
| 7 | 학생의 일반 예측을 진짜 하드 라벨 cat = 1과 비교해 일반 손실을 구합니다. 이때는 원래 온도를 씁니다 |
| 8 | 선택한 가중으로 두 손실을 전체 손실로 섞습니다 |
| 9 | 전체 손실이 작아지도록 학생의 숫자를 조금 고칩니다. 이 한 번의 조정이 학습 한 스텝입니다(1.13 참조) |
| 10 | 3~9단계를 수천 장의 사진에 대해 반복합니다 |
- 4~5단계 예시 값으로 KL 발산(교사 → 학생, 자연로그)을
python3로 계산하면 약 0.097입니다. 두 분포가 같아질수록 이 값은 0에 가까워집니다. - 반복하면서 학생의 소프트 라벨이 교사의 것에 가까워지고, 학생은 정답뿐 아니라 클래스 사이의 풍부한 관계를 배웁니다. 충분히 학습하면 큰 교사와 거의 비슷하게 행동하는 작고 빠른 모델이 됩니다.
증류 학습 로그에서는 증류 손실과 일반 손실을 따로 기록해 두면 학생이 교사를 따라가는지 정답에 맞는지를 분리해 판단할 수 있습니다.
11.4.6 유형과 실제 사례
증류는 학생이 교사의 어느 부분을 따라 하는지에 따라 세 유형으로 나뉩니다.
| 유형 | 따라 하는 대상 | 설명 |
|---|---|---|
| 응답 기반(response-based) | 교사의 최종 답(소프트 라벨) | 지금까지 설명한 가장 단순하고 흔한 유형입니다. 교사가 답하는 모습을 보고 같은 방식으로 답하도록 배웁니다 |
| 피처 기반(feature-based) | 교사의 내부 이해(층의 피처) | 모델은 입력에서 답으로 바로 뛰지 않고 내부 **층(layer)**을 단계적으로 거치며, 이 내부 단계의 출력이 피처입니다. 선임의 최종 답뿐 아니라 풀이 과정과 메모까지 베끼는 것과 같습니다 |
| 관계 기반(relation-based) | 교사가 예제들 사이에서 보는 관계 | 교사가 두 사진을 아주 비슷하다고 보면 학생도 자기 이해 안에서 그 두 사진을 비슷하게 유지합니다. 개별 답이 아니라 예제 사이의 연결을 베낍니다 |
세 유형 모두 학생이 교사처럼 행동하려는 목표는 같고, 교사 행동의 어느 부분을 따라 하는지만 다릅니다. 사용 사례에 따라 고릅니다.
실제 사례는 다음과 같습니다.
- DistilBERT: 텍스트 이해용 언어 모델 BERT를 증류한 모델로, 약 40% 작고 약 60% 빠르며 BERT의 언어 이해 성능의 약 97%를 유지합니다. 훨씬 가벼우면서 정확도 대부분을 지키는 이상적인 거래의 예입니다.
- 작은 채팅 모델: 큰 채팅 모델이 교사로서 고품질 답을 만들고 작은 모델이 그 답을 따라 하도록 학습됩니다. 싸고 빠르게 응답하면서 큰 모델에 가깝게 들리는 소형 모델이 됩니다(3.1 참조).
- 온디바이스 AI: 증류가 가장 빛나는 영역입니다. 스마트폰, 스마트워치, 카메라에서 직접 돌리려면 모델이 작고 빨라야 하므로 큰 정확한 모델을 기기에 들어가는 학생으로 증류합니다. 오프라인 번역, 음성 입력, 스마트 사진 분류가 서버로 데이터를 보내지 않고 기기에서 동작하므로 결과가 빠르고 비용이 낮고 데이터가 기기에 남아 프라이버시가 좋습니다(12.6 참조). 이런 모델은 보통 GGUF 형식으로 배포됩니다(10.9 참조).
- 작은 모델을 얻는 다른 길로 양자화가 있습니다. 같은 모델을 유지하되 숫자를 더 적은 비트로 저장합니다. 증류는 별도의 작은 학생 모델을 교사처럼 학습시키는 방식이므로 둘은 다릅니다(10.8 참조).
DistilBERT의 수치는 2026년 6월 글 기준의 서술이며, 고객이 모델 경량화를 요청하면 증류(새 학생 모델 학습)와 양자화(기존 모델 압축) 중 어느 쪽이 맞는지를 배포 대상 기기와 재학습 가능 여부로 먼저 가릅니다.
11.5 지속 학습(Continual Learning)
원문: What is Continual Learning in LLMs? Solving Catastrophic Forgetting
세상은 매일 바뀌는데 모델의 지식은 학습 시점에 멈춰 있으므로, 새 지식을 넣으면서 기존 지식을 잃지 않는 방법이 필요합니다. 이 절은 파인튜닝(11.1 참조)이 부딪히는 망각 문제와 그 대응을 설명합니다. 2026년 6월 글 기준입니다.
11.5.1 파국적 망각(Catastrophic Forgetting)
**지속 학습(Continual Learning)**은 모델이 시간이 지나며 새 정보를 계속 배우되 이미 배운 것을 잊지 않는 능력입니다. Continual(계속)과 Learning(학습)의 합성어로, 새 데이터가 올 때마다 거듭 배운다는 뜻입니다. 아이가 걷기를 배우고 말하기를 배우고 읽기를 배워도 읽기를 배웠다고 걷는 법을 잊지 않고 기존 기술 위에 새 기술을 쌓는 것과 같습니다. LLM에서 원하는 모습도 이와 같습니다.
필요한 이유는 모델의 지식이 낡기 때문입니다. 새 사건, 새 사실, 새 기술, 새 단어가 매일 생깁니다. 2023년에 학습한 LLM은 2023년까지만 알고 2024년, 2025년, 2026년의 일은 모릅니다. 최신 상태로 유지하는 방법은 두 가지입니다.
| 선택지 | 내용 | 비용 |
|---|---|---|
| 1 | 옛 데이터와 새 데이터를 합쳐 처음부터 다시 학습 | 시간, 돈, 연산 자원이 아주 큼 |
| 2 | 기존 LLM에 새 정보만 가르침 | 저렴하고 빠름 |
선택지 2가 지속 학습이며 그 안의 학습 단계는 파인튜닝입니다. 그러나 선택지 2에는 큰 문제가 있습니다.
**파국적 망각(Catastrophic Forgetting)**은 모델이 새 지식을 배우는 동안 옛 지식을 잊는 현상입니다. 수학, 역사, 과학을 아는 LLM에 스포츠를 가르치려고 스포츠 데이터로만 학습시키면, 스포츠는 잘 알게 되지만 수학, 역사, 과학을 잊습니다. 새 것을 배울 때 옛 것을 파국적으로 잊는다는 뜻입니다.
- 원인은 LLM 안의 수십억 개 파라미터가 모든 지식을 저장하고 있다는 점입니다. 새 데이터로 학습하면 이 파라미터가 갱신되고, 그 갱신이 옛 지식을 덮어씁니다.
- 화이트보드에 옛 글씨 위에 새 글씨를 쓰면 옛 글씨가 지워지는 것과 같습니다.
- 학습 전에는 수학, 역사, 과학이 모두 있던 지식 표가 스포츠만 학습하면 스포츠로 채워져 옛 지식이 덮어써집니다.
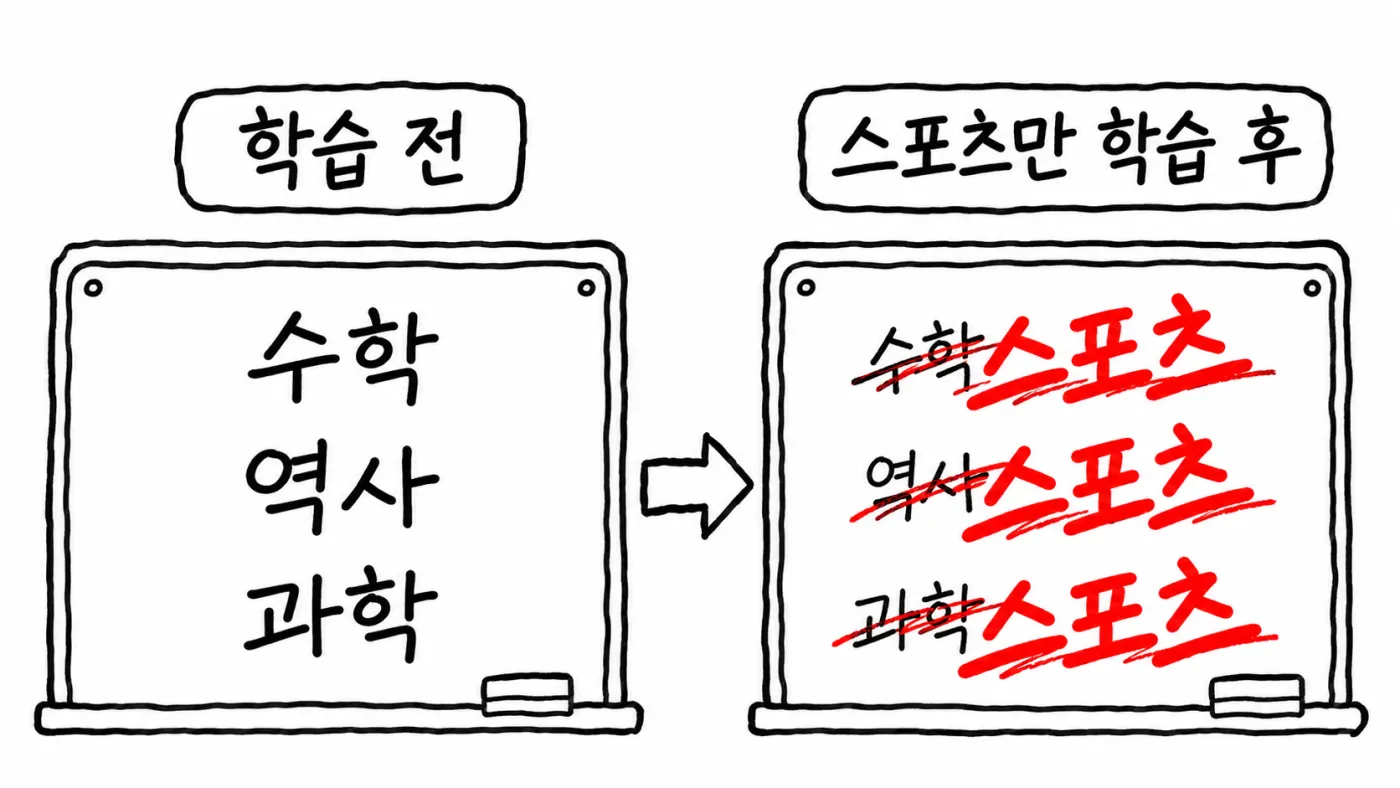
11.1의 "일부 기존 기술이 무뎌진다"는 주의사항이 바로 이 현상이며, 파인튜닝 후에는 새 과제 점수와 함께 기존 능력 점수도 측정해야 합니다(8.1 참조). 고객이 "특화 모델을 만들었더니 일반 질문을 못 한다"고 말한다면 가장 먼저 의심할 원인입니다.
11.5.2 LLM 지속 학습 접근
망각을 피하면서 새 것을 가르치는 접근은 크게 세 가지입니다.
| 접근 | 핵심 | 장점 | 단점 |
|---|---|---|---|
| 리플레이 기반 | 새 데이터에 옛 데이터 일부를 섞어 학습 | 단순하고 실무에서 잘 동작 | 학습 비용이 되돌아옴 |
| 정규화 기반 | 중요한 파라미터가 크게 바뀌지 않도록 보호 | 옛 데이터를 저장할 필요 없음 | 중요 파라미터 판별이 어렵고 과보호하면 새 학습이 안 됨 |
| 파라미터 격리 | 옛 파라미터를 얼리고 작은 새 파라미터만 학습 | 옛 지식 완전 보존, 저렴 | 과제마다 파라미터가 늘어 모델이 커짐 |
리플레이 기반(Replay-based) 방법은 새 데이터와 옛 데이터 일부를 섞어서 학습합니다. 스포츠 데이터에 수학, 역사, 과학 예제를 함께 섞어 학습하면 새 챕터만 공부하지 않고 옛 챕터도 복습하는 시험 준비 학생처럼 옛 지식을 계속 연습합니다. 단점은 비용입니다. 망각을 막으려고 옛 데이터를 섞으므로 매번 추가 데이터를 학습하게 되어 연산, 시간, 돈이 더 들며, 옛 데이터를 너무 많이 섞으면 처음부터 학습하는 것과 비슷한 비용이 되어 피하려던 것으로 돌아갑니다.
정규화 기반(Regularization-based) 방법은 모델의 중요한 파라미터가 너무 많이 바뀌지 않게 보호합니다. 파라미터 중 일부는 옛 지식에 아주 중요하고 일부는 그렇지 않으므로, 새 학습에서 중요하지 않은 것은 자유롭게 바꾸고 중요한 것은 많이 바꾸지 말라고 모델에 요구합니다.
- 대표 방법이 **EWC(Elastic Weight Consolidation)**입니다. 옛 지식에 중요한 파라미터를 알아내 새 학습 동안 보호합니다.
- 새 도시로 이사해 새 길, 새 가게, 새 사람을 배워도 가족과 오랜 친구에 대한 기억은 잃지 않는 것과 같습니다. 뇌가 중요한 기억을 보호합니다.
- 단점은 어떤 파라미터가 중요한지 알아내기 어렵고, 너무 많이 보호하면 새 지식을 잘 배우지 못한다는 점입니다. 옛 지식을 지키는 것과 새 지식을 배우는 것 사이의 균형 문제입니다.
파라미터 격리(Parameter isolation) 방법은 옛 파라미터를 얼려 두고 작은 새 파라미터 묶음만 추가해 새 지식을 학습합니다. 수십억 파라미터는 전혀 건드리지 않고, 그 위에 작은 새 파라미터를 얹어 새 데이터로 이것만 학습하므로 옛 지식은 얼린 파라미터 안에 안전하고 새 지식은 새 파라미터에 저장됩니다. 책에 새 챕터를 끝에 덧붙이는 것과 같습니다.
- LoRA가 대표적입니다. LLM에 작은 행렬을 추가하고 이것만 새 데이터로 학습하며 원래 LLM은 건드리지 않습니다(11.2 참조).
- 프리픽스 튜닝도 같은 계열입니다. 새 파라미터가 모든 어텐션 층에서 추가 키와 값을 제공하는 작은 프리픽스이며 원래 LLM은 얼려 있습니다(11.3 참조).
- 원래 파라미터를 건드리지 않으므로 옛 지식이 완전히 안전하고 학습 파라미터가 적어 저렴합니다. 단점은 새 과제마다 파라미터를 계속 추가하면 시간이 지나 모델이 점점 커진다는 점입니다.
세 방법의 차이를 한 줄로 보면, 리플레이는 옛 데이터를 섞어 전체 모델을 학습하고, 정규화는 중요한 파라미터를 잠그고 나머지를 자유롭게 하며, 파라미터 격리는 원래 파라미터를 완전히 얼리고 작은 새 파라미터만 학습합니다.
flowchart LR
    A[새 지식 반영] --> B[리플레이 기반<br/>옛 데이터 섞어 전체 학습]
    A --> C[정규화 기반 EWC<br/>중요 파라미터 보호]
    A --> D[파라미터 격리 LoRA<br/>원본 고정, 새 파라미터만 학습]
그림 11.9 — 지속 학습의 세 접근은 옛 지식을 지키는 방식이 데이터, 파라미터 보호, 파라미터 분리로 서로 다릅니다.
고객의 제약이 옛 데이터를 보관할 수 없는 환경이라면 리플레이가 어렵고, 저장 공간이 충분하고 과제가 몇 개로 한정되어 있다면 파라미터 격리가 현실적입니다.
11.5.3 RAG라는 대안
새 지식을 주려고 항상 LLM을 갱신해야 하는 것은 아닙니다. LLM은 그대로 두고 새 지식을 밖에서 주는 방법이 **RAG(Retrieval-Augmented Generation)**입니다(5장 참조).
- 새 지식을 외부 데이터베이스에 저장합니다. 사용자가 질문하면 먼저 관련 정보를 데이터베이스에서 가져오고, 질문과 함께 LLM에 주면 LLM이 그 정보를 이용해 답합니다.
- 외부 저장소는 보통 벡터 DB이며 의미로 저장하고 검색합니다(5.1 참조).
- LLM은 한 번도 바뀌지 않습니다. 필요한 정보를 답하는 순간에 읽을 뿐이며, 책을 펴고 보는 오픈북 시험과 같습니다. 학생이 전부 외울 필요가 없습니다.
- 장점은 LLM을 다시 학습하지 않아도 되고 데이터베이스만 갱신하면 새 정보를 즉시 추가할 수 있다는 점입니다.
- 단점은 LLM이 새 정보를 진정으로 배우지는 않고 필요할 때 읽을 뿐이라는 점입니다.
그래서 RAG는 엄밀히는 지속 학습이 아닙니다. 그러나 파국적 망각 문제 없이 LLM을 최신 정보로 유지하는 아주 널리 쓰이는 방법입니다. 11.1의 판단과도 맞닿아 있습니다. 사실을 읽게 하는 것이 목적이면 프롬프트나 검색으로 충분하고, 모델의 행동을 바꾸는 것이 목적일 때 학습을 합니다.
고객이 "최신 규정이 바뀔 때마다 모델을 다시 학습시켜야 하느냐"고 물으면, 기본안은 RAG로 지식을 갱신하고 스타일이나 형식 변경만 학습으로 다루는 분리입니다.
11.5.4 도전 과제
지속 학습은 어려운 문제이며 주요 도전은 다음과 같습니다.
- 파국적 망각: 가장 큰 문제입니다.
- 리플레이 비용: 리플레이 방식은 옛 데이터를 반복해 다시 학습하므로 추가 학습 비용이 큽니다.
- 연산 비용: 일부만 학습하더라도 LLM 학습은 비쌉니다.
- 평가: 모델이 새 지식을 실제로 배웠는지, 옛 지식을 잊지 않았는지 어떻게 아는가라는 문제로, 좋은 평가 방법이 필요합니다(8.1 참조).
- 안정성 대 가소성(stability vs plasticity): 모델은 옛 것을 기억할 만큼 안정적이어야 하고 새 것을 배울 만큼 유연해야 합니다. 이 균형을 맞추기가 어렵습니다.
- 데이터 품질: 새 데이터에 오류나 편향이 있으면 LLM도 그것을 배웁니다. 새 데이터의 품질에 각별히 주의해야 합니다.
실제 활용 사례는 다음과 같습니다.
- 뉴스, 스포츠 점수, 주가 같은 최신 사건에 맞춰 LLM 갱신
- 일반 LLM을 의료나 법률 같은 특정 분야 전문가로 만드는 도메인 적응
- 특정 사용자의 선호와 스타일을 가르치는 개인화
- LLM이 틀린 답을 하면 처음부터 재학습하지 않고 올바른 답을 가르치는 오류 수정
- 기존 언어를 잃지 않고 새 언어를 추가
FDE가 지속 학습 요구를 받으면 새 지식의 변경 빈도, 옛 능력의 보존 중요도, 옛 데이터 보관 가능 여부를 묻고, 평가 세트에 기존 능력 항목을 포함시켜 학습 전후에 비교하도록 합의합니다. 새 데이터의 오류와 편향이 그대로 모델에 들어간다는 점도 계약 단계에서 데이터 책임자를 정해 두는 근거가 됩니다.
11.6 RLHF(인간 피드백 강화학습)
원문: What is RLHF? Reinforcement Learning from Human Feedback Explained
사전학습된 LLM은 인터넷 글을 흉내 낼 뿐 도움이 되는 어시스턴트가 아닙니다. 이 절은 1.14의 강화학습을 LLM 정렬에 적용해, 사람의 선호를 학습 신호로 바꾸는 3단계 파이프라인을 설명합니다. 2026년 5월 글 기준입니다.
11.6.1 1단계: SFT
**RLHF(Reinforcement Learning from Human Feedback)**는 LLM이 사람이 선호하는 응답을 내도록 사람의 선호를 모아 보상 신호로 바꾸고, 그 신호로 추가 학습을 이끄는 기법입니다. 모델이 응답을 생성하고 사람이 어느 쪽이 나은지 고르면 앞으로의 응답이 선호된 쪽을 닮도록 모델을 갱신합니다. 이름 그대로 강화학습(시행착오로 배우며 보상을 더 받도록 행동을 조정, 1.14 참조)에 사람 피드백을 더한 것으로, 보상이 고정된 자동 지표가 아니라 모델 출력을 비교해 더 나은 것을 고르는 실제 사람에게서 옵니다. 이 아이디어는 게임과 로봇을 가르친 2017년 논문 Deep RL from Human Preferences에서 시작해, OpenAI가 InstructGPT 논문으로 언어 모델에 적용했고 ChatGPT로 이어졌습니다.
필요한 이유는 다음과 같습니다.
- 사전학습 모델은 방대한 인터넷 글에서 다음 토큰(단어 또는 단어의 일부, 2.4 참조)을 예측하도록만 학습되었습니다. 언어와 세상에 대해 많이 알지만 좋은 어시스턴트가 되는 법은 모릅니다.
- "케이크는 어떻게 굽나요?"라고 물으면 또 다른 질문이나 레시피 제목 목록, 웹 페이지처럼 보이는 무작위 글로 이어 쓸 수 있습니다. 모델이 고장 난 것이 아니라 인터넷 글을 모방하도록만 학습되었기 때문입니다.
- 원하는 것은 유용하고, 지시를 따르고, 지어내지 않고 정직하고, 해로운 내용을 내지 않고, 장황하지 않게 명확한 응답이며, 이를 고정된 규칙이나 손실 함수로 적기 어렵습니다. "이 답은 유용하고 저 답은 아니다"를 말하는 공식이 없습니다.
- 그러나 사람은 두 답을 보고 어느 쪽이 나은지는 쉽게 말합니다. RLHF는 "A가 B보다 낫다" 같은 단순한 판단을 학습 신호로 바꾸는 다리입니다.
- 비유하면 세상의 모든 요리책을 읽은 신입 요리사는 레시피는 많이 알지만 손님이 실제로 무엇을 좋아하는지 모릅니다. 식당이 여러 요리를 내고 손님에게 두 버전을 나란히 맛보게 해 더 좋은 쪽을 고르게 하면 요리사는 손님이 실제로 좋아하는 음식을 만들게 됩니다. 요리사가 LLM이고 손님이 사람 라벨러입니다.
RLHF는 단일 학습 단계가 아니라 세 단계 파이프라인(SFT + 보상 모델 + RL 파인튜닝)입니다.
flowchart TB
    A[사전 학습 기본 LLM] --> B[1단계 SFT<br/>지시 따르기 학습]
    B --> C[2단계 보상 모델<br/>사람의 선호 학습]
    C --> D[3단계 RL 파인튜닝<br/>보상으로 LLM 개선]
    D --> E[정렬된 최종 LLM]
그림 11.10 — RLHF는 SFT, 보상 모델, RL 파인튜닝의 세 단계로 사전학습 LLM을 정렬합니다.
**SFT(Supervised Fine-Tuning, 지도 파인튜닝)**는 사전학습된 기본 LLM을 사람이 쓴 고품질 프롬프트-응답 쌍의 엄선된 데이터셋으로 파인튜닝하는 단계입니다(11.1 참조). 데이터셋은 보통 작지만 품질이 아주 높아 정성 들여 쓴 예제 약 1만~10만 개라고 원문은 설명합니다. 참고로 InstructGPT 논문의 SFT 데이터는 프롬프트 약 1만 3천 건이었습니다. "이것이 좋은 질문이고 이것이 좋은 답"이라는 예를 보여주고 그 스타일을 모방하도록 학습하며, 입력과 정답이 있는 전형적인 지도 학습입니다(1.2.1 참조). 예를 들어 프롬프트 "10살 아이에게 광합성을 설명해 줘"에 식물이 햇빛, 물, 공기로 양분을 만든다는 응답을 짝지은 쌍들입니다.
- SFT 후 모델은 좋은 답의 모양을 알고, 프롬프트를 무작위로 이어 쓰는 대신 지시를 따르려 합니다.
- 그러나 SFT만으로는 부족합니다. 모든 질문과 뉘앙스를 덮을 만큼 예제를 쓸 수 없고, 사람은 완벽한 답을 처음부터 쓰는 것보다 두 답을 비교하는 일을 훨씬 잘합니다.
- 초보자는 SFT를 최종 단계로 오해하기 쉽지만 SFT는 다음 두 단계가 동작하게 하는 토대일 뿐입니다.
고객이 "우리 데이터로 지시 따르기 파인튜닝을 하면 정렬이 끝나는가"라고 물으면 SFT는 출발점이며 선호 기반 단계가 별도로 있다는 점을 짚습니다.
11.6.2 2단계: 보상 모델 학습
**보상 모델(Reward Model)**은 프롬프트와 응답을 받아 사람이 그 응답을 얼마나 선호할지 예측하는 점수 하나를 내는 별도 모델입니다. 점수가 높으면 사람이 선호할 가능성이 높고 낮으면 거절할 가능성이 높습니다.
학습에 쓰는 선호 데이터(preference data) 수집 과정은 다음과 같습니다.
- 프롬프트를 고릅니다.
- SFT 모델로 같은 프롬프트에 대해 둘 이상의 서로 다른 응답을 생성합니다.
- 응답을 사람 라벨러에게 보여줍니다.
- 사람이 더 나은 응답을 고릅니다.
예를 들어 "공부할 때 집중하려면?"에 응답 A는 25분 일하고 5분 쉬는 포모도로 기법, 응답 B는 "그냥 더 집중해, 게으르지 마"라면 사람의 선호는 "A가 B보다 낫다"입니다. 실제 시스템에서는 원문은 보통 3만~10만 쌍을 모은다고 설명하며(InstructGPT 논문의 보상 모델 학습 프롬프트는 약 3만 3천 건), 쌍마다 "이 프롬프트에서 A가 B를 이긴다"는 분명한 신호를 줍니다.
- 보상 모델은 보통 같은 SFT 모델에서 시작하되 마지막 층을 숫자 하나를 내는 작은 헤드로 교체합니다.
- 위 쌍에서 학습된 보상 모델은 예컨대
Score(A) = 2.4,Score(B) = -1.1을 낼 수 있습니다. 정확한 값은 중요하지 않고 격차, 즉 A가 B보다 높다는 점이 중요합니다. - 학습 목표는 선호된 쪽 A가 B보다 높은 점수를 받게 하는 것입니다. 쌍마다 A와 B를 각각 보상 모델에 통과시켜 두 점수를 얻고
Score(A)가Score(B)보다 높아지도록 손실을 줍니다. 이 손실은 Bradley-Terry 쌍별 선호 손실이라 부르며 직관은 "A의 점수를 B 위로 밀어 올린다"입니다. - 수천 쌍을 반복하면 보상 모델은 "좋은 응답이 어떤 모양인지"에 대한 풍부하고 흐릿한 개념을 배웁니다. 엄격한 규칙이 아니라 수천 건의 사람 판단으로 빚은 학습된 함수입니다.
- 보상 모델은 최종 LLM이 아니라 다음 단계에서 실제 LLM을 가르치는 데 쓰는 보조 모델입니다.
보상 모델의 품질이 곧 파이프라인의 상한이므로 고객의 라벨링 지침, 라벨러 수, 라벨러 간 일치도를 먼저 묻는 것이 선호 데이터 단계의 핵심 확인 사항입니다.
11.6.3 3단계: PPO 강화학습
RL 파인튜닝에서는 LLM을 **정책(policy)**으로 보고 강화학습 알고리즘으로 가중치를 갱신해 보상 모델에서 높은 점수를 받는 응답을 생성하게 합니다. 정책은 현재 상황에서 다음에 취할 행동을 정하는 함수이며(1.14.1 참조), LLM에서는 상황이 프롬프트와 지금까지 생성한 토큰이고 행동이 다음에 생성할 토큰입니다. 즉 LLM 자체가 정책입니다.
가장 흔한 알고리즘은 **PPO(Proximal Policy Optimization)**입니다. 정책을 작고 통제된 걸음으로 갱신해 학습을 안정시키며, 보통 0.2 정도의 클립 비율로 한 번의 갱신에서 새 정책이 이전 정책과 얼마나 다를 수 있는지를 제한합니다.
PPO는 정책과 함께 **가치 모델(Value Model, 크리틱)**도 학습합니다. 실제 보상을 보기 전에 응답이 얼마나 좋을지 예측하는 모델이며, 보상 모델의 실제 보상과 가치 모델의 예측 차이로 **어드밴티지(advantage)**를 계산합니다. 어드밴티지는 응답이 기대보다 얼마나 낫거나 나빴는지를 말하고, PPO는 이를 클립된 목적 함수 안에서 정책 갱신에 씁니다.
| 모델 | 역할 |
|---|---|
| 정책 모델(Policy Model) | 학습 중인 LLM |
| 가치 모델(Value Model, 크리틱) | 기대 보상을 예측해 어드밴티지 계산에 사용 |
| 보상 모델(Reward Model) | 사람의 선호에 따라 응답을 채점(2단계 산출물) |
| 참조 모델(Reference Model) | SFT 모델의 얼린 복사본, KL 페널티에 사용 |
- PPO 기반 RLHF는 네 모델이 함께 돌아가므로 비쌉니다.
- DeepSeek-R1에서 쓴 GRPO(Group Relative Policy Optimization) 같은 새 알고리즘은 샘플링한 응답 그룹으로 기준선을 계산해 가치 모델을 없애므로 세 모델로 줄어듭니다.
루프는 다음과 같습니다.
- 학습 데이터셋에서 프롬프트를 뽑습니다.
- 현재 LLM(정책)이 응답을 생성합니다.
- 보상 모델이 그 응답을 채점합니다.
- PPO가 점수가 높았으면 이런 응답이 더 나오게, 낮았으면 덜 나오게 LLM 가중치를 갱신합니다.
- 많은 프롬프트에 대해 반복합니다.
충분히 반복하면 LLM은 사람이 선호하는 응답을 훨씬 잘 냅니다. 더 나은 답을 우리가 써 주어서가 아니라, 모델이 시행착오와 보상으로 어떤 답이 높은 점수를 받는지 스스로 알아냈기 때문입니다. 이것이 RLHF의 핵심입니다.
네 모델이 동시에 올라가는 메모리 요구를 고객의 GPU 예산과 맞춰 보는 것이 PPO 기반 접근의 첫 타당성 검토이고, 자원이 빠듯하면 모델 수가 적은 대안(11.7 참조)이 후보가 됩니다.
11.6.4 KL 페널티
PPO가 보상만 높이도록 밀면 LLM이 SFT 모델에서 아주 멀리 벗어날 수 있습니다. 이상하고 반복적이거나 주제에서 벗어난 응답이 보상 모델에서는 우연히 높은 점수를 받지만 실제로는 나쁜 경우가 생기며, 이는 보상 해킹(11.6.5 참조)과 깊이 관련된 실제 문제입니다.
이를 막으려고 학습 목표에 KL 페널티를 더합니다. KL은 Kullback-Leibler 발산으로 두 확률 분포가 얼마나 다른지 재는 척도입니다(11.4.4 참조). 두 분포가 같으면 0이고 아주 다르면 큰 양수입니다. KL 페널티는 LLM의 출력 분포가 원래 SFT 모델의 출력 분포에서 너무 멀어지면 벌을 주는 항입니다. 모델에 "보상을 최대화하되 SFT 모델이 말하던 방식에서 너무 벗어나지 말라"고 말하는 셈입니다.
전체 RL 목적은 대략 목적 = 보상(응답) − beta × KL(LLM, SFT 모델)입니다.
| 항 | 의미 | 원하는 방향 |
|---|---|---|
| 보상(응답) | 보상 모델의 점수 | 높게 |
| KL(LLM, SFT 모델) | 현재 LLM이 SFT 모델과 다른 정도 | 작게 |
beta |
페널티 세기를 정하는 손잡이, 원문은 실무에서 작게 대개 0.01~0.2라고 설명하며 외부 출처로는 확인하지 못했습니다 | 조정 |
beta = 0.1에서 보상이 3.0인 응답을 python3로 계산해 봅니다.
| 상황 | KL | 목적값 |
|---|---|---|
| 적당히 떨어짐 | 4.0 | 3.0 − 0.1 × 4.0 = 2.6 |
| 더 멀리 이탈 | 20.0 | 3.0 − 0.1 × 20.0 = 1.0 |
모델이 더 멀리 이탈하면 원래 보상 점수가 같은 3.0이어도 목적값이 떨어지므로 지나친 이탈은 보상을 깎습니다. 실제 구현에서 KL 페널티는 보통 응답 전체에 한 번이 아니라 생성 중 토큰마다 적용되어 매 단계의 보상 신호에 녹아 들어가며, 위 식은 상위 수준의 추상입니다. KL 페널티가 없으면 모델이 보상 모델을 속이는 헛소리로 붕괴할 수 있고, 있으면 좋은 언어에 발을 붙인 채 더 높은 점수를 배웁니다.
beta 시작값은 0.01~0.05의 작은 값에서 모델 행동을 보며 조정하는 것이 권장됩니다. 너무 낮으면 모델이 표류하고 너무 높으면 새로 배우는 것이 거의 없습니다.
11.6.5 보상 해킹(Reward Hacking)
**보상 해킹(Reward Hacking)**은 LLM이 보상 모델에서 높은 점수를 받는 요령을 찾았지만 실제로는 사람에게 좋은 응답이 아닌 현상입니다. 보상 모델은 완벽한 심판이 아니라 한 모델이므로 사각지대가 있고, LLM이 그것을 발견하면 악용합니다.
- 보상 모델이 길고 자신 있는 답을 선호한 데이터로 학습되었기 때문에 모델이 지나치게 길고 자신만만해집니다.
- 그 패턴이 높은 점수와 상관되었기 때문에 "저는 도움이 되는 어시스턴트입니다" 같은 군더더기가 늘어납니다.
- 선호 데이터에서 위험한 답보다 거절이 더 안전했던 경우가 있어서 무해한 질문도 조심스러워 거절합니다.
KL 페널티가 중요한 이유이며, 실무에서 선호 데이터를 계속 갱신하고 보상 모델을 재학습하며 RLHF를 여러 라운드 도는 이유이기도 합니다. 보상 모델은 사람의 선호를 대신하는 대리 지표일 뿐이고, 우리 일은 LLM이 그것을 악용하는 데 능숙해질수록 대리 지표를 정직하게 유지하는 것입니다. 지나치게 공손하지만 실질 내용은 적은 챗봇이 대표적인 징후입니다.
보상 점수 상승만 보고하는 대시보드는 위험 신호이며, 사람이 최종 LLM을 직접 평가하는 별도 평가 세트를 두어야 보상 해킹을 일찍 잡습니다(8.1 참조).
11.6.6 흔한 실수와 모범 사례
흔한 실수는 여섯 가지입니다.
| 실수 | 내용 | 결과 |
|---|---|---|
| 1. SFT 생략 | 기본 사전학습 모델에 바로 RL 파인튜닝 | 기본 모델은 쓸 만한 어시스턴트와 너무 멀어 PPO가 좋은 신호를 못 찾음. 항상 SFT부터 |
| 2. 약한 보상 모델 | 작거나 학습이 부실하거나 잡음 많은 데이터로 학습 | 파이프라인 전체가 잘못 배움. LLM은 보상 모델이 허락하는 만큼만 정렬됨 |
| 3. KL 페널티 무시 | 페널티 없이 학습 | 보상 해킹된 헛소리로 표류. 선택 사항이 아님 |
| 4. 일회성 데이터 수집 | 한 번만 수집 | 첫 라운드가 보상 모델과 LLM의 약점을 드러내므로 새 모델 출력에 새 선호 데이터를 모아 재학습해야 함 |
| 5. 보상 모델을 진실로 혼동 | 학습된 근사를 정답으로 취급 | 보상 해킹으로 직행 |
| 6. 라벨러 무시 | 라벨러 간 불일치, 불명확한 지침 | 보상 모델이 상충하는 신호를 배움. 좋은 RLHF는 좋은 라벨링 지침에서 시작 |
모범 사례는 일곱 가지입니다.
- 강한 SFT로 시작합니다. 좋은 SFT 모델은 RL 단계에 깨끗한 출발점을 주어 더 쉽고 안정적입니다.
- 선호 데이터 품질에 투자합니다. 명확한 라벨링 지침, 항목당 여러 라벨러, 라벨 품질의 지속 감사가 데이터 크기 하나보다 중요합니다.
- 학습 내내 KL 페널티를 유지합니다.
beta를 신중히 조정합니다. - 반복합니다. 라운드마다 갱신된 LLM으로 새 응답을 생성하고 새 선호를 수집해 보상 모델을 재학습해 낡지 않게 합니다.
- 보상 점수 너머를 평가합니다. 목표는 높은 보상 모델 점수가 아니라 실제 사람의 선호입니다. 사람이 최종 LLM을 직접 평가하는 보류 평가 세트를 둡니다.
- 과잉 거절을 감시합니다. RLHF는 모델을 지나치게 조심스럽게 만들기 쉬우므로 일반 프롬프트의 거절률을 추적하고, 무해한 질문을 거절하면 선호 데이터가 편향된 것이므로 재균형합니다.
- 안전과 유용성 선호를 섞습니다. 유용성("어느 답이 더 유용한가")과 안전("어느 답이 더 안전한가")을 모두 덮는 선호 데이터를 써서 한쪽으로만 치우치지 않게 합니다.
세 개의 데이터셋(SFT 쌍, 선호 쌍, RL용 프롬프트), 세 개의 모델, 하나의 정렬된 LLM이 전체 RLHF 파이프라인입니다. 고객에게 RLHF 프로젝트를 제안할 때는 라벨러 운영, 라운드 수, 과잉 거절 지표를 일정과 비용에 포함시켜 한 번에 끝나는 작업으로 오해되지 않게 합니다.
11.7 DPO(Direct Preference Optimization)
원문: What is Direct Preference Optimization (DPO) and How Does It Work?
RLHF는 효과적이지만 보상 모델, 가치 모델, 참조 모델, PPO가 맞물린 무거운 구조입니다. DPO는 이 중 보상 모델과 강화학습을 없애고 사람의 선호 데이터로 모델을 직접 학습시키는 대안입니다. 2026년 5월 글 기준입니다.
11.7.1 RLHF의 문제
RLHF는 사람이 모델 응답을 순위 매기고, 그 순위로 별도의 보상 모델을 학습한 뒤, PPO 같은 알고리즘으로 언어 모델을 갱신해 더 높은 점수의 응답을 내게 하는 방법입니다(11.6 참조). 갱신하는 동안 원래 언어 모델의 얼린 복사본인 참조 모델을 두어, 새 모델이 이미 알던 것에서 너무 멀리 벗어나지 않게 하는 안전 닻으로 씁니다. 이 전체 절차는 OpenAI의 InstructGPT 논문에서 왔고, 그 논문은 2017년의 Deep RL from Human Preferences 논문을 토대로 했습니다.
필요한 이유는 모델이 방대한 텍스트로 학습되어 어떤 질문에든 응답할 수 있지만 그 응답이 항상 유용하거나 안전하거나 사람이 좋아하는 어조는 아니기 때문입니다. "코딩은 어떻게 배우나요?"에 아주 길고 건조하고 학술적인 답을 낼 수 있는데, 사람은 짧고 친근하고 단계별인 답을 선호합니다.
RLHF는 동작하지만 복잡하며 이유는 다음과 같습니다.
- 별도의 보상 모델이라는 또 다른 신경망을 학습하고 저장하고 학습 중 실행해야 합니다.
- PPO 같은 강화학습 알고리즘은 쓰기 쉽지 않습니다. 세심한 튜닝이 필요하고 학습이 불안정해질 수 있으며, 보상 모델이 완벽하지 않으면 모델이 이상한 텍스트를 생성하기 시작할 수 있습니다.
- PPO는 **가치 모델(value model, 크리틱)**도 필요합니다. 매 단계 기대 보상을 예측해 어드밴티지 계산을 돕는 모델이며 언어 모델과 거의 같은 크기여서, 아주 큰 모델 두 개를 동시에 학습하게 되어 파이프라인이 더 비싸집니다.
- 요약하면 기본 모델, 보상 모델, 참조 모델, 가치 모델, PPO 알고리즘이 움직이는 부품입니다. 각 부품이 실패할 수 있고 세심한 튜닝이 필요하며, 전체 과정이 느리고 비쌉니다.
케이크를 굽는데 온도 설정이 각기 다른 기계 열 대를 쓰는 것과 같아서 한 대만 고장 나도 케이크 전체를 망칩니다. 해법으로 나온 것이 DPO입니다.
고객이 RLHF를 요청했다면 보상 모델 학습과 PPO 운영 인력이 있는지를 먼저 묻고, 없다면 이 절의 대안을 검토 순서에 올립니다.
11.7.2 선호 데이터(Preference Data)
**DPO(Direct Preference Optimization)**는 별도의 보상 모델도 강화학습도 쓰지 않고 사람의 선호 데이터로 대규모 언어 모델을 직접 학습시키는 방법입니다. 이름을 풀면 다음과 같습니다.
- Direct: 선호로 곧바로 학습하며 사이에 보상 모델이 없습니다.
- Preference: 두 응답 중 어느 쪽이 나은지에 대한 사람의 선택입니다.
- Optimization: 모델을 더 낫게 만드는 일입니다.
복잡한 RLHF 파이프라인 전체를 단 하나의 단순한 학습 단계로 바꾸는 것이며, 오븐 하나로 케이크를 굽는 것과 같습니다.
**선호 데이터(preference data)**는 한 예제가 세 부분으로 구성된 데이터 모음입니다.
| 구성 | 뜻 |
|---|---|
| 프롬프트(prompt) | 질문 또는 지시 |
| 선택된 응답(chosen response) | 사람이 선호한 응답 |
| 거부된 응답(rejected response) | 사람이 선호하지 않은 응답 |
예를 들어 프롬프트 "코딩은 어떻게 배우나요?"에 선택된 응답은 "Python 같은 한 언어로 시작하고, 매일 작은 프로젝트를 만들고, 서서히 더 큰 도전을 하고, 꾸준히 하세요"처럼 짧고 친근하며 명확한 단계를 줍니다. 거부된 응답은 "코딩은 수년의 헌신적 공부로 배워야 할 언어, 프레임워크, 패러다임, 도구가 방대한 분야입니다"처럼 학술적이고 별로 도움이 되지 않습니다. DPO에 이런 쌍을 많이 주면 모델이 선택된 응답을 닮고 거부된 응답은 닮지 않게 생성하도록 가르칩니다.
이 구조는 11.6.2의 선호 쌍과 같은 형태이며, 차이는 쌍으로 보상 모델을 학습하지 않고 언어 모델 자체를 학습한다는 점입니다.
선호 쌍의 수집 비용은 그대로 남으므로 고객 현장에서 쓸 만한 선호 쌍이 이미 있는지(예: 상담원이 고른 답과 버린 답의 이력)를 확인하는 것이 DPO 도입의 첫 질문입니다.
11.7.3 DPO 손실 함수
DPO의 핵심 발상은 영리합니다. RLHF는 먼저 모든 응답에 점수를 주는 보상 모델을 학습한 뒤 그 점수로 언어 모델을 학습합니다. DPO의 저자들은 언어 모델 자체가 자신의 보상 모델 역할을 할 수 있다는 것을 알아챘습니다. 언어 모델이 여러 응답에 부여하는 확률이 이미 모델이 각 응답을 얼마나 선호하는지 알려 주고, 이 확률을 영리하게 쓰면 선호 데이터로 모델을 곧바로 학습시킬 수 있습니다.
- 비유하면 RLHF는 음식 비평가를 고용해 접시에 점수를 매기도록 훈련시킨 뒤 요리사가 비평가의 점수에 맞춰 요리하게 하는 방식입니다. DPO는 요리사에게 "이 접시가 낫고 이 접시가 못하다, 이 예로 배워라"라고 직접 말합니다. 중간의 비평가가 없습니다.
- 어떤 프롬프트에서 모델이 선택된 응답보다 거부된 응답에 더 높은 확률을 주면 모델이 틀린 선호를 갖고 있는 것입니다. DPO는 선택된 응답의 확률을 올리고 거부된 응답의 확률을 내리도록 모델을 갱신하여, 학습 후 선택된 응답에 더 높은 확률을 주게 되며 사람의 선호와 일치합니다.
- 이로써 복잡한 강화학습 문제가 단순한 지도 학습 문제로 바뀝니다.
손실 함수는 수식으로는 겁나 보이지만 아이디어는 단순합니다.
손실 = −log( sigmoid( beta × ( log_ratio_chosen − log_ratio_rejected ) ) )
| 기호 | 뜻 |
|---|---|
log_ratio_chosen |
선택된 응답에 대해 새 모델 확률 대 참조 모델 확률의 비의 로그 |
log_ratio_rejected |
거부된 응답에 대해 같은 비의 로그 |
beta |
참조 모델에서 얼마나 멀어져도 되는지 정하는 작은 수, 흔한 값은 0.1 |
sigmoid |
어떤 수든 0과 1 사이 값으로 눌러 주는 함수(1.10 참조) |
| 참조 모델 | 학습 전 원래 모델의 얼린 복사본 |
새 모델이 거부된 응답보다 선택된 응답에 더 높은 확률을 주기를 원하되 참조 모델에서 너무 멀리 벗어나는 것은 원하지 않으며, beta가 이 균형을 조절합니다. beta가 작으면 새 모델이 많이 변해도 되고 크면 참조 모델 가까이에 머물도록 강제됩니다. 참조 모델은 RLHF의 PPO에서 쓰는 참조 모델과 비슷한 안전 닻 역할을 하여 새 모델이 너무 멀어져 이미 아는 것을 잊지 않게 합니다(11.6.4 참조).
- 새 모델이 이미 선택된 응답을 거부된 응답보다 강하게 선호하면
sigmoid안의 값이 커져sigmoid가 1에 가까워지고 손실이 0에 가까워집니다. 이미 옳게 하고 있어 배울 것이 없습니다. - 새 모델이 거부된 응답을 더 선호하면
sigmoid안의 값이 음수가 되어sigmoid가 작아지고 손실이 커지며, 모델이 이를 고치도록 갱신됩니다.
값을 직접 넣어 보면 이 말이 숫자로 보입니다. beta = 0.1에서 log_ratio_chosen − log_ratio_rejected를 격차 m이라 하고 python3로 −log(sigmoid(0.1 × m))을 계산한 설명용 예입니다.
| 상황 | 격차 m | 손실 |
|---|---|---|
| 학습 시작(새 모델 = 참조 모델) | 0 | 0.6931 |
| 선택된 응답 쪽으로 약간 이동 | 3 | 0.5544 |
| 거부된 응답 쪽으로 약간 이동 | −3 | 0.8544 |
| 선택된 응답을 강하게 선호 | 30 | 0.0486 |
| 거부된 응답을 강하게 선호 | −30 | 3.0486 |
학습이 시작될 때는 새 모델과 참조 모델이 같으므로 격차가 0이고 손실은 log 2, 즉 0.6931입니다. 격차가 커질수록 손실이 0으로 가고, 틀린 쪽으로 커질수록 손실이 급격히 커집니다. 이 손실 하나를 일반 지도 학습처럼 최소화하면 DPO 학습입니다.
11.7.4 단계별 동작
동작은 여섯 단계입니다.
- 사전학습된 언어 모델에서 시작합니다. 대개 지시 파인튜닝도 마친 모델이며(11.1 참조), 이 모델의 얼린 복사본인 참조 모델도 함께 둡니다.
- 선호 데이터를 모읍니다. 예제마다 프롬프트, 선택된 응답, 거부된 응답이 있습니다.
- 예제마다 선택된 응답과 거부된 응답의 확률을 새 모델과 참조 모델 양쪽에서 계산합니다.
- DPO 손실 함수로 손실을 계산합니다. 참조 모델과 비교해 새 모델이 거부된 응답보다 선택된 응답을 충분히 선호하지 않을수록 손실이 큽니다.
- 손실을 최소화하도록 새 모델을 갱신합니다. 다른 신경망을 학습할 때와 똑같은 경사하강법 학습 스텝입니다(1.13 참조).
- 3~5단계를 많은 예제와 여러 에폭에 걸쳐 반복합니다(1.7 참조).
flowchart LR
    D[선호 쌍 프롬프트 선택 거부] --> N[새 모델 확률]
    D --> R[참조 모델 확률 고정]
    N --> L[DPO 손실]
    R --> L
    L -->|경사하강법| N
그림 11.11 — 선호 쌍에서 새 모델과 고정된 참조 모델의 확률을 구해 하나의 손실로 합치고, 새 모델만 갱신합니다.
학습이 끝나면 모델이 사람의 선호를 따르도록 훈련되며, 보상 모델도 강화학습도 없이 단순한 학습 루프 하나로 끝납니다. 예전에는 완전한 강화학습 설정이 필요했던 문제를 하나의 손실 함수로 푸는 것이 DPO의 미덕입니다.
학습 점검에서는 학습 손실이 내려가는지와 함께 선택된 응답의 확률이 실제로 올라가는지를 로그로 남겨 두면 모델이 선호를 배우는지 확인할 수 있습니다.
11.7.5 DPO vs RLHF(PPO), 장단점
| 항목 | DPO | RLHF(PPO) |
|---|---|---|
| 보상 모델 | 불필요 | 필요 |
| 가치 모델(크리틱) | 불필요 | 필요 |
| 알고리즘 | 지도 학습 | 강화학습 |
| 학습 안정성 | 안정적 | 불안정할 수 있음 |
| 구현 | 단순 | 복잡 |
| 연산 비용 | 낮음 | 높음 |
| 하이퍼파라미터 튜닝 | 쉬움 | 어려움 |
| 메모리 사용 | 낮음 | 높음 |
| 성능 | 많은 경우 경쟁력 있음 | 강하지만 달성하기 더 어려움 |
DPO는 더 단순하고 빠르고 안정적입니다. RLHF는 때로 더 나은 결과를 줄 수 있지만 훨씬 많은 노력이 듭니다. 단순하고 믿을 만한 선호 학습 방법이 필요하면 DPO가 낫고, 자원이 있고 복잡한 과제에서 절대적 최고 성능이 필요하면 RLHF가 특정 상황에서 여전히 유용합니다. 두 방법 모두 자리가 있으나 DPO는 단순함 덕분에 아주 널리 퍼졌습니다.
장점은 여섯 가지입니다.
- 보상 모델이 없습니다. 별도의 보상 모델을 학습하지 않아 시간, 연산, 메모리를 아낍니다.
- 강화학습이 없습니다. PPO의 복잡성을 다루지 않고 단순한 지도 학습을 씁니다.
- 학습이 안정적입니다. 강화학습이 없어서 훨씬 안정적입니다.
- 구현이 단순합니다. DPO 손실 함수는 몇 줄의 코드로 구현됩니다.
- 연산 비용이 낮습니다. RLHF보다 메모리와 연산이 적습니다.
- 경쟁력 있는 성능입니다. 많은 경우 최종 모델 품질에서 RLHF와 같거나 더 낫습니다.
단점도 여섯 가지입니다.
- 쌍 데이터가 필요합니다. 선택된 응답과 거부된 응답의 선호 쌍이 필요하며 이 수집에는 여전히 사람의 노력이 듭니다. 선호 데이터를 없애 주는 방법이 아닙니다.
- 데이터 품질에 한계가 묶입니다. 선호 데이터에 잡음이 있으면 모델이 틀린 선호를 배웁니다.
- 하이퍼파라미터에 민감합니다.
beta값이 성능에 영향을 주므로 신중히 조정해야 합니다. - 과대적합할 수 있습니다. 지도 학습이므로 특히 작은 데이터셋에서 선호 데이터에 과대적합할 수 있습니다(1.5.1 참조).
- 탐색이 적습니다. 강화학습처럼 새로운 응답을 탐색하지 않고 우리가 준 데이터에서만 배웁니다.
- 좋은 출발 모델이 필요합니다. 지시 파인튜닝을 마친 모델에서 가장 잘 동작하며, 출발 모델이 약하면 DPO가 완전히 고치지 못합니다. 지시 파인튜닝되지 않은 기본 모델에도 적용은 가능하지만 효과가 떨어집니다.
beta는 흔히 0.1이 출발점으로 쓰이며, 값을 바꿔 가며 검증 결과로 고릅니다. 오늘날 많은 최신 오픈소스 언어 모델이 학습 과정에서 DPO를 쓴다고 원문(2026년 5월)은 서술합니다.
고객이 선호 정렬을 요청하면 선호 쌍 확보 여부, 출발 모델의 지시 수행 수준, 연산 예산을 세 가지로 확인하고, 모두 갖추지 못했다면 DPO 이전에 SFT와 데이터 정비부터 제안합니다. 복잡한 과제에서 절대 성능이 최우선이고 자원이 충분한 경우에만 RLHF를 비교 대상에 올립니다.
11.8 고객이 내일 묻는다면
각 질문에 소리 내어 답해보고, 막히면 표시된 절로 돌아가십시오. 답은 적어 두지 않았으며, 로드맵이 제시한 통과 기준은 "내일 고객이 물어도 설명하고 결정할 수 있는가"입니다.
- "저희 문서 내용을 모델이 알게 하려면 파인튜닝해야 하죠?" 사실을 넣는 일과 행동을 바꾸는 일 중 무엇인지 어떻게 가르고, 어떤 선택지를 권합니까? (11.1.4, 11.5.3)
- "파인튜닝 데이터는 몇 건이나 있어야 하나요?" 건수 외에 무엇을 먼저 확인합니까? (11.1.1, 11.1.4)
- "GPU 한 장뿐인데 7B 모델을 튜닝할 수 있나요?" 풀 파인튜닝과 LoRA의 메모리 차이를 숫자로 설명해 보십시오. (11.1.3, 11.2.1, 11.2.3)
- "LoRA 랭크는 몇으로 잡아야 하나요?" 랭크를 키우면 무엇을 얻고 무엇을 잃습니까? (11.2.3)
- "부서마다 과제가 다른데 모델 사본을 따로 둬야 하나요?" 어댑터를 병합할지 분리할지 어떤 기준으로 정합니까? (11.2.5)
- "프리픽스 튜닝은 프롬프트에 문장을 붙이는 것과 뭐가 다른가요?" 프리픽스가 어디에 들어가고 무엇이 학습됩니까? (11.3.1, 11.3.2, 11.3.4)
- "작은 모델이 큰 모델만큼 답할 수 있게 만들 수 있나요?" 소프트 라벨과 다크 널리지로 설명해 보십시오. (11.4.1, 11.4.2)
- "증류할 때 온도를 높이라는데 왜 그런가요?" 온도가 확률에 하는 일과 증류 손실이 두 부분인 이유는 무엇입니까? (11.4.3, 11.4.4)
- "특화 모델을 만들었더니 일반 질문을 못 풀어요." 무슨 현상이고, 어떤 대응 세 가지를 비교하겠습니까? (11.5.1, 11.5.2, 11.5.4)
- "RLHF는 왜 단계가 세 개나 되나요?" 각 단계의 입력과 출력은 무엇입니까? (11.6.1, 11.6.2, 11.6.3)
- "점수는 오르는데 답변이 이상해집니다." 보상 해킹과 KL 페널티로 무슨 일이 일어난 것인지 설명해 보십시오. (11.6.4, 11.6.5)
- "RLHF 대신 DPO를 쓰면 안 되나요?" 무엇이 빠지고 어떤 데이터가 필요하며 언제 한계가 있습니까? (11.7.1, 11.7.2, 11.7.5)