12. AI 시스템 설계와 인프라
AI 시스템의 속도와 비용은 계산 능력보다 숫자를 어디에 두고 얼마나 빨리 옮기느냐가 정하며, 모델 서빙·GPU·TPU·LPU·배포 위치의 선택은 모두 그 한 가지 문제의 다른 답입니다. FDE가 고객에게 "어디에서, 어떤 칩으로, 어떻게 돌릴 것인가"를 묻고 추천하는 언어가 여기서 나옵니다.
학습 동기: 이 장을 읽으면 학습된 모델 파일이 API 뒤의 서비스가 되기까지 필요한 일을 짚고, 모델이 VRAM에 들어가는지와 토큰당 속도의 천장을 직접 계산하며, GPU·TPU·LPU의 차이와 클라우드·온디바이스·하이브리드 선택 기준을 고객에게 설명할 수 있습니다.
선행 가정: 1.7의 배치, 1.9.3의 순전파, 1.9.4의 역전파를 알고 있다고 가정합니다. 10.8의 양자화, 10.11~10.14의 로컬 실행과 추론 엔진, 3.6의 LLM 라우팅, 11.4의 지식 증류, 13.1의 음성 에이전트가 나오면 해당 절을 참조합니다. 코드는 짧은 CUDA 예시 하나만 사용합니다.
도입 가이드: AI System Design (https://github.com/amitshekhariitbhu/ai-system-design)
12.1 모델 서빙(Model Serving)
원문: How does Model Serving work?
학습이 끝난 모델은 디스크 위의 파일일 뿐이며, 사용자가 답을 받으려면 그 파일을 API 뒤에서 계속 돌아가는 시스템으로 바꿔야 합니다. 이 절은 2026년 11월 1일 글 기준으로 그 시스템이 하는 일을 한 요청의 이동 경로, 배칭, 복제본, 모니터링 순서로 풀어 설명합니다. 10.12~10.14의 추론 엔진은 이 서빙 시스템의 한 부품에 해당합니다.
**모델 서빙(Model Serving)**은 학습된 모델을 API 뒤에 두어, 애플리케이션이 입력을 보내면 실시간으로 예측을 돌려받게 하는 일입니다. 새 입력으로 모델을 돌려 예측을 얻는 계산이 **추론(inference)**이고, 서빙은 그 추론을 실제 사용자에게 실시간으로 제공하는 방식입니다. 고양이와 개를 구분하는 모델이 있다고 합시다. 모델 파일만으로는 사용자에게 아무것도 해줄 수 없고, 서빙이 파일을 실행 중인 프로그램으로 감싸 API를 열어 주어야 사진 앱이 사진을 보내고 곧바로 "고양이" 또는 "개"를 받습니다. 추론과 서빙은 같은 말이 아닙니다. 추론은 계산 한 번이고 서빙은 그 계산을 둘러싼 전처리, 배칭, 확장까지 책임지는 시스템입니다.
서빙이 필요한 이유와 여섯 단계
모델 파일 하나로는 사용자를 받을 수 없으며, 파일 주변에서 해결해야 할 문제가 다섯 가지 있습니다.
- 모델 파일은 데이터일 뿐이라 요청을 받을 창구가 없습니다.
- 큰 모델은 적재에 시간과 메모리가 들어 요청마다 새로 올릴 수 없습니다.
- 앱은 초당 수천 건의 요청을 받을 수 있는데 모델 사본 하나로는 감당하지 못합니다.
- 사용자는 사진이나 문장 같은 원본을 보내지만 모델은 정해진 숫자 형식을 기대하므로 누군가 변환해야 합니다.
- 모델이 죽으면 사용자는 오류를 받으므로 상태를 지켜보는 장치가 필요합니다.
서빙은 이 다섯 문제를 모델 바깥에서 해결해 모델이 예측이라는 한 가지 일에만 집중하게 합니다. 요청 하나가 처리되는 순서는 아래 여섯 단계입니다.
| 단계 | 이름 | 하는 일 |
|---|---|---|
| 1 | 가중치 적재 | 시작 시 디스크의 모델을 읽어 메모리, 대개 GPU에 올립니다. 시작할 때 한 번만 일어납니다. |
| 2 | 엔드포인트 개설 | 요청을 받을 API 주소인 **엔드포인트(endpoint)**를 엽니다. |
| 3 | 요청 수신 | 사용자 앱이 사진이나 문장을 엔드포인트로 보냅니다. |
| 4 | 전처리(preprocessing) | 원본 입력을 모델이 기대하는 숫자 형식으로 바꿉니다. |
| 5 | 순전파 | 준비된 입력으로 모델이 입력에서 출력까지 계산해 예측을 얻습니다. |
| 6 | 후처리(postprocessing) | 모델의 원시 출력을 사람이 읽는 답으로 바꿔 엔드포인트로 돌려보냅니다. |
flowchart TD
    A[사용자 앱이 사진 전송] --> B[엔드포인트 수신]
    B --> C[전처리: 사진을 숫자로]
    C --> D[순전파: 모델 계산]
    D --> E[후처리: 숫자를 고양이/개로]
    E --> F[앱으로 응답]
그림 12.1 — 요청은 엔드포인트로 들어가 전처리, 순전파, 후처리를 거쳐 한 줄로 되돌아 나갑니다. 사용자는 입력과 답만 보고 가운데 단계는 서빙 시스템 안에 가려집니다.
고객이 "모델은 이미 있다"고 말할 때 이 다섯 문제 중 어느 것이 아직 비어 있는지 짚으면 실제 남은 작업량이 보입니다.
12.1.1 가중치 메모리 로딩
**가중치(weight)**는 학습 중에 모델이 얻은 숫자들이며 모델의 지식 그 자체입니다. 작은 모델은 수백만 개, 대규모 언어 모델은 수십억 개의 가중치를 가집니다. 예측하려면 이 숫자가 모두 빠른 메모리에 올라와 있어야 하고, 요청마다 디스크에서 읽으면 너무 느립니다. 그래서 서빙 프로그램은 시작할 때 한 번 적재하고 이후에는 메모리에 둔 채 씁니다.
큰 모델의 가중치는 GPU에 올립니다. GPU는 수천 개의 연산을 동시에 처리할 수 있고, 순전파는 대부분 곱셈과 덧셈이므로 잘 맞습니다(12.2 참조).
flowchart LR
    subgraph 시작 시 한 번
    D[디스크의 모델 파일] --> G[GPU에 가중치 적재]
    end
    subgraph 요청마다 반복
    I[입력] --> M[GPU가 적재된 가중치로 계산] --> P[예측]
    end
    G -.상주.-> M
- 적재는 시작할 때 한 번 치르는 비용입니다.
- 이후에는 GPU가 이미 가중치를 들고 있으므로 요청은 디스크를 건드리지 않고 처리됩니다.
- 모델 자체가 거대해도 서빙된 모델이 빠르게 느껴지는 이유가 이것입니다.
반대로 시작 비용이 크다는 점이 약점입니다. 새 복제본이나 새 버전을 띄울 때마다 적재 시간이 걸리므로, 고객에게 오토스케일링을 약속하기 전에 모델 적재에 몇 분이 걸리는지부터 확인합니다.
12.1.2 요청 배칭
GPU는 수천 연산을 한꺼번에 할 수 있지만 요청을 하나씩만 주면 대부분이 놉니다. 승객이 한 명뿐인 빈 버스를 운행하는 것과 같습니다.
**배칭(batching)**은 여러 요청을 묶어 한 번에 모델에 통과시키는 방식입니다. 네 명의 사용자가 거의 같은 순간에 사진을 보냈다고 합시다. 배칭이 없으면 GPU는 사진 1, 2, 3, 4를 차례로 네 번 실행하고, 배칭이 있으면 네 장을 한 번의 순전파로 처리해 예측 네 개를 냅니다.
| 방식 | GPU 실행 횟수 | 설명 |
|---|---|---|
| 배칭 없음 | 4회 | 사진을 한 장씩 따로 실행하며 GPU 대부분이 유휴 상태입니다. |
| 배칭 있음 | 1회 | 네 장을 묶어 한 번에 실행하므로 GPU가 채워집니다. |
배칭에는 대가가 있습니다. 몇 개의 요청이 모일 때까지 기다려야 하므로 요청마다 조금씩 지연이 늘어납니다. 대신 전체로 처리하는 요청 수는 크게 늘어나므로 배치 크기는 사용 사례에 맞춰 조절합니다. LLM 서버가 매 단계에서 GPU를 놀리지 않게 하는 방법은 연속 배칭(continuous batching)이라는 별도 주제입니다(10.5 참조).
고객 시스템이 요청을 하나씩 순차로 모델에 넣고 있다면 GPU 사용률이 낮을 가능성이 크므로, 배칭 도입 여부를 첫 번째로 확인합니다.
12.1.3 지연 vs 처리량
**지연(latency)**은 요청 하나에 답하는 데 걸리는 시간이고, **처리량(throughput)**은 일정 시간에 답할 수 있는 요청 수입니다. 쉽게 말해 지연은 "사용자 한 명이 얼마나 기다리는가", 처리량은 "초당 몇 명을 받는가"입니다.
커피숍에 바리스타가 한 명뿐인 경우를 생각해 봅시다. 한 잔을 빨리 내리면 그 손님의 지연은 낮지만, 분당 몇 잔밖에 못 만드니 처리량이 낮고 손님이 백 명 오면 줄이 길어집니다. 배칭은 이 둘에 반대로 작용해, 각 요청이 조금 더 기다리므로 지연은 약간 오르고 묶어서 처리하므로 처리량은 크게 오릅니다.
| 배치 크기 | 지연 | 처리량 |
|---|---|---|
| 작은 배치 | 낮음 | 낮음(GPU가 차지 않음) |
| 큰 배치 | 다소 높음(각 사용자가 조금 기다림) | 높음(GPU를 충분히 씀) |
- 사용자마다 즉각적인 답이 중요하면 배치를 작게 유지해 지연을 낮춥니다.
- 수많은 사용자를 싸게 처리하는 것이 중요하면 배치를 키우고 지연 약간을 받아들입니다.
- 라이브 채팅은 낮은 지연이 필요하고, 수백만 건을 처리하는 백그라운드 시스템은 처리량이 우선입니다.
고객이 "빠르게"라고만 말하면 지연인지 처리량인지가 불분명합니다. 응답 하나의 대기 시간 목표와 하루 처리 건수 목표를 따로 물어 배치 크기의 출발점을 정합니다.
12.1.4 복제본과 로드 밸런서로 확장
모델 사본 하나가 처리할 수 있는 양에는 한계가 있습니다. **확장(scaling)**은 서빙되는 모델의 사본을 여러 개 띄워 전체가 더 많은 요청을 감당하게 하는 방법이며, 실행 중인 사본 하나하나가 **복제본(replica)**입니다. 복제본 하나가 초당 100건을 처리한다면 열 개는 대략 초당 1,000건을 처리합니다.
복제본이 열 개일 때 요청이 어디로 갈지 정해야 하며, 한 복제본에만 몰리고 나머지는 비어 있으면 곤란합니다. 이 역할을 맡는 것이 **로드 밸런서(load balancer)**입니다. 모든 복제본 앞에 서서 들어오는 요청을 고르게 나누어 주는 교통 정리 담당이며, 은행에서 새 손님을 비어 있는 창구로 안내하는 직원과 같습니다.
flowchart TD
    U[사용자 요청] --> LB[로드 밸런서]
    LB --> R1[복제본 1]
    LB --> R2[복제본 2]
    LB --> R3[복제본 3]
모든 복제본이 같은 모델을 들고 있으므로 어느 쪽이 답해도 결과가 같습니다. 그래서 시스템은 로드 밸런서 뒤에 복제본을 더하는 것만으로 커집니다.
직접 서빙 시스템을 만들지 않고 **서빙 프레임워크(serving framework)**를 쓸 수도 있습니다. 엔드포인트, 배칭, 요청 처리 같은 공통 작업을 대신하고 사용자는 모델만 끼워 넣습니다. 2026년 11월 글 기준으로 소개된 대표 도구는 다음과 같습니다.
| 프레임워크 | 특징 | 적합한 경우 |
|---|---|---|
| TensorFlow Serving | TensorFlow로 만든 모델을 서빙합니다. | TensorFlow 모델 |
| NVIDIA Triton | 여러 라이브러리의 모델을 서빙할 수 있고 GPU를 잘 쓰도록 만들어졌습니다. | PyTorch 모델 등 다양한 모델 |
| vLLM(10.12 참조) | 대규모 언어 모델 전용이며 높은 처리량으로 서빙합니다. | LLM |
고객이 어떤 모델 형식을 쓰는지에 따라 프레임워크 후보가 갈리므로, 모델 종류부터 확인한 뒤 도구를 고릅니다.
12.1.5 온라인 vs 배치 서빙
서빙 방식은 사용자가 지금 기다리고 있는지로 갈립니다. **온라인 서빙(online serving)**은 사용자가 기다리는 동안 요청마다 실시간으로 답하는 방식이며 실시간 서빙이라고도 합니다. 채팅 비서가 메시지에 답하거나 결제 버튼을 누르는 순간 사기 여부를 점검하는 경우가 해당합니다.
**배치 서빙(batch serving)**은 많은 입력을 모았다가 아무도 기다리지 않는 때에 한꺼번에 모델을 돌리는 방식이며 오프라인 서빙이라고도 합니다. 쇼핑몰이 1,000만 명 모두에게 내일의 추천 상품을 미리 계산하는 경우를 봅시다. 실시간으로 기다리는 사용자가 없으므로 밤에 1,000만 명 분을 한 번의 대규모 배치 작업으로 돌려 결과를 저장해 두고 아침에 보여 줍니다.
| 항목 | 온라인 서빙 | 배치 서빙 |
|---|---|---|
| 실행 시점 | 지금, 요청이 올 때 | 나중에, 일정에 따라 |
| 사용자 대기 | 즉시 기다림 | 기다리지 않음 |
| 속도 요구 | 빠름, 낮은 지연 | 느려도 됨 |
| 예 | 채팅 응답, 사기 점검 | 야간 추천 계산 |
기준은 하나, 지금 이 답을 기다리는 사람이 있는가입니다. 기다리는 사람이 없으면 배치 서빙이 더 싸고 단순합니다. 고객 요구 중 실제로 즉시 응답이 필요한 부분이 의외로 적은 경우가 많아, 요구를 하나씩 이 질문으로 걸러 배치로 돌릴 수 있는 것을 분리합니다.
12.1.6 모니터링과 버전 관리
서빙이 현장에서 믿을 만하려면 두 장치가 더 필요합니다. **모니터링(monitoring)**은 서빙 시스템이 건강하고 좋은 답을 내는지 계속 지켜보는 일입니다. 운영 중인 모델을 보는 계기판에 해당하며 다음을 관찰합니다.
- 요청 하나에 걸리는 시간
- 실패한 요청의 수
- GPU의 바쁜 정도
- 예측이 여전히 올바른지
문제가 생기면 많은 사용자가 영향받기 전에 경보로 알려 줍니다.
**버전 관리(versioning)**는 지금 어느 버전의 모델이 서빙되는지 추적해 안전하게 교체하거나 되돌리게 하는 일입니다. 더 나은 모델이 나오면 엔드포인트를 새 버전으로 바꾸고, 새 버전이 더 나쁘면 즉시 옛 버전으로 돌아갑니다. 이 되돌림이 **롤백(rollback)**입니다. 안전한 관행은 새 버전에 트래픽의 일부만 먼저 보내고 모니터링을 지켜본 뒤 문제가 없을 때만 전체를 옮기는 것입니다.
flowchart TD
    U[사용자 요청] --> LB[로드 밸런서]
    LB -->|95%| V1[버전 1 기존]
    LB -->|5%| V2[버전 2 신규]
    V2 --> MON[모니터링이 버전 2 감시]
- 로드 밸런서가 대부분의 사용자는 검증된 옛 버전으로, 일부만 새 버전으로 보냅니다.
- 새 버전이 좋아 보이면 트래픽을 조금씩 옮기고, 나빠 보이면 롤백해 모두를 옛 버전으로 돌립니다.
- 잘못된 새 모델의 피해는 5%의 사용자에게만 미칩니다.
모니터링은 건강 여부를 알려 주고 버전 관리는 모델을 안전하게 바꾸게 해 줍니다. 고객 운영팀에는 이전 버전으로 몇 분 안에 되돌릴 수 있는지, 새 버전을 몇 퍼센트의 트래픽부터 시작하는지를 확인합니다. 아직 계기판 지표가 정해지지 않았다면 롤백 판단 기준도 없다는 뜻입니다.
12.2 딥러닝을 위한 GPU
원문: How does a GPU work for Deep Learning?
서빙 시스템의 비용과 속도는 대부분 GPU가 결정하므로, GPU가 왜 딥러닝에 맞는지와 무엇이 한계가 되는지를 알아야 고객과 하드웨어 사양을 논의할 수 있습니다. 이 절은 2026년 7월 3일 글 기준으로 CPU와 GPU의 구조 차이에서 출발해 행렬 곱, 메모리, 저정밀 연산, 소프트웨어 스택, 멀티 GPU까지 이어지는 한 줄기를 설명합니다.
**GPU(Graphics Processing Unit)**는 단순한 계산을 아주 많이 동시에 처리하는 데 능한 칩입니다. 이름대로 처음에는 게임 같은 그래픽을 그리려고 만들었습니다. 화면은 수백만 개의 점인 픽셀로 이루어져 있고, 게임을 그리려면 그 모든 픽셀의 색을 초당 여러 번 정해야 합니다. 그런데 픽셀 하나의 계산은 다른 픽셀을 기다리지 않아도 되는 독립 작업입니다. 그래서 작고 독립적인 계산 수백만 개를 함께 처리하는 칩이 만들어졌고, 딥러닝이 바로 같은 종류의 일을 요구한다는 사실이 알려지면서 게임용 칩이 현대 AI의 중심이 되었습니다.
12.2.1 CPU vs GPU
**CPU(Central Processing Unit)**는 컴퓨터의 주 두뇌로, 소수의 강력한 **코어(core)**를 가집니다. 코어는 실제 계산을 수행하는 부분이며, 일반 노트북 CPU는 4, 8, 16개 정도를 가집니다. CPU 코어는 복잡한 작업을 처리하고 판단하며 여러 일을 빠르게 오갈 수 있어서 운영체제와 앱을 돌리는 일을 맡습니다. GPU는 반대로 수천 개의 작고 단순한 코어를 가집니다. 각 코어는 복잡한 판단에 약하지만 곱하고 더하는 단순한 일은 잘 하며, 수가 많으므로 수천 건을 동시에 처리합니다.
| 항목 | CPU | GPU |
|---|---|---|
| 코어 수 | 소수(4~64개) | 수천 개 |
| 코어 하나의 성능 | 강력하고 영리함 | 단순함 |
| 잘하는 일 | 복잡한 작업, 판단, 앱 실행 | 단순한 계산을 한꺼번에 |
| 일하는 방식 | 적은 수의 일을 빠르게 | 방대한 수의 일을 함께 |
수학 교수와 학생 비유로 보면 차이가 분명해집니다. 간단한 곱셈과 덧셈 100만 개가 적힌 문제지가 있다고 합시다.
- 방식 1, 교수 한 명: 똑똑하고 빠른 교수가 문제를 차례로 풉니다. 아무리 빨라도 한 사람이 100만 개를 한 줄로 풀면 오래 걸립니다. 이 교수가 CPU 코어에 해당합니다.
- 방식 2, 학생 수천 명: 큰 강당의 학생들에게 문제를 하나씩 나눠 주면 모두가 같은 순간에 풀어 한 번에 수천 개가 끝납니다. 이것이 GPU입니다.
어려운 문제 하나는 교수가 이기지만 단순한 문제 100만 개는 학생들이 훨씬 빨리 끝냅니다. 일을 한 줄로 처리하는 방식이 **직렬(serial)**이고 여럿이 동시에 처리하는 방식이 **병렬(parallel)**입니다. CPU는 이런 계산을 대체로 직렬로 하고, GPU는 수천 개의 곱셈-덧셈을 수천 개의 코어에 나눠 주어 함께 끝냅니다.
flowchart LR
    subgraph CPU 직렬
    a1[덧셈 1] --> a2[덧셈 2] --> a3[덧셈 3] --> a4[... 덧셈 1,000,000]
    end
    subgraph GPU 병렬
    b1[덧셈 1] --> d[함께 완료]
    b2[덧셈 2] --> d
    b3[덧셈 3] --> d
    b4[...] --> d
    end
그림 12.2 — CPU는 연산을 한 줄로, GPU는 수천 개씩 한꺼번에 처리합니다.
딥러닝은 단순한 계산이 쌓인 산이라는 점에서 두 번째 종류의 문제이며, CPU로도 학습은 가능하지만 느립니다. 고객이 "기존 CPU 서버로 돌려 보자"고 하면 모델이 작고 요청이 적은 경우에만 현실적이라는 점을 짚어 줍니다.
12.2.2 행렬 곱이 딥러닝의 본체
**딥러닝(deep learning)**은 **신경망(neural network)**으로 데이터에서 패턴을 배우는 방법입니다. 신경망은 가중치라는 숫자의 큰 묶음이며, 정답이 나올 때까지 그 숫자를 반복해서 조정합니다. 신경망이 이 숫자로 하는 일은 곱셈과 덧셈이며, 이것이 수백만 번 반복되는 주된 작업입니다.
신경망 안의 숫자는 한 줄로 저장되지 않고 **행렬(matrix)**이라는 격자, 곧 행과 열로 놓인 숫자 표에 담깁니다. 입력 데이터도 행렬이고 가중치도 행렬이며, 둘을 행렬 곱셈으로 결합해 답을 냅니다. 행렬 곱셈의 본질은 "곱하고 더하는" 단계, 곧 **곱셈-덧셈(multiply-add)**의 대량 반복입니다.
작은 예를 직접 계산해 봅시다.
[1 2]   [5 6]   [19 22]
[3 4] x [7 8] = [43 50]
결과의 왼쪽 위 숫자는 첫 행 [1, 2]와 첫 열 [5, 7]으로 구합니다.
(1 x 5) + (2 x 7) = 5 + 14 = 19나머지 세 칸도 같은 방식입니다. 오른쪽 위는 1x6 + 2x8 = 22, 왼쪽 아래는 3x5 + 4x7 = 43, 오른쪽 아래는 3x6 + 4x8 = 50입니다. 여기서 핵심은 결과의 각 칸이 서로를 기다리지 않는 독립 계산이라는 점입니다. 실제 신경망의 행렬은 2x2가 아니라 수천 행과 수천 열이므로 한 번의 행렬 곱이 수백만 개의 독립적인 곱셈-덧셈입니다. 가령 1,000x1,000 행렬 두 개를 곱하면 결과 칸이 100만 개이고 칸마다 1,000번의 곱셈-덧셈이 들어 총 10억 번입니다. 이는 앞의 문제지, 곧 단순한 계산 100만 개와 같은 구조이며 GPU가 가장 잘하는 일입니다.
- 서로 기다릴 필요가 없으므로 병렬 처리에 알맞습니다.
- 학습은 이 계산을 수십억 번 되풀이하므로 병렬화의 이득이 며칠짜리 작업을 몇 시간으로 줄입니다.
고객의 워크로드가 이런 행렬 곱 중심인지, 아니면 데이터 전처리나 분기가 많은 일반 로직인지에 따라 GPU 투자의 효과가 갈립니다.
12.2.3 VRAM과 메모리 대역폭
계산이 빠른 것은 이야기의 절반이고, GPU는 계산에 필요한 숫자를 가까이에 두고 기다리지 않고 일해야 합니다. **VRAM(Video Random Access Memory)**은 GPU 자신의 전용 메모리로, 모델의 가중치와 처리 중인 데이터 같은 현재 작업 중인 숫자를 두는 작업대입니다. 작업대가 클수록 서류를 한꺼번에 많이 펼쳐 놓고 작업할 수 있습니다.
**메모리 대역폭(memory bandwidth)**은 GPU가 메모리와 코어 사이에서 숫자를 옮기는 속도입니다. 작업대가 커도 서류를 들이는 문이 좁으면 일이 느려지고, 문이 넓으면 서류가 빨리 오갑니다. 대역폭이 그 문의 폭입니다. GPU는 대역폭을 크게 높여 수천 개의 코어가 숫자를 기다리며 놀지 않게 합니다.
flowchart TD
    V["VRAM: 큰 작업대 (가중치 + 데이터)"] -->|메모리 대역폭: 문의 폭| C["수천 개의 GPU 코어: 곱셈-덧셈"]
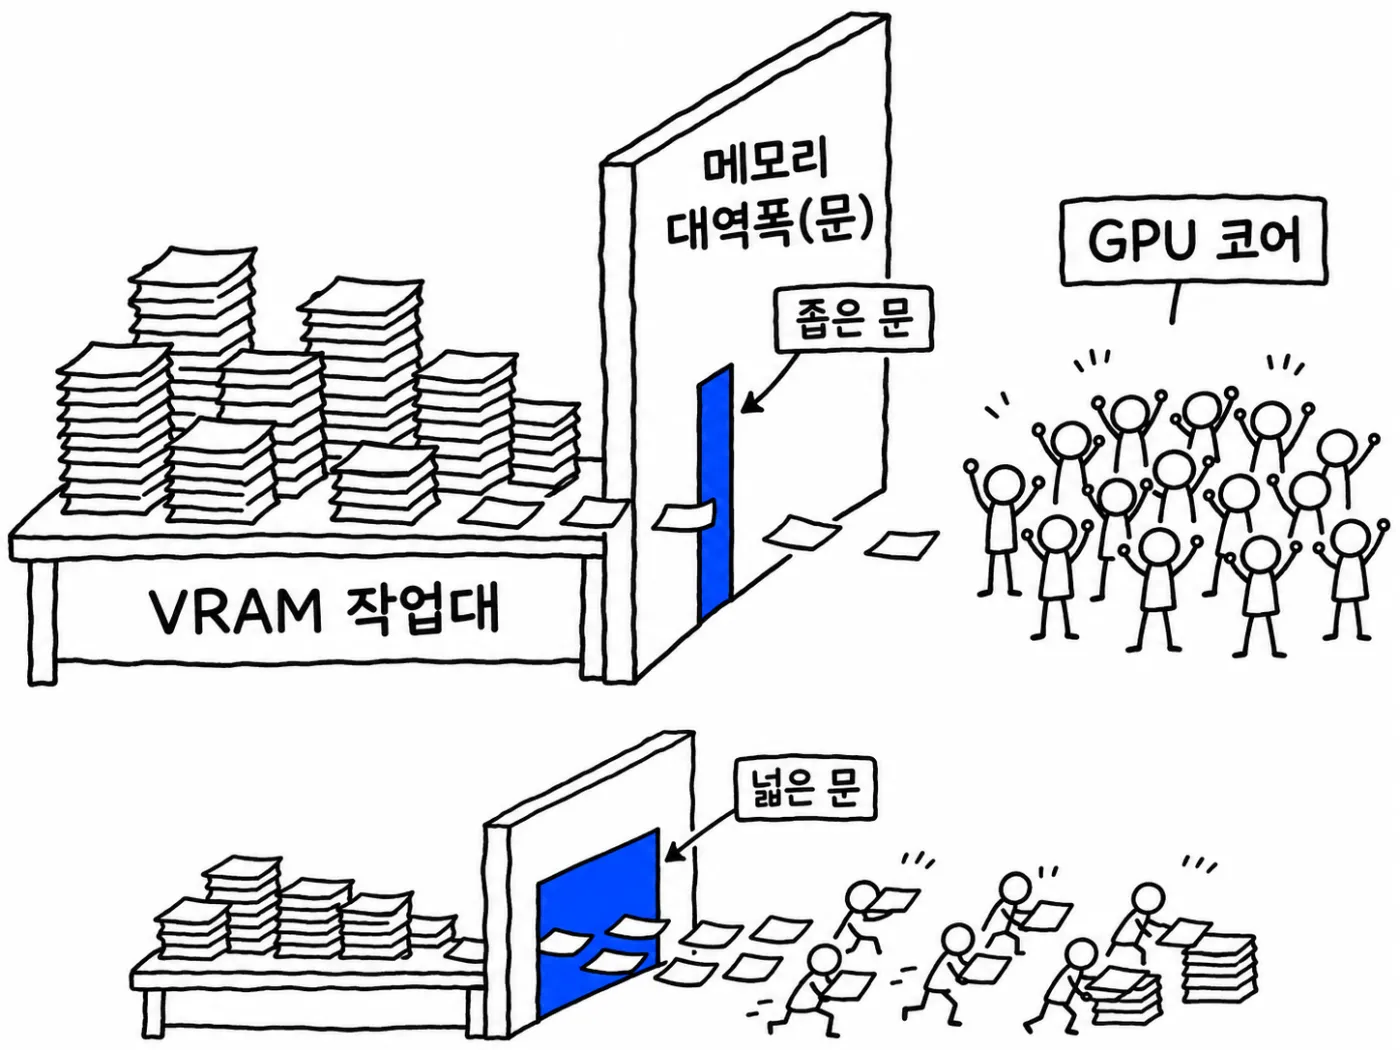
따라서 GPU의 성능은 얼마나 많이 계산할 수 있는가와 그 계산에 숫자를 얼마나 빨리 공급하는가, 두 가지로 정해집니다. 사양서를 볼 때 코어 수나 연산 성능만 비교하지 말고 대역폭도 함께 봅니다. 특히 LLM을 서빙할 때는 숫자 공급 속도가 병목인 경우가 많으므로(12.5.1 참조) 대역폭이 체감 속도를 좌우합니다.
12.2.4 모델이 VRAM에 들어가야 하는 이유
GPU에서 모델을 학습하거나 돌리려면 모델과 데이터가 VRAM 안에 들어가야 합니다. 모델이 작업대보다 크면 펼쳐 놓고 작업할 수 없기 때문입니다. 신경망의 가중치는 하나하나가 숫자이고 숫자마다 메모리 공간을 차지하며, 큰 모델은 수십억 개의 가중치를 가집니다. 원문은 가중치만 담는 데도 수 GB가 필요하고 학습 때는 보조 숫자 때문에 더 필요하다고 설명합니다. 이 크기를 직접 어림해 보면 다음과 같습니다(가중치 70억 개 모델을 가정한 계산 예입니다).
| 정밀도 | 가중치 1개 | 70억 개의 가중치 |
|---|---|---|
| FP32 | 4바이트 | 28GB |
| FP16 | 2바이트 | 14GB |
| INT8 | 1바이트 | 7GB |
GPU를 24GB, 40GB, 80GB 같은 VRAM 용량으로 구분하는 이유가 여기에 있습니다. 같은 모델도 FP32로는 24GB GPU에 들어가지 않지만 FP16이나 INT8로는 들어갑니다. 모델이 한 GPU에 들어가지 않으면 여러 GPU에 나눕니다(12.2.7 참조). 그래서 GPU를 고를 때는 속도만이 아니라 VRAM이 얼마인지, 곧 어느 크기의 모델까지 돌릴 수 있는지를 함께 봅니다.
학습과 추론은 GPU를 쓰는 방식이 다르므로 VRAM 계산도 다릅니다. **학습(training)**은 모델이 배우는 단계로, 데이터를 보여 주고 추측하게 한 뒤 틀린 정도를 재고 가중치를 조정하는 반복입니다. 추측을 위한 순전파 뒤에 가중치를 고치려는 역전파가 더 붙으므로 GPU 성능과 VRAM이 많이 들며 AI 모델을 만드는 데 가장 비싼 부분입니다. **추론(inference)**은 학습된 모델로 답을 얻는 단계로, 챗봇에 질문을 입력하고 답을 받는 것이 예입니다. 순전파만 하고 역전파 갱신은 하지 않으므로 학습보다 가볍습니다.
| 항목 | 학습 | 추론 |
|---|---|---|
| 목적 | 모델을 가르침 | 학습된 모델을 사용함 |
| 계산 | 순전파 + 역전파 | 순전파만 |
| 필요한 GPU 성능 | 높음 | 상대적으로 낮음 |
| 발생 시점 | 모델을 만들 때 한 번 | 사용자가 물을 때마다 |
고객이 보유한 GPU의 VRAM으로 목표 모델이 들어가는지를 가장 먼저 계산하고, 학습이 아닌 추론만 한다면 훨씬 작은 사양으로도 가능합니다.
12.2.5 텐서 코어와 저정밀(FP16·BF16·INT8)
GPU 제조사는 딥러닝을 위해 **텐서 코어(Tensor Core)**를 추가했습니다. 일반 코어가 곱셈-덧셈을 몇 개씩 처리한다면 텐서 코어는 작은 행렬 블록 전체를 한 번에 처리하도록 설계된 전용 유닛입니다. 딥러닝이 대부분 행렬 연산이므로 큰 속도 향상을 줍니다. 속도를 더 높이기 위해 텐서 코어는 저정밀(lower precision) 숫자를 씁니다. 컴퓨터에서 숫자는 자세하게 또는 덜 자세하게 저장할 수 있습니다.
- FP32: 32비트로 저장하는 부동소수점입니다. 정밀도가 높고 정확하지만 공간과 시간이 더 듭니다.
- FP16, BF16: 16비트로 저장합니다. 조금 덜 정확하지만 공간이 절반이고 계산이 빠릅니다. FP는 소수부를 가질 수 있는 부동소수점(floating point) 수이고, BF는 딥러닝용으로 고안된 brain floating point 형식입니다.
- INT8: 8비트의 작은 정수(integer)로 저장합니다. 정밀도는 더 낮지만 더 작고 더 빠릅니다.
덜 정확한데 왜 쓰는가 하는 의문이 생깁니다. 신경망은 은행 계산처럼 정확한 값을 요구하는 것이 아니라 근사적인 패턴 매칭을 하므로, 여기저기서 생기는 작은 반올림은 대체로 최종 답에 의미 있는 영향을 주지 않기 때문입니다. FP16이나 BF16을 쓰면 GPU가 계산을 대략 두 배 빠르게 하고 메모리는 절반만 쓰면서 모델 품질 손실은 거의 없습니다. INT8은 학습이 끝난 모델을 더 가볍고 빠르게 돌리는 추론에 자주 쓰입니다. 학습된 모델의 숫자를 일부러 이 저정밀로 낮추는 일이 양자화(quantization)(10.8 참조)이며, 정확도를 크게 잃지 않는 방법은 별도 주제입니다.
고객에게 정밀도를 낮춰도 되는지 물을 때는 "품질이 얼마나 떨어지면 허용하는가"라는 기준을 먼저 합의하고, 그 기준 안에서 FP16이나 INT8로 VRAM과 비용을 절반 이하로 줄일 수 있는지를 평가 데이터로 확인합니다.
12.2.6 CUDA와 cuDNN 소프트웨어 스택
하드웨어만으로는 GPU를 움직일 수 없고 무엇을 하라고 알려 주는 소프트웨어가 필요합니다. CUDA는 NVIDIA의 소프트웨어 플랫폼으로 프로그래머가 GPU에서 코드를 실행하게 해 줍니다. 일반 코드는 CPU용으로 쓰이고, CUDA는 프로그램이 무거운 계산을 GPU로 보내는 다리 역할을 합니다(12.3 참조). 그 위에 NVIDIA가 만든 **cuDNN(CUDA Deep Neural Network library)**은 행렬 곱셈과 신경망의 구성 요소 같은 딥러닝 연산을 GPU에서 최대한 빠르게 돌도록 다듬어 놓은 라이브러리입니다.
대부분의 사람은 CUDA나 cuDNN을 직접 쓰지 않고 PyTorch나 TensorFlow 같은 딥러닝 프레임워크를 씁니다. 프레임워크는 cuDNN 위에, cuDNN은 CUDA 위에, CUDA는 GPU 위에 놓입니다.
flowchart TD
    A["파이썬 코드 (PyTorch / TensorFlow)"] --> B["cuDNN: 빠른 딥러닝 연산"]
    B --> C["CUDA: GPU로 가는 다리"]
    C --> D["GPU: 계산하는 하드웨어"]
PyTorch에서 작업을 GPU로 옮기는 코드는 짧습니다.
import torch
x = torch.randn(1000, 1000).to("cuda")   # 행렬을 GPU로 보냄
y = torch.randn(1000, 1000).to("cuda")
result = x @ y # 이 곱셈이 GPU에서 실행됨.to("cuda")가 숫자를 GPU로 옮기고, 이후 x @ y는 GPU의 코어와 텐서 코어에서 실행됩니다. 개발자는 간단한 코드를 쓰고 무거운 일은 CUDA와 cuDNN이 아래에서 처리합니다. 완성된 LLM을 하드웨어가 허용하는 최대 속도로 돌리기 위한 계층을 NVIDIA가 이 스택 위에 하나 더 얹고 있기도 합니다.
NVIDIA가 현대 AI의 이름처럼 들리는 이유도 이 스택에 있습니다. 하드웨어 쪽에는 수천 개의 코어, 텐서 코어, 큰 VRAM, 높은 메모리 대역폭, GPU 사이의 빠른 연결(NVLink)이 있습니다. 소프트웨어 쪽에서는 CUDA와 cuDNN이 오랜 세월 신뢰받았고, PyTorch와 TensorFlow가 그 위에서 매끄럽게 동작하도록 만들어졌습니다. 연구자가 쓴 코드가 그대로 NVIDIA GPU에서 돌아가는 이 조합이 NVIDIA를 기본 선택지로 만들었습니다. 다른 회사도 칩을 만듭니다. 구글은 같은 목적의 가속기로 TPU를 만들었고(12.4 참조), 이미 학습된 언어 모델만 돌리는 칩으로 한 걸음 더 나아간 LPU도 있습니다(12.5 참조). 챗봇과 글쓰기 도우미 뒤의 대규모 언어 모델은 수십억 개의 가중치와 수십억 번의 행렬 곱이 필요하며, 학습에 수천 대의 GPU가 몇 주 동안 함께 돌아가기도 합니다.
고객 환경이 NVIDIA 외 가속기라면 쓰는 프레임워크가 그 하드웨어를 지원하는지, 곧 소프트웨어 스택의 성숙도를 먼저 확인합니다.
12.2.7 멀티 GPU
GPU 한 대로 부족한 경우가 있습니다. 모델이 한 GPU의 VRAM에 들어가지 않거나 학습이 너무 무거워 한 대로는 시간이 너무 오래 걸릴 때입니다. 이때 여러 GPU를 함께 쓰며 방식은 두 가지입니다.
| 방식 | 구성 | 효과 |
|---|---|---|
| 데이터 병렬(data parallelism) | 각 GPU에 모델 전체의 사본을 두고 학습 데이터를 조각내어 GPU마다 다른 조각을 줍니다. 각자 동시에 학습한 뒤 배운 것을 공유해 동기를 맞춥니다. | 여러 GPU가 함께 배우므로 학습이 빨라집니다. |
| 모델 병렬(model parallelism) | 모델이 한 GPU에 들어가지 않을 때 모델 자체를 조각내어 GPU마다 다른 부분을 둡니다. 각 GPU는 자기 부분만 실행하고 결과를 서로 넘깁니다. | 한 GPU의 VRAM보다 훨씬 큰 모델을 돌릴 수 있습니다. |
flowchart TD
    D[학습 데이터를 조각으로 분할] --> G1["GPU 1 (모델 전체)"]
    D --> G2["GPU 2 (모델 전체)"]
    D --> G3["GPU 3 (모델 전체)"]
    G1 --> S[공유하고 동기를 맞춤]
    G2 --> S
    G3 --> S
그림 12.3 — 데이터 병렬은 같은 모델 사본을 여러 GPU에 두고 데이터만 나눕니다.
GPU들이 잘 협력하려면 서로 빠르게 통신해야 하며, NVIDIA는 이를 위해 NVLink라는 고속 연결을 만들었습니다. GPU 사이에서 숫자를 빠르게 주고받게 해 속도 저하를 줄입니다. 한 GPU가 감당하지 못하는 큰 모델도 이렇게 여러 대를 묶어서 다룹니다. 고객이 큰 모델을 요구하면 GPU 대수만 묻지 말고, 그 GPU들이 NVLink 같은 고속 연결로 이어져 있는지도 확인합니다. 연결이 느리면 대수를 늘려도 통신이 병목이 됩니다.
12.3 CUDA 커널(CUDA Kernel)
GPU 위의 AI 계산은 결국 CUDA 커널이라는 작은 함수의 반복 실행입니다. 커널의 구조를 알면 고객이 "GPU를 샀는데 왜 빠르지 않은가"라고 물을 때 데이터 복사, 분기, 작업 크기 가운데 어디를 의심할지 알 수 있습니다. 이 절은 2026년 9월 29일 글 기준으로 설명합니다.
GPU가 필요한 이유는 12.2에서 본 대로 단순하고 독립적인 계산이 아주 많기 때문입니다. 감자 1만 개를 깎는 주방으로 비유하면, CPU는 숙련된 요리사 한 명이므로 빠르지만 한 번에 감자 하나만 깎고, GPU는 요리사보다 느린 조수 5,000명으로 구성되어 모두 동시에 깎으므로 1만 개에서는 조수들이 쉽게 이깁니다. 그런데 GPU는 스스로 무엇을 할지 정하지 못하므로 수천 개의 작은 코어에게 할 일을 알려 주는 프로그램이 필요합니다.
**CUDA(Compute Unified Device Architecture)**는 NVIDIA가 만든, GPU에서 도는 프로그램을 쓰게 해 주는 플랫폼입니다. C, C++, Python 같은 언어로 일반 코드처럼 보이는 코드를 쓰고 그것을 수천 개의 GPU 코어에서 동시에 실행하게 해 줍니다. CUDA 이전에는 그래픽이 아닌 계산을 하려면 데이터를 그림인 척 속여서 GPU에 넣어야 했고 번거로웠습니다. CUDA는 "여기 데이터가 있고 이 일을 병렬로 하라"고 GPU에 직접 말하게 해 줍니다. 그 말을 전하는 수단이 **커널(kernel)**입니다.
CUDA 커널은 GPU에서 실행되는 함수이며 많은 스레드가 동시에 실행합니다. **스레드(thread)**는 코드를 실행하는 일꾼 한 명이므로, 커널은 함수이면서 GPU에서 돌고 수천 개의 스레드가 함께 실행하는 것입니다. 핵심은 커널을 스레드 하나를 위한 것처럼 한 번만 쓰면 GPU가 그 커널을 스레드마다 수천 번 병렬로 실행한다는 점입니다. 주방에서 조수 5,000명에게 서로 다른 지시를 5,000개 쓰지 않고 "감자를 집어서 깎아라"라는 지시 하나를 쓰며, 다만 조수마다 집어 드는 감자가 다릅니다.
12.3.1 스레드·블록·그리드
스레드가 수천 개이면 정리할 체계가 필요합니다. CUDA는 세 단계로 조직합니다.
| 단계 | 의미 | 주방 비유 |
|---|---|---|
| 스레드 | 커널 코드를 한 번 실행하는 일꾼 하나 | 조수 한 명 |
| 블록(block) | 스레드의 묶음. 예를 들어 256개. 같은 블록의 스레드끼리는 소통하고 작은 메모리를 공유할 수 있습니다. | 한 테이블에 선 조수 팀 |
| 그리드(grid) | 블록의 묶음. 한 번의 커널 실행을 이루는 모든 블록입니다. | 모든 테이블이 있는 주방 전체 |
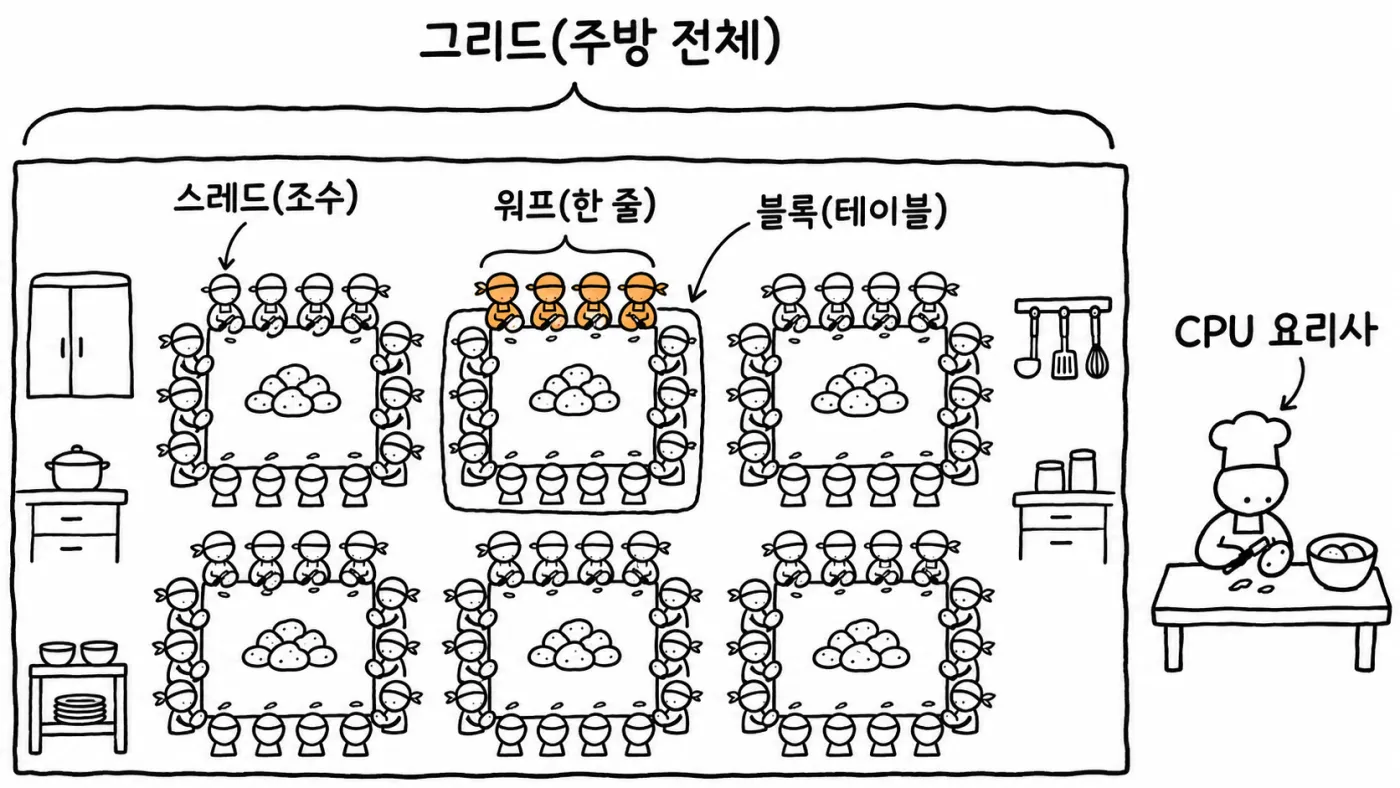
커널을 실행할 때는 블록 수와 블록당 스레드 수 두 가지를 CUDA에 알려 주고, CUDA가 그만큼의 스레드를 만들어 각각 커널을 실행합니다. 블록 하나가 가질 수 있는 스레드 수에는 보통 1,024개라는 상한이 있어서 블록을 여러 개 쓰고, 블록 수에는 실질적인 상한이 없으므로 전체 스레드는 수백만 개가 될 수 있습니다.
GPU 안에서 실제로 일어나는 일도 같은 구조를 따릅니다. GPU는 여러 **스트리밍 멀티프로세서(Streaming Multiprocessor, SM)**로 이루어져 있습니다. SM은 작은 코어를 많이 가진 GPU 내부의 큰 작업 단위이며 최신 GPU에는 100개 이상이 있을 수 있습니다. 블록이 3,907개인 커널을 실행하면 CUDA는 모든 블록을 한꺼번에 돌리지 않고 SM에 분배합니다. 각 SM이 블록 몇 개를 받아 끝내고 다음 블록을 받는 일을 모든 블록이 끝날 때까지 반복합니다. SM 안에서도 스레드는 하나씩 돌지 않고 32개씩 묶이며 이 묶음이 **워프(warp)**입니다. 워프의 32개 스레드는 같은 순간에 같은 명령을 실행하므로 명령 하나를 한 번 가져와 32개 스레드에 함께 적용하는 것이 CUDA가 빠른 이유입니다.
- 주방(GPU)은 여러 구역(SM)으로 나뉘고, 구역마다 몇 개의 테이블(블록)을 맡습니다.
- 테이블의 조수(스레드)는 32명씩 줄(워프)을 서고, 테이블 책임자가 "깎아라"라고 말하면 줄의 32명이 함께 합니다.
- 워프 다이버전스(warp divergence): 워프의 32개 스레드가 같은 명령을 실행해야 하므로 커널에
if조건이 있어 일부는 한쪽, 일부는 다른 쪽으로 가면 워프가 두 경로를 차례로 실행해야 하고 그만큼 느려집니다. 그래서 좋은 CUDA 커널은 스레드가 가능한 한 같은 일을 하게 만듭니다. - 뒤에 나오는
if (i < n)검사는 맨 마지막 블록에서만 다이버전스를 일으키므로 실제로는 문제가 되지 않습니다.
고객의 커널이 분기가 많은 로직이라면 GPU에서 이득이 줄어드는 이유가 이 워프 단위 실행에 있습니다.
12.3.2 호스트와 디바이스
CUDA에서는 두 낱말이 어디에나 나옵니다. **호스트(host)**는 CPU와 그 메모리(RAM)이고, **디바이스(device)**는 GPU와 그 전용 메모리(VRAM)입니다. 둘의 메모리는 분리되어 있어서, 이해를 위해 CPU가 GPU 메모리를, GPU가 CPU 메모리를 직접 읽지 못한다고 가정합니다. GPU에 일을 시키려면 데이터를 호스트에서 디바이스로 복사하고, 일이 끝나면 결과를 디바이스에서 호스트로 되돌려 복사해야 합니다. CUDA 프로그램은 항상 다음 여섯 단계를 따릅니다.
| 단계 | 내용 |
|---|---|
| 1 | 호스트(CPU)에서 데이터를 준비합니다. |
| 2 | 디바이스(GPU)에 메모리를 할당합니다. 할당은 데이터를 위한 공간을 예약한다는 뜻입니다. |
| 3 | 데이터를 호스트에서 디바이스로 복사합니다. |
| 4 | 디바이스에서 커널을 실행합니다. |
| 5 | 결과를 디바이스에서 호스트로 복사합니다. |
| 6 | 디바이스 메모리를 해제합니다. 예약한 공간을 돌려줍니다. |
주방 비유로는, 요리사(CPU)가 창고의 감자를 조수들(GPU)이 일하는 다른 방으로 날라 주고 깎은 감자를 다시 날라 오는 것입니다. 나르는 데 시간이 들며, 이 비용 때문에 작은 작업은 GPU에서 이득이 없습니다(12.3.6 참조).
고객 코드에서 CPU와 GPU 사이 복사가 반복되고 있다면, 계산 시간보다 복사 시간이 느린 원인일 수 있으므로 복사 횟수부터 확인합니다.
12.3.3 첫 CUDA 커널 작성
각각 100만 개의 숫자를 담은 두 리스트 a와 b를 더해 세 번째 리스트 c에 담는다고 합시다. 모든 위치 i에서 c[i] = a[i] + b[i]입니다. CPU에서는 반복문 하나로 처리합니다.
void add(int n, float *a, float *b, float *c) {
    for (int i = 0; i < n; i++) {
        c[i] = a[i] + b[i];
    }
}
반복문이 100만 번 차례로 돌며, 요리사 한 명이 감자 하나씩 깎는 방식입니다. 같은 일을 CUDA 커널로 쓰면 다음과 같습니다.
__global__ void add(int n, float *a, float *b, float *c) {
    int i = blockIdx.x * blockDim.x + threadIdx.x;
    if (i < n) {
        c[i] = a[i] + b[i];
    }
}__global__은 이 함수가 커널이라는 표시입니다. 호스트(CPU)에서 호출되고 디바이스(GPU)에서 실행됩니다.- 반복문이 사라졌습니다. 스레드 하나가
i하나만 맡고, GPU가 이 함수를 스레드마다 100만 번 병렬로 실행합니다. int i = blockIdx.x * blockDim.x + threadIdx.x;는 각 스레드가 자신이 맡을i를 알아내는 식입니다(12.3.4 참조).if (i < n)은 안전 검사입니다. 항목 수보다 스레드를 조금 더 띄우는 경우가 있어서 남는 스레드가 아무것도 하지 않게 합니다.
호스트에서 커널을 실행하는 코드는 다음과 같습니다.
int n = 1000000;
int threadsPerBlock = 256;
int blocks = (n + threadsPerBlock - 1) / threadsPerBlock;

add<<<blocks, threadsPerBlock>>>(n, d_a, d_b, d_c);
blocks 식은 올림을 하는 요령입니다. 100만 개의 숫자와 블록당 256개 스레드에서는 3,907개 블록이 나오고, 3,907 x 256은 1,000,192개 스레드이므로 100만보다 192개 많습니다. 그래서 커널 안에 if (i < n) 검사가 필요합니다. <<<blocks, threadsPerBlock>>>는 "이 함수를 이 블록 수와 블록당 스레드 수로 실행하라"는 CUDA 전용 문법이고, d_a, d_b, d_c는 디바이스 메모리에 있는 데이터의 주소입니다(d_ 접두사는 device를 뜻하는 관례입니다). 앞의 여섯 단계를 모두 넣은 전체 흐름은 다음과 같습니다.
float *d_a, *d_b, *d_c;                                 // 2. 디바이스 메모리 할당
cudaMalloc(&d_a, n * sizeof(float));
cudaMalloc(&d_b, n * sizeof(float));
cudaMalloc(&d_c, n * sizeof(float));
cudaMemcpy(d_a, a, n * sizeof(float), cudaMemcpyHostToDevice);  // 3. 호스트 -> 디바이스
cudaMemcpy(d_b, b, n * sizeof(float), cudaMemcpyHostToDevice);
add<<<blocks, threadsPerBlock>>>(n, d_a, d_b, d_c);     // 4. 커널 실행
cudaMemcpy(c, d_c, n * sizeof(float), cudaMemcpyDeviceToHost);  // 5. 디바이스 -> 호스트
cudaFree(d_a); cudaFree(d_b); cudaFree(d_c); // 6. 해제cudaMalloc은 GPU 메모리에 공간을 예약합니다.cudaMemcpy는 호스트와 디바이스 사이에서 복사하며 마지막 인자가cudaMemcpyHostToDevice인지cudaMemcpyDeviceToHost인지로 방향을 정합니다.cudaFree는 작업이 끝난 GPU 메모리를 돌려줍니다.- CUDA 코드는
.cu확장자 파일에 저장하고 NVIDIA의nvcc로 컴파일합니다.nvcc는 호스트용 C++ 코드와 디바이스용 커널 코드를 모두 이해합니다.
100만 번의 덧셈이 GPU에서 병렬로 끝납니다. 고객 팀이 CUDA 코드를 직접 쓴다고 하면 이 여섯 단계 중 어디서 복사와 해제가 빠졌는지, 특히 해제를 빠뜨려 메모리가 새는 곳이 없는지를 먼저 점검합니다.
12.3.4 스레드가 자기 일을 찾는 법
모든 스레드가 똑같은 코드를 실행하는데 어떻게 각자 다른 숫자를 더할까요? CUDA가 모든 스레드에게 자신의 위치를 알려 주는 내장 변수를 주기 때문입니다. 인덱스는 0에서 시작하는 위치 번호입니다.
threadIdx.x: 블록 안에서 스레드의 인덱스입니다. 블록에 256개 스레드가 있으면 0부터 255까지입니다.blockIdx.x: 그리드 안에서 블록의 인덱스입니다. 블록이 3,907개이면 0부터 3,906까지입니다.blockDim.x: 블록당 스레드 수로, 이 예에서는 256입니다.
전역 인덱스는 i = (블록 번호) x (블록당 스레드 수) + (블록 안의 스레드 번호)로 계산합니다.
| 스레드 위치 | 계산 | i |
|---|---|---|
| 블록 0의 스레드 0 | 0 x 256 + 0 | 0 |
| 블록 0의 스레드 5 | 0 x 256 + 5 | 5 |
| 블록 1의 스레드 0 | 1 x 256 + 0 | 256 |
| 블록 2의 스레드 10 | 2 x 256 + 10 | 522 |
모든 스레드가 고유한 i를 받고 같은 i를 받는 스레드는 없습니다. 같은 코드가 수천 개 스레드에서 서로 다른 데이터를 처리하는 방법이 이것입니다. 주방 비유로는 조수마다 테이블 번호(blockIdx)와 그 테이블의 좌석 번호(threadIdx)가 있고, 테이블마다 좌석이 256개(blockDim)이므로 2번 테이블 10번 좌석의 조수는 누구에게 묻지 않고도 522번 감자를 집어야 한다는 것을 계산해 냅니다.
지금까지 모든 곳에 .x를 썼는데, CUDA는 스레드와 블록을 1차원(선), 2차원(종이 위의 격자), 3차원(정육면체)으로 배열할 수 있기 때문입니다. 단순한 리스트에는 1차원이면 충분하고 이미지나 행렬에는 2차원이 자연스러워서 .y도 쓰며, 원리는 같습니다. 인덱스 식에서 가장 흔한 실수는 블록 수를 내림하는 것이므로, 원소가 남지 않는지 올림 식과 if (i < n) 검사를 함께 확인합니다.
12.3.5 CUDA 메모리 종류
호스트와 디바이스의 메모리가 분리되어 있음은 보았고, 성능의 대부분은 디바이스 메모리 안에서 나옵니다. GPU에는 세 가지 주요 메모리가 있습니다.
| 메모리 | 특징 | 비유 |
|---|---|---|
| 전역 메모리(Global Memory) | GPU의 큰 메모리(VRAM, 24GB나 80GB 등)입니다. 모든 스레드가 읽고 쓸 수 있으며 d_a, d_b, d_c가 여기 있습니다. 크지만 코어에서 멀어 느립니다. |
창고 |
| 공유 메모리(Shared Memory) | 각 SM 안의 작지만 빠른 메모리입니다. 같은 블록의 스레드만 쓸 수 있습니다. | 테이블마다 있는 화이트보드 |
| 레지스터(Register) | 가장 빠른 메모리이며 스레드마다 자기 것이 있습니다. 변수 i가 여기 있습니다. |
조수가 손에 든 메모장 |
원문은 전역 메모리가 공유 메모리보다 약 100배 느리다고 설명합니다. 이는 어림값이며 실제 배수는 GPU 세대와 접근 방식에 따라 달라집니다. 그래서 흔한 요령은 전역 메모리의 한 덩어리를 공유 메모리로 한 번 불러온 뒤 블록의 모든 스레드가 공유 메모리에서 여러 번 작업하고 결과를 전역 메모리에 쓰는 것입니다. 앞의 덧셈 예제는 숫자를 한 번씩만 쓰므로 공유 메모리가 도움이 되지 않습니다. 그러나 같은 숫자를 반복해서 쓰는 행렬 곱셈에서는 이 요령이 큰 차이를 만듭니다. LLM의 어텐션을 크게 빠르게 만든 Flash Attention이 정확히 이 요령을 쓰는 사례입니다.
같은 데이터를 여러 번 다시 읽는 연산인지, 한 번 읽고 끝나는 연산인지에 따라 공유 메모리 최적화의 효과가 갈린다는 점이 고객과 성능 문제를 진단할 때의 첫 질문이 됩니다.
12.3.6 AI에서 CUDA 커널이 중요한 이유
LLM 같은 AI 모델은 가중치라는 아주 큰 숫자 묶음이며, 입력을 가중치와 곱하고 더하고 간단한 수학 함수를 적용하는 일을 여러 층에 걸쳐 반복합니다. 모델 안의 거의 모든 것이 행렬 곱셈, 곧 큰 숫자 표를 곱하고 더하는 일입니다. 수백만 개의 숫자로 된 행렬 곱셈은 모든 출력 숫자를 독립적으로 계산할 수 있어 감자 깎기에 꼭 맞는 문제이므로, 행렬 곱셈 커널 하나를 쓰고 수백만 개의 스레드로 실행합니다.
PyTorch에서 torch.matmul(a, b)를 쓸 때 직접 CUDA 코드를 쓰는 것은 아니지만 뒤에서는 NVIDIA가 쓴 고도로 최적화된 CUDA 커널이 호출됩니다. 이 커널들은 수학 연산용 기성 커널 모음인 cuBLAS 같은 NVIDIA 라이브러리에서 오며, 같은 원리에 속도를 위한 요령을 훨씬 많이 더했습니다. LLM이 단어 하나를 생성할 때마다 GPU에서는 수천 개의 CUDA 커널이 차례로 실행되고, 큰 행렬 곱이든 작은 수학 함수든 모델 안의 모든 단계가 커널입니다. NVIDIA는 이 커널들을 융합하고 조율해 LLM을 최대한 빠르게 돌리는 도구도 만들어 두었습니다.
CUDA 커널이 잘 맞는 경우와 그렇지 않은 경우를 구분하면 고객 문제에 GPU를 권해도 되는지 판단할 수 있습니다.
| 구분 | 상황 | 이유 |
|---|---|---|
| 잘 맞음 | 많은 데이터에 같은 연산을 합니다(행렬 곱, 이미지 처리, 과학 시뮬레이션). | 병렬화 이득이 큽니다. |
| 잘 맞음 | 데이터 조각끼리 계산이 서로 의존하지 않습니다. | 모든 스레드가 동시에 진행합니다. |
| 잘 맞음 | 작업량이 커서 절약한 시간이 호스트-디바이스 복사 시간보다 큽니다. | 복사 비용을 상쇄합니다. |
| 부적합 | 작업이 작습니다. 숫자 10개를 GPU로 보냈다 받는 시간이 CPU에서 더하는 시간보다 깁니다. | 감자 10개 때문에 다른 방으로 나르는 격입니다. |
| 부적합 | 작업이 순차적입니다. 2단계가 1단계의 결과를, 3단계가 2단계의 결과를 필요로 합니다. | 한 번에 스레드 하나만 일할 수 있습니다. |
| 부적합 | 스레드가 서로 다른 경로를 계속 탑니다. | 워프 다이버전스로 GPU가 하나씩 처리하게 됩니다. |
| 부적합 | 데이터가 GPU 메모리보다 큽니다. | 데이터를 계속 넣고 빼야 하므로 복사가 병목이 됩니다. |
| 항목 | CPU | GPU |
|---|---|---|
| 코어 | 소수의 강력한 코어(4~64개) | 수천 개의 작은 코어 |
| 잘하는 일 | 한 작업 뒤에 다른 작업을 차례로 | 많은 데이터에 같은 작업을 한꺼번에 |
| 적합한 용도 | 로직, 판단, 운영체제 실행 | 큰 숫자 리스트와 표에 대한 수학, 그래픽, AI |
| 데이터 복사 | 필요 없음, 데이터가 RAM에 있음 | GPU로 보내고 되받아야 함 |
CPU와 GPU 중 무엇을 쓸지는 사용 사례로 정합니다. 고객이 작은 입력을 하나씩 처리하는 파이프라인에 GPU를 붙이려 한다면 복사 비용이 이득을 넘지 않는지부터 따져 봅니다.
12.4 구글 TPU
원문: How does a Google TPU work?
TPU는 GPU와 다른 방식으로 같은 행렬 곱셈을 빠르게 만든 칩이며, 고객이 구글 클라우드의 가속기를 선택지로 올릴 때 GPU와 무엇이 같고 다른지 설명할 수 있어야 합니다. 이 절은 2026년 6월 28일 글 기준으로 TPU의 이름과 탄생 배경, 핵심 구조인 시스톨릭 어레이, 데이터의 흐름, 효율의 근거, 한계를 차례로 설명합니다.
TPU는 구글이 만든 머신러닝 전용 칩이며 정식 이름은 Tensor Processing Unit입니다. 이름은 Tensor, Processing, Unit의 합으로 읽습니다. **텐서(tensor)**는 숫자의 격자를 가리키는 말입니다. 숫자 하나도, 숫자 목록도, 행과 열이 있는 숫자 표도 텐서입니다. 따라서 TPU는 숫자 격자를 받아 새 숫자 격자를 빠르게 돌려주는 칩입니다.
12.4.1 구글이 TPU를 만든 이유
문제를 먼저 이해하면 해법이 자연스럽습니다. 원문에 따르면 2013년 무렵 구글은 음성 검색, 사진 검색, 번역 사용이 빠르게 늘어나는 것을 보고 걱정했습니다. 이 서비스들이 모두 머신러닝을 쓰기 때문입니다. 계산해 보니 모든 사용자가 하루에 몇 분만 음성 검색을 써도 데이터센터의 컴퓨터 수를 두 배로 늘려야 했고 비용이 막대했습니다. 일반 칩은 여러 가지 일을 적당히 잘하도록 만들어졌지만, 머신러닝은 한 종류의 계산을 수십억 번 해야 하므로 맞지 않았습니다. 그래서 구글은 머신러닝 계산 하나만을 위한 새 칩을 처음부터 설계했습니다.
TPU의 위치를 이해하려면 다른 두 칩을 간단히 되짚으면 됩니다.
| 칩 | 비유 | 특징 | 한계 |
|---|---|---|---|
| CPU | 영리한 일꾼 한 명 | 거의 모든 작업을 할 수 있지만 한두 가지씩 처리합니다. | 같은 단순 작업을 수십억 번 해야 할 때는 약합니다. |
| GPU | 작은 일꾼 수천 명 | 작은 작업 여러 개를 병렬로 처리해 머신러닝에 인기를 얻었습니다(12.2 참조). | 여전히 여러 종류의 작업을 하도록 유연하게 만들어져 있어 그 유연성이 속도와 전력의 비용이 됩니다. |
| TPU | 한 가지 일에 특화된 공장 | 유연성을 일부 포기하는 대신 머신러닝에서 더 빠르고 전력 효율이 좋습니다. | 범용 작업에는 쓰지 못합니다. |
질문은 "유연성을 포기하는 대가로 머신러닝에서 더 빠르고 전력 효율이 높은 칩을 만들 수 있는가"였고, 그 답이 TPU입니다. 고객이 가속기를 고를 때 워크로드가 머신러닝 행렬 연산에 집중되어 있는지, 아니면 다양한 종류의 작업을 섞어 쓰는지를 먼저 확인하면 TPU와 GPU 중 어디에 무게를 둘지 방향이 잡힙니다.
12.4.2 시스톨릭 어레이(Systolic Array)
TPU를 이해하려면 머신러닝이 반복하는 연산 하나를 알아야 합니다. 그 연산이 행렬 곱셈, 곧 숫자 표 두 개를 결합해 새 표를 만드는 일입니다. 기본 단계는 입력 각각에 대응하는 가중치(weight), 곧 학습으로 정해진 중요도 숫자를 곱한 뒤 모두 더하는 것입니다. 입력이 2, 3, 4이고 가중치가 5, 6, 7이라면 다음과 같습니다.
(2 x 5) + (3 x 6) + (4 x 7) = 10 + 18 + 28 = 56모든 일이 "곱한 뒤 더하기"의 반복이며, 두 수를 곱해 누적 합계에 계속 더해 간다고 해서 **곱셈-누적(multiply-and-accumulate)**이라 부릅니다. 신경망은 이 단계를 수십억 번 합니다. 곱셈-누적을 극도로 빠르게 하는 칩을 만들면 이기는 것이고, TPU가 바로 그 목적입니다.
TPU의 중심은 **행렬 곱셈 유닛(Matrix Multiply Unit, MXU)**이고 그 안에 **시스톨릭 어레이(Systolic Array)**라는 구조가 있습니다. "시스톨릭"은 심장이 피를 밀어내는 수축기(systole)에서 온 말로, 심장 박동이 피를 내보내듯 데이터가 칩 안을 일정한 리듬의 맥동으로 흘러가기 때문에 붙은 이름입니다. 시스톨릭 어레이는 행과 열로 놓인 작은 계산기의 큰 격자이며, 각 계산기는 두 수를 곱해 누적 합계에 더하는 한 가지 일만 합니다. 격자가 가로 128개, 세로 128개(세대에 따라 격자 크기는 다르며 이는 예시입니다)이면 128 x 128 = 16,384개의 작은 계산기가 한 칩에 모여 있습니다.
영리한 부분은 결과를 다루는 방식입니다. 일반 칩은 계산마다 결과를 메모리로 보내고 다음 숫자를 메모리에서 가져오는데, 메모리를 반복해서 오가는 것은 느리고 전력을 많이 씁니다. 시스톨릭 어레이에서는 계산기들이 결과를 이웃에게 직접 넘겨서 숫자가 계단을 따라 흐르는 물처럼 한 계산기에서 다음 계산기로 흐릅니다. 데이터가 메모리로 계속 되돌아가지 않고 격자를 따라 앞으로만 나아가는 것이 비결입니다. TPU는 메모리와 대화하는 데 시간을 낭비하는 대신 데이터를 계속 움직이고 계산기를 계속 바쁘게 둡니다.
고객이 "TPU는 왜 효율이 좋은가"라고 물으면 계산기를 늘린 것보다 메모리 왕복을 줄인 구조라는 점을 답의 중심에 둡니다(12.4.4 참조).
12.4.3 데이터 흐름
격자 안의 흐름은 다음과 같습니다. 가중치는 먼저 격자에 올려져 계산기마다 하나씩 그 자리에 머뭅니다. 입력 숫자는 왼쪽에서 들어와 오른쪽으로 한 걸음씩 계산기를 건너 흐르고, 동시에 누적 합계는 위에서 아래로 흐릅니다. 그래서 각 계산기에서 정확한 순간에 세 가지가 만납니다.
- 왼쪽에서 오는 입력 숫자
- 계산기 안에 이미 놓인 가중치
- 위에서 내려오는 누적 합계
계산기는 입력에 가중치를 곱해 누적 합계에 더하고 새 합계를 아래 계산기에 넘깁니다. 합계가 격자 맨 아래에 도달할 때쯤이면 행렬 곱셈 전체가 끝나 있으며, 답이 아래로 쏟아져 나옵니다.
flowchart TD
    I1[입력: 왼쪽에서 진입] --> C11
    I2[입력] --> C21
    T[누적 합계: 위에서 아래로] --> C11
    subgraph 격자["시스톨릭 어레이: 각 C는 가중치 하나를 가진 계산기"]
    C11["C"] --> C12["C"]
    C21["C"] --> C22["C"]
    C11 --> C21
    C12 --> C22
    end
    C22 --> O[완성된 합계가 아래로 나옴]
그림 12.4 — 입력은 오른쪽으로, 합계는 아래로 흐르며 각 계산기에서 만나 곱하고 더합니다. 일반 칩이 여러 번의 느린 별개 단계로 하는 일을 매끄러운 한 번의 파동으로 처리합니다.
TPU에서 계산 하나가 처음부터 끝까지 가는 여정은 여덟 단계입니다.
| 단계 | 내용 |
|---|---|
| 1 | 모델과 데이터를 호스트 컴퓨터에서 준비합니다. 호스트는 TPU를 제어하고 일을 먹여 주는 일반 컴퓨터입니다. |
| 2 | 가중치와 입력을 TPU의 전용 고속 메모리로 복사합니다. 이 메모리는 계산기 가까이에 있어 데이터가 멀리 가지 않으므로 시간과 전력이 절약됩니다. |
| 3 | 가중치를 시스톨릭 어레이에 올립니다. 계산기마다 자기 가중치를 쥐고 대기합니다. |
| 4 | 입력 숫자가 왼쪽에서 심장 박동처럼 맥동하며 격자에 들어옵니다. |
| 5 | 격자 안에서 모든 계산기가 곱셈-누적을 하고 결과를 이웃에게 넘깁니다. 수천 개가 동시에 일어납니다. |
| 6 | 완성된 합계가 격자 아래로 나옵니다. |
| 7 | 합계는 흔히 활성화(activation) 단계를 거칩니다. 활성화는 각 결과의 강도를 정하는 간단한 규칙으로, 예를 들어 음수를 0으로 바꿉니다. 신경망이 복잡한 패턴을 배우게 돕습니다. |
| 8 | 결과를 저장하고 이것이 신경망 다음 층의 입력이 됩니다. 이 순환이 층마다 반복되어 모델이 최종 답을 낼 때까지 이어집니다. |
데이터는 호스트 컴퓨터에서 격자를 거쳐 결과로 나오는 한 방향으로, 층마다 흐릅니다. 사진에서 고양이를 알아보는 예측 한 건도 이렇게 TPU를 통과합니다. TPU는 호스트 없이 혼자 동작하지 않으므로, 고객 시스템 설계에서 호스트가 데이터를 TPU 메모리로 먹이는 속도도 병목 후보로 확인합니다.
12.4.4 속도와 전력 효율
설계를 이해하면 빠른 이유가 네 가지로 보입니다.
- 한 가지 일을 극단적으로 잘합니다. TPU는 CPU처럼 유연하려 하지 않고 행렬 곱셈에 맞춰 만들어졌습니다. 유연성을 포기하는 대신 속도를 얻습니다.
- 수천 개의 계산기가 함께 일합니다. 격자 안의 수만 개의 작은 계산기가 같은 순간에 방대한 양의 수학을 처리합니다. 128 x 128 격자 하나만 해도 16,384개입니다.
- 메모리와의 대화가 적습니다. 가장 큰 이유입니다. 일반 칩에서는 메모리를 오가는 데 시간과 전력의 대부분이 쓰이는데, 시스톨릭 어레이는 이웃 사이에서 데이터를 움직여 대부분의 느린 메모리 왕복을 피합니다.
- 더 단순한 숫자 연산을 씁니다. 많은 머신러닝 작업은 높은 정밀도의 숫자가 필요하지 않습니다. TPU는 더 작고 단순한 숫자를 써서 계산마다 에너지를 덜 쓰고 더 빨리 끝내며, 같은 칩에 계산기를 더 많이 넣을 수 있습니다(12.2.5 참조).
이 네 가지가 합쳐져 TPU는 일반 칩보다 초당 훨씬 많은 머신러닝 계산을 하면서 전기는 훨씬 적게 씁니다. 구글이 새 데이터센터를 산더미처럼 짓지 않고도 수십억 명을 위해 큰 모델을 돌릴 수 있는 이유가 이것입니다. 고객과 비용을 논의할 때는 처리 성능만이 아니라 같은 일을 하는 데 드는 전력, 곧 운영비도 비교 항목에 넣습니다.
12.4.5 용도와 한계
TPU는 구글의 일상 제품 여럿을 움직입니다.
- 검색: 사용자가 실제로 묻는 것을 이해합니다.
- 구글 번역: 한 언어의 텍스트를 다른 언어로 바꿉니다.
- 구글 포토: 사진 속 얼굴, 장소, 사물을 알아봅니다.
- 음성 비서: 말한 단어를 이해합니다.
대규모 언어 모델을 포함한 큰 모델을 학습하는 데도 쓰입니다. **구글 클라우드(Google Cloud)**를 통하면 다른 기업이 하드웨어를 사지 않고 TPU를 빌려 자기 머신러닝 모델을 학습하고 돌릴 수 있습니다. 작은 사촌인 Edge TPU도 있으며, 카메라나 센서 같은 작은 기기 안에서 돌도록 만든 아주 작은 TPU라서 데이터를 데이터센터로 보내지 않고 현장에서 머신러닝을 합니다(12.6 참조).
한계도 분명합니다. TPU는 주로 행렬 곱셈에 맞춘 머신러닝 칩이므로 범용 칩이 아닙니다. 일반 프로그램을 돌리거나 웹을 탐색하거나 평범한 게임을 하는 데는 쓰지 못하고, 그런 일상 작업에는 여전히 CPU가 필요합니다. 비슷한 계산을 대량으로 함께 할 때 가장 잘 동작하므로 작거나 불규칙한 작업은 CPU나 GPU가 더 낫기도 합니다.
| 구분 | 내용 |
|---|---|
| 얻는 것 | 한 종류의 일, 곧 머신러닝 수학에서 속도와 전력 효율 |
| 포기하는 것 | 유연성. 범용 프로그램과 작거나 불규칙한 작업 |
| 접근 방법 | 구글 제품 내부 사용, 구글 클라우드에서 대여, 소형 기기용 Edge TPU |
TPU를 권하려면 고객의 워크로드가 큰 행렬 연산에 집중되어 있고 구글 클라우드 이용이 가능한지를 확인하고, 그렇지 않다면 CPU나 GPU가 더 맞는 선택일 수 있다고 안내합니다. 이 특화를 더 밀어붙여 학습을 아예 버린 칩이 LPU입니다(12.5 참조).
12.5 LPU
LPU는 "연산이 병목이 아니라 메모리 이동이 병목"이라는 관찰 하나에서 출발한 칩이며, 이 논리를 이해하면 LLM의 응답 속도를 높이라는 고객 요구를 하드웨어 교체로 풀지 소프트웨어로 풀지 가를 수 있습니다. 이 절은 2026년 9월 3일 글 기준으로 설명하며, 속도와 칩 사양 수치는 글이 개념을 보이려고 든 어림값입니다.
**LPU(Language Processing Unit)**는 이미 학습된 대규모 언어 모델을 돌려 텍스트를 가능한 한 빠르게 만들어 내는 한 가지 일만을 위해 설계된 칩입니다. 언어 모델이 텍스트를 쓰는 방식에 맞춰 설계되었고 그 외에는 고려하지 않았습니다. 기존 칩과 견주면 다음과 같습니다.
| 칩 | 성격 | 설명 |
|---|---|---|
| CPU | 범용 일꾼 | 거의 모든 일을 하지만 한 번에 몇 가지만 처리합니다. |
| GPU | 거대한 팀 | 그래픽용으로 만들어졌고 머신러닝이 요구하는 무거운 병렬 연산에도 뛰어나다는 것이 나중에 알려졌습니다(12.2 참조). |
| TPU | 머신러닝 특화 칩 | 구글이 같은 특화 경로를 택한 칩입니다(12.4 참조). |
| LPU | 전문가 | 이미 학습된 언어 모델을 돌리는 일에만 만들어졌습니다. |
두 단어가 중요한데, "이미 학습된"입니다. LPU는 학습이 끝난 모델을 쓰는 **추론(inference)**용이고 모델을 학습시키는 용도가 아닙니다. LPU라는 용어는 이 칩을 만드는 Groq라는 회사가 도입했지만, 그 뒤의 아이디어는 일반적입니다. GPU가 이미 아주 강력한데 왜 새 칩이 필요한지는, 언어 모델이 텍스트를 쓸 때 실제로 무엇을 하는지부터 이해하면 설계가 자연스럽게 보입니다.
12.5.1 병목은 연산이 아니라 메모리
언어 모델은 답 전체를 한 번에 쓰지 않고 토큰(token), 곧 단어 전체이거나 단어의 일부인 작은 텍스트 조각을 하나씩 씁니다. "The capital of France is"라고 물으면 모델은 이 문장을 읽어 토큰 "Paris"를 내고, "The capital of France is Paris"를 읽어 다음 토큰 "."을 내며, "The capital of France is Paris."를 읽고 답이 끝났다고 판단합니다. 이 반복을 의사 코드로 쓰면 다음과 같습니다.
input = "The capital of France is"
loop:
    모델 전체를 읽는다
    다음 토큰을 계산한다
    그 토큰을 입력에 붙인다
    답이 끝났다는 토큰이면 중단한다
중요한 점은 모든 토큰이 앞 토큰을 기다린다는 것입니다. 5번 토큰은 4번 토큰이 입력의 일부이므로 4번 토큰 없이 계산할 수 없습니다. 텍스트 생성은 사슬이고, 사슬은 일꾼을 늘려서가 아니라 사슬의 고리 하나하나를 더 빨리 끝내야만 빨라집니다. 이 한 문장이 LPU 설계의 거의 전부를 설명합니다.
한 고리 안에서 시간이 걸리는 부분은 메모리입니다. 언어 모델은 아주 큰 숫자 더미이고, 이 숫자를 가중치(weight) 또는 파라미터라고 부릅니다. "70B 모델"은 700억 개의 숫자를 가진 모델입니다. 각 숫자를 8비트, 곧 1바이트로 저장하면 700억 개는 약 70GB입니다(숫자당 비트를 줄이면 이 더미가 그대로 줄어드는데, 이것이 양자화입니다. 12.2.5 참조).
토큰 하나를 만들려면 칩이 모델의 가중치를 처음부터 끝까지 전부 읽어야 합니다. 그런데 읽은 가중치로 하는 일은 어떤 숫자와 곱해서 더하는 것, 곧 곱셈 한 번과 덧셈 한 번이 전부입니다. 메모리에서 칩으로 옮기는 숫자에 비해 계산은 거의 하지 않으므로, 칩은 계산을 마치고 다음 숫자 묶음이 오기를 놀면서 기다립니다.
비유하면 요리사는 몇 초 만에 어떤 요리든 만들 수 있을 만큼 빠르지만, 레시피 책이 길 건너 창고에 있습니다. 요리 한 접시마다 창고에 가서 책을 모두 들고 와 각 책에서 한 줄씩 읽고 요리합니다. 요리는 몇 초, 걷기는 몇 분이 걸립니다. 요리사를 더 빠르게 만들어도 소용이 없으니 문제는 요리사가 아니라 책까지의 거리입니다. 언어 모델을 돌리는 칩 안에서 일어나는 일이 이것이며, 병목은 가중치의 이동입니다. 이런 작업을 **메모리 바운드(memory bound)**라 하고, 연산이 병목인 **컴퓨트 바운드(compute bound)**와 구분합니다.
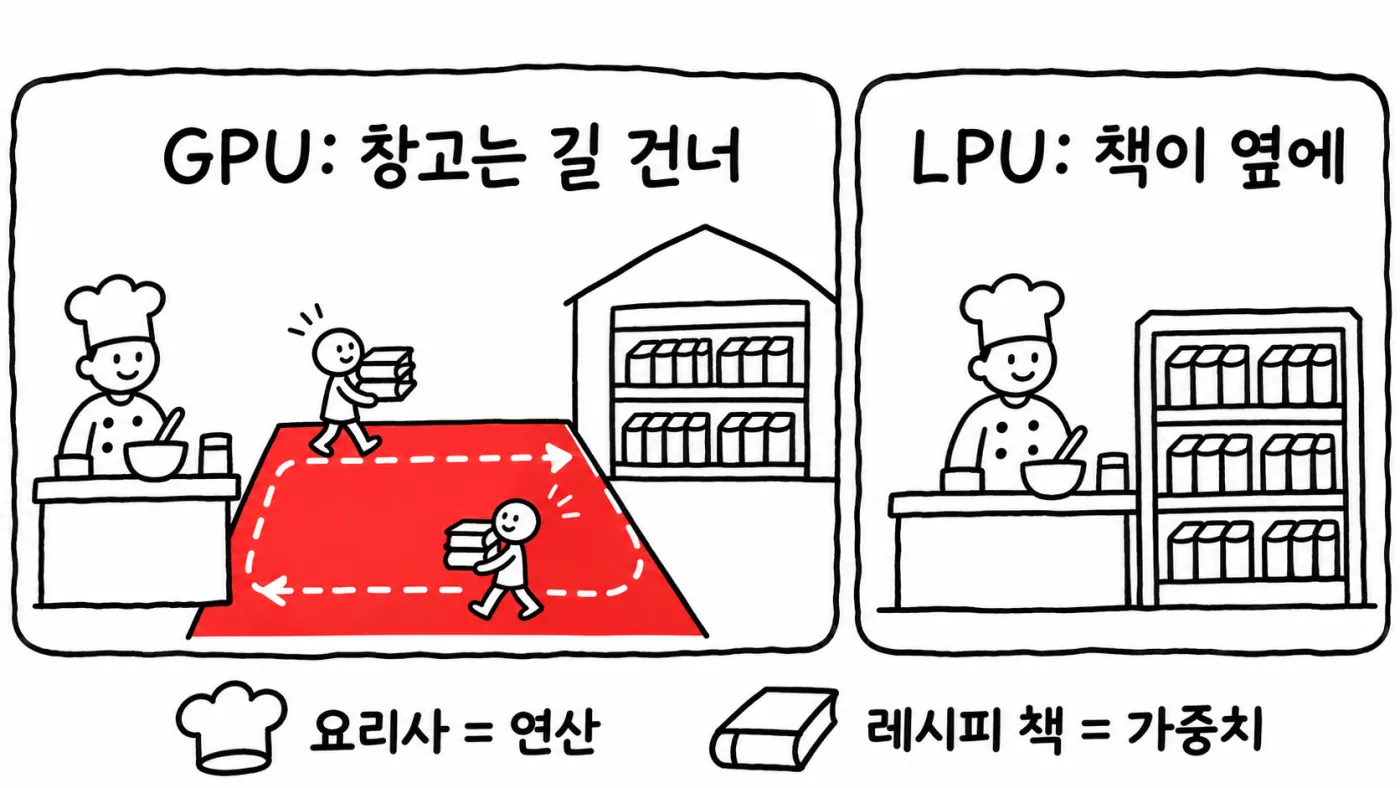
GPU는 현대 AI를 가능하게 한 뛰어난 기계이지만 다른 모양의 문제를 위해 설계되었습니다. GPU는 가중치를 **HBM(High Bandwidth Memory)**에 두는데, HBM은 칩 바로 옆 같은 보드 위에 있어 빠르지만 칩 밖에 있으므로 숫자가 선을 건너 연산 유닛(compute unit), 곧 실제로 곱하고 더하는 부분에 도달해야 합니다. 여기서 쓰는 개념이 대역폭(bandwidth), 곧 메모리가 1초에 칩에 넘겨줄 수 있는 바이트 수입니다. 대역폭이 초당 3TB이면 초당 3,000GB를 줍니다. 개념을 보이려는 어림 계산은 다음과 같습니다.
| 항목 | 값 |
|---|---|
| 70B 모델의 8비트 가중치 | 70GB |
| 토큰당 읽어야 하는 가중치 | 70GB |
| 현대 GPU의 HBM 대역폭 | 약 3TB/초 |
| 토큰 하나의 시간 | 70 / 3,000 = 약 0.023초 = 23밀리초 |
| 초당 토큰 수 | 1 / 0.023 = 약 43개 |
GPU가 한 순간도 낭비하지 않는 이상적인 경우에도 토큰 하나에 약 23밀리초가 걸리고 사용자 한 명은 초당 약 43토큰을 얻습니다. 이것이 천장이며 연산 능력을 아무리 더해도 선이 한계이므로 더 오르지 않습니다.
GPU가 현재 이 문제를 다루는 방법은 **배칭(batching)**입니다. 여러 사용자가 모일 때까지 기다렸다가 모델을 한 번 읽고 같은 이동으로 모두를 처리합니다. 창고에 한 번 다녀와서 여러 요리를 만드는 셈입니다(12.1.2 참조). 장점은 모든 사용자를 합친 초당 토큰 수, 곧 **처리량(throughput)**이 크게 오르는 것입니다. 단점은 각 사용자의 토큰 사슬이 여전히 같은 느린 속도로 움직이고, 배치를 채우려고 사용자를 기다리느라 지연이 더 늘 수 있다는 것입니다. 배칭은 높은 처리량을 주지만 한 사람의 속도를 주지는 않습니다.
GPU는 유연한 기계라서 다음 데이터를 짐작하는 캐시, 실행 중에 작업의 배치를 정하는 스케줄러, 명령을 재배열하는 대기열을 갖추고 있습니다. 프로그램의 모양을 모를 때는 유용하지만 칩 면적과 전력을 쓰고 타이밍을 예측할 수 없게 만듭니다. 그래서 문제가 두 개입니다. 모델이 너무 멀리 있고, 칩이 짐작하는 데 노력의 많은 부분을 씁니다.
고객이 LLM 응답이 느리다고 할 때는 연산 성능을 올리기 전에 토큰당 읽는 가중치 용량을 메모리 대역폭으로 나눈 값, 곧 위 천장이 현재 속도에 얼마나 가까운지를 먼저 계산해 봅니다.
12.5.2 아이디어 1: 모델을 칩 위에 둔다
첫 번째 아이디어는 말하기는 가장 쉽고 만들기는 가장 어렵습니다. 가중치를 칩 밖의 메모리에 두지 않고 칩 안에 둡니다. 칩 안에 있는 메모리가 SRAM입니다. 연산 유닛 바로 옆에 있어 숫자가 거의 이동하지 않고, 긴 선이나 별도의 메모리 칩이 없으므로 HBM보다 크게 빠릅니다. 같은 계산을 칩 안 메모리로 다시 해 보면 다음과 같습니다.
| 항목 | GPU(HBM) | LPU(SRAM) |
|---|---|---|
| 토큰당 읽어야 하는 가중치 | 70GB | 70GB |
| 대역폭 | 약 3TB/초 | 약 80TB/초 |
| 토큰 하나의 시간 | 약 23밀리초 | 70 / 80,000 = 약 0.875밀리초 |
| 초당 토큰 수 | 약 43개 | 약 1,100개(1 / 0.000875 = 약 1,143) |
같은 읽기가 23밀리초에서 1밀리초 미만으로 줄어들어 대략 27배 빠르고(원문은 약 26배로 표기했으나 23.3 / 0.875 = 26.7이므로 약 27배입니다), 초당 43토큰이 1,000토큰이 넘는 속도가 됩니다. 배칭 없이 사용자 한 명만으로 이렇습니다. 이 수치는 개념을 보이려는 어림값이며 실제는 모델, 숫자 저장 방식, 하드웨어 세대에 따라 달라지므로 정확한 자릿수보다 두 값의 차이를 기억해야 합니다.
사람이 읽는 속도는 초당 몇 단어이므로 초당 1,000토큰으로 쓰는 모델은 누구도 읽는 속도로 따라가지 못합니다. 단어가 하나씩 나타나지 않고 단락 단위로 나타납니다. 요리사가 더는 길 건너로 걷지 않고 레시피 책이 주방 조리대 위에 펼쳐져 있는 것과 같으며, LPU가 쓰는 모습을 볼 때 빠르게 느껴지는 가장 큰 이유입니다.
그렇다면 모두가 이렇게 하지 않는 이유는 칩 안의 메모리가 작기 때문입니다. SRAM은 비싸고 칩 위에서 물리적 공간을 많이 차지하며, 칩 면적은 설계자가 가진 가장 비싼 자원입니다. LPU 칩 하나에는 약 230MB가 들어 있는데 이 정도면 칩 내장 메모리로서는 넉넉하지만 큰 모델이 요구하는 크기에 비하면 아무것도 아닙니다.
| 항목 | 값 |
|---|---|
| 8비트 70B 모델의 크기 | 70,000MB |
| LPU 칩 한 개의 SRAM | 230MB |
| 필요한 칩 수 | 70,000 / 230 = 약 304.3, 곧 약 305개 |
칩 하나로는 모델을 담지 못합니다. 여기에 LPU 설계의 핵심 거래가 있으며, 메모리 크기를 포기하고 메모리 속도를 얻은 것입니다. GPU 칩은 수십 GB를 담지만 느리게 읽고, LPU 칩은 230MB만 담지만 믿기 어려울 만큼 빠르게 읽습니다. LPU는 속도를 택했고 그 대가를 감수해야 합니다. 해법은 모델을 조각내어 칩마다 한 조각씩 주는 것입니다. 언어 모델은 층이 차례로 쌓인 구조이므로 1번 칩이 처음 몇 층, 2번 칩이 다음 몇 층을 맡는 식으로 마지막 칩이 마지막 층을 맡고, 수백 개 칩이 모델 전체를 나눠 가지며 각 칩은 자기 조각을 칩 안에 영구히 보관합니다.
그러면 모델이 300개 칩에 흩어져 있을 때 칩끼리 데이터를 주고받느라 시간을 다 쓰지 않을까 하는 의문이 생깁니다. 아닙니다. 칩 하나에 있는 가중치 조각은 수백 MB로 크지만 한 칩에서 다음 칩으로 이동하는 것은 가중치가 아니라 활성값(activation), 곧 그 층들을 지난 뒤의 지금까지의 문장을 나타내는 작은 숫자 묶음입니다. 토큰 하나에 대해 그 크기는 수 KB뿐입니다. 큰 것은 가만히 있고 작은 것만 움직입니다. 많은 칩이 필요하다는 것을 받아들이는 대신 모델을 다시는 옮길 필요가 없게 하는 이 거래가 설계를 성립시킵니다.
고객이 LPU 계열 서비스를 검토한다면 한 모델에 칩이 수백 개 필요하므로 모델 크기와 양자화 방식이 칩 수와 비용을 직접 결정한다는 점부터 확인합니다.
12.5.3 아이디어 2: 추측을 없앤 결정론적 스케줄
두 번째 아이디어는 칩 자체에 관한 것입니다. 일반 프로세서는 실행 중에 판단합니다. 다음에 필요한 데이터를 짐작하는 캐시, 프로그램이 어느 쪽으로 분기할지 짐작하는 분기 예측기, 실행 중에 어느 유닛이 어느 일을 할지 정하는 스케줄러가 있고, 이 모든 일이 초당 수천 번 즉석에서 일어납니다. LPU는 이 모두를 버립니다. LPU에서는 칩에 전원이 들어오기 전에 컴파일러가 모든 것을 정합니다.
**컴파일러(compiler)**는 우리의 작업을 칩이 따를 정확한 명령으로 바꿔 주는 프로그램입니다. 일반 기계에서는 컴파일러가 명령을 준비해도 칩이 스스로 많은 판단을 하지만, LPU에서는 그 판단도 컴파일러가 미리 합니다. 여기서 **클럭 사이클(clock cycle)**이라는 낱말이 필요합니다. 모든 칩은 내부에 심장 박동이 있고 박동 한 번이 클럭 사이클 하나입니다. 현대 칩은 초당 10억 번이 넘게 뛰며 칩 내부의 모든 작은 동작은 이 박동 중 하나에서 일어납니다.
컴파일러는 모델을 완전히 압니다. 모든 층, 모든 곱셈, 이동해야 하는 모든 숫자를 알므로 어느 박동에 어느 유닛이 무엇을 하고 어느 박동에 어느 데이터가 어느 선 위에 있는지를 적은 전체 계획을 씁니다. 칩은 아무것도 결정하지 않고 계획을 따를 뿐입니다. 비유로 보면 GPU는 신호등이 있는 붐비는 교차로입니다. 차는 제각각 도착하고 신호등이 반응하며 어떤 차는 빠져나가고 어떤 차는 막히므로, 동작은 하지만 특정 차가 건너편에 언제 닿을지는 아무도 정확히 말하지 못합니다. LPU는 철도 시간표입니다. 열차는 9시에 출발해 9시 14분에 다음 역에 닿고 9시 15분에 다시 출발합니다. 그 순간에 정하는 것은 없고 모든 것이 몇 달 전에 정해졌으며 계획이 지켜지도록 망 전체가 만들어져 있습니다.
이 방식은 두 가지 이득을 줍니다.
- 칩 면적을 되찾습니다. 캐시, 예측기, 스케줄러에 쓰였을 칩 공간이 모두 자유로워져 더 많은 연산 유닛과 SRAM에 쓰입니다. 짐작하는 데 쓰는 자원이 없습니다.
- 타이밍이 정확해집니다. LPU에 요청이 얼마나 걸리는지 물으면 실행하기 전에 클럭 사이클 단위까지 답할 수 있습니다. 이런 예측 가능성은 일반 칩에서는 얻기 어렵습니다.
이 접근이 **결정론적 실행(deterministic execution)**이며, 같은 일이 항상 정확히 같은 시간이 걸리고 우연에 맡기는 것이 없다는 뜻입니다. 하드웨어가 스스로 하던 일을 소프트웨어 계획이 하므로 소프트웨어 정의 하드웨어라고도 부릅니다.
고객이 "응답 시간이 일정해야 한다"고 요구한다면 평균이 아니라 가장 느린 경우의 지연이 어떻게 나오는지를 묻고, 실행 중에 타이밍이 흔들리는 구조인지 미리 계획된 구조인지를 구분합니다.
12.5.4 아이디어 3: 기다리지 않는 네트워크
칩이 수백 개이고 각각 모델의 한 조각을 들고 있으므로, 토큰 하나마다 칩끼리 대화해야 합니다. 보통 칩들은 컴퓨터가 네트워크에서 말하듯 대화합니다. 한 칩이 메시지를 보내고 다른 칩이 받았다고 응답하며, 두 메시지가 같은 순간에 도착하면 하나는 기다려야 하고, 대기열이 가득 차기도 합니다. 이런 작은 사건마다 작은 지연이 붙고 그 크기를 미리 말할 수 없으며, 데이터가 수백 개의 칩을 차례로 지나면 작은 지연들이 쌓여 큰 지연이 됩니다.
LPU는 다르게 처리합니다. 모든 칩이 동기화된 클럭으로 동작하고, 컴파일러가 칩 내부의 이동을 계획하듯 칩 사이의 이동도 정확히 계획합니다. 7번 칩은 4,120번째 사이클에 6번 칩의 데이터가 특정 선으로 도착한다는 것을 압니다. 묻지도, 기다리지도, 확인하지도 않고 그 사이클에 손을 뻗으면 데이터가 있습니다. 악수(handshake)도, 수신 확인(acknowledgement)도, 재시도(retry)도 없는데 불확실한 것이 없기 때문입니다. 이 덕분에 작은 칩 수백 개로 이루어졌어도 기계는 하나의 큰 칩처럼 동작합니다.
세 아이디어를 합치면 자동차 공장의 조립 라인이 됩니다. 1번 스테이션은 프레임을, 2번은 엔진을, 3번은 문을 달고, 차가 스테이션을 옮겨 가며 각 스테이션에는 자기 공구가 곁에 영구히 놓여 있습니다.
| 조립 라인 | LPU |
|---|---|
| 스테이션 | 칩 하나 |
| 스테이션에 영구히 놓인 공구 | 칩에 놓인 모델 가중치 조각 |
| 라인을 따라 움직이는 자동차 | 활성값, 곧 작은 숫자 묶음 |
| 어느 스테이션이 몇 초에 무엇을 할지 적은 공장 일정 | 컴파일러 |
활성값은 첫 칩에 들어가 그 층들을 지나 둘째 칩으로 가고, 마지막 칩에서 다음 토큰으로 나올 때까지 앞으로 흐릅니다. 또 하나의 이점은 1번 칩이 2번 칩에 작업을 넘기는 순간 자유로워진다는 것입니다. 토큰이 전체 여정을 마치기를 놀며 기다리지 않고 곧바로 다음 요청을 시작하므로 라인은 항상 차 있습니다. 실제 조립 라인과 같습니다.
요청 하나가 처음부터 끝까지 가는 과정은 다음과 같습니다.
- 모델 적재(한 번): 요청이 오기 한참 전에 컴파일러가 계획을 준비하고 모델이 칩들에 퍼집니다. 각 칩이 자기 조각을 자기 SRAM에 올리며, 이후 가중치는 다시 움직이지 않습니다.
- 프롬프트 읽기(prefill): "The capital of France is"의 모든 단어는 이미 알려져 있으므로 기다릴 사슬이 없어 모든 단어를 한꺼번에 기계에 밀어 넣을 수 있습니다. 이 첫 단계가 Prefill입니다. 여러 단어가 함께 이동하므로 가중치를 한 번 읽는 일이 모든 단어에 동시에 쓸모가 있습니다. 그래서 Prefill은 메모리 바운드가 아니라 컴퓨트 바운드이며 GPU도 잘 처리합니다. 큰 서빙 시스템이 이 차이를 이용해 두 단계를 서로 다른 기계에서 돌리기도 합니다.
- 첫 토큰 생성: 숫자가 1번, 2번, 3번 칩을 지나 라인의 모든 칩을 거치고 마지막 칩에서 토큰 "Paris"가 나옵니다. 요청부터 이 첫 단어까지의 시간이 **첫 토큰까지의 시간(time to first token)**이고, 이런 대기 시간을 일반적으로 **지연(latency)**이라 부릅니다.
- 토큰 되먹임(decode): "Paris"를 문장에 붙이고 다음 토큰을 만들려고 전체 여정을 반복합니다. 한 번에 토큰 하나씩 만드는 이 단계가 **디코드(decode)**이며 앞서 본 메모리 바운드 단계입니다. 모델 전체를 한 번 지나도 단어 하나만 나오는 이것이 GPU에서 느린 부분이고 LPU가 고치려고 만들어진 부분입니다. 같은 문제를 소프트웨어로 공격하는 방법으로, 한 번의 이동에서 여러 토큰을 만드는 투기적 디코딩(speculative decoding)이 있습니다.
- 반복: 라인을 한 번 지날 때마다 정확히 토큰 하나가 나옵니다. 가중치가 이미 칩 안에 있고 모든 이동이 미리 계획되어 있으므로 이동 한 번이 아주 짧고 단어가 매끄럽고 빠른 스트림으로 화면에 나타납니다.
- 종료: 어느 시점에 모델이 답이 끝났음을 뜻하는 특수 토큰을 내면 반복이 끝납니다.
고객이 응답이 "첫 글자까지 느린 것"인지 "글자가 나오는 속도가 느린 것"인지는 Prefill과 디코드 가운데 어느 쪽이 병목인지를 가르는 질문이며, 이에 따라 대응책이 달라집니다.
12.5.5 LPU가 잘 맞는 곳과 아닌 곳
LPU가 빠른 이유를 한 곳에 모으면 다음 여섯 가지입니다.
- 가중치가 이동하지 않습니다. 칩 안 SRAM에 있으므로 전체 과정에서 가장 느린 단계가 사라집니다.
- 작은 것만 움직입니다. 활성값은 수 KB이고 가중치는 수 GB입니다.
- 짐작에 쓰는 것이 없습니다. 캐시와 예측기가 없어 그 칩 공간이 실제 일을 합니다.
- 타이밍을 발견하지 않고 계획합니다. 컴파일러가 모든 사이클을 미리 알아 다음에 무엇을 할지 알아내려고 기다리는 유닛이 없습니다.
- 칩끼리 협상하지 않습니다. 하나의 클럭을 공유하므로 데이터가 준비됐는지 묻는 칩도, 줄에서 기다리는 칩도 없습니다.
- 라인이 계속 차 있습니다. 칩이 자기 몫을 끝내면 곧바로 다음 요청을 시작합니다.
그 결과 사용자 한 명이 배치가 차기를 기다리지 않고도 초당 수십 개가 아니라 수백 개 이상의 토큰을 봅니다.
잘 맞는 곳은 응답 속도를 사용자가 직접 느끼는 곳입니다.
- 채팅 애플리케이션: 답이 천천히 타이핑되지 않고 즉시 나타나야 합니다.
- 음성 비서와 실시간 번역: 0.5초의 지연도 바로 느껴집니다.
- AI 에이전트: 모델이 검색이나 계산기 같은 도구를 쓰고 결과를 읽고 다시 생각해 다른 도구를 씁니다. 작업 하나에 모델이 여러 번 돌므로 절약한 밀리초가 여러 번 곱해집니다.
- 추론(reasoning) 모델: 최종 답 전에 긴 사고 토큰 사슬을 만듭니다. 추론에 2,000토큰을 써야 하는 모델은 토큰 속도가 모든 것을 결정하는 경우입니다.
- 타이밍이 예측 가능해야 하는 워크로드: 컴파일러가 정확한 지연을 미리 알려 줄 수 있습니다.
잘 맞지 않는 곳도 솔직하게 짚어야 합니다.
- 모델을 학습시키지 못합니다. 학습은 가중치를 계속 바꾸고, 각 가중치를 어떻게 고칠지 기록하는 보조 숫자도 많이 저장해야 합니다. 훨씬 많은 메모리가 필요하고 가중치가 가만히 있어 주지 않습니다. LPU는 가중치가 바뀌지 않는다는 정반대의 가정 위에 만들어졌습니다.
- 모델 하나에 많은 칩이 필요합니다. 칩 안 메모리가 작아 큰 모델은 수백 개 칩이 있어야 돌 수 있으며 작은 구성은 없습니다.
- 유연하지 않습니다. 모든 것이 미리 계획되므로 새 모델이나 숫자 저장 방식의 변경만으로도 계획 전체를 다시 만들어야 합니다. GPU는 던져 주는 거의 무엇이든 곧바로 받아들입니다.
- 긴 대화가 메모리에 압박을 줍니다. 생성 중 모델은 이미 읽은 모든 내용의 요약을 저장하여 과거를 다시 읽지 않게 하는 KV 캐시(KV cache)(10.3 참조)를 유지하며, 이 캐시는 같은 귀한 칩 안 메모리에 있고 대화 길이에 따라 커집니다.
- 토큰당 비용은 다른 문제입니다. 밤사이 문서 100만 건을 읽고 라벨을 붙이는 것처럼 기다리는 사람이 없는 작업은, 아주 큰 배치로 서빙하는 GPU가 같은 일에 더 쌀 수 있습니다. 거기서 지연은 전혀 중요하지 않고 총 출력만 중요합니다.
기다리는 사람이 있는지로 가르는 기준은 12.1.5의 온라인 서빙과 배치 서빙의 구분과 같으며, 고객 워크로드를 이 질문으로 나눈 뒤에 하드웨어를 고릅니다.
12.5.6 LPU vs GPU
| 항목 | GPU | LPU |
|---|---|---|
| 목적 | 모든 병렬 수학, 학습과 추론 | 학습된 언어 모델 실행 |
| 가중치 위치 | HBM, 칩 옆 | SRAM, 칩 안 |
| 메모리 속도 | 약 3TB/초 | 약 80TB/초 |
| 칩당 메모리 크기 | 수십 GB | 약 230MB |
| 큰 모델에 필요한 칩 수 | 몇 개 | 수백 개 |
| 작업을 계획하는 주체 | 실행 중의 하드웨어 | 실행 전의 컴파일러 |
| 캐시와 분기 예측 | 있음 | 없음 |
| 칩 사이 통신 | 메시지, 대기와 응답 있음 | 하나의 공유 클럭, 대기 없음 |
| 타이밍 | 실행마다 달라짐 | 정확하고 미리 알려짐 |
| 사용자 한 명의 속도 | 보통 | 높음, 응답이 빠름 |
| 배칭 | 좋은 총 출력을 위해 필요 | 좋은 속도를 위해 필요 없음 |
| 학습 지원 | 있음 | 없음 |
| 유연성 | 높음 | 낮음, 모든 것이 미리 계획됨 |
언제 무엇을 쓸지의 기준은 다음과 같습니다.
- GPU: 모델을 학습시킬 때, 자주 바꿔 가며 실험할 때, 같은 기계에서 여러 종류의 모델을 돌릴 때, 출력을 기다리는 사람이 없는 큰 배치 작업을 돌릴 때 씁니다. GPU에 머무를 때는 TensorRT-LLM 같은 엔진이 그 하드웨어가 줄 수 있는 대부분을 짜냅니다.
- LPU: 모델이 고정되어 있고 이미 학습되었으며 사용자가 실제로 체감하는 것이 답의 속도일 때 씁니다. 채팅, 음성, 에이전트, 추론 모델이 여기에 속합니다.
교훈은 칩 하나를 넘어섭니다. 지난 몇 년 동안 모델을 빠르게 만드는 방법은 연산 능력을 더하는 것이었지만, 워크로드가 메모리 바운드가 되면 이기는 길은 더 많이 계산하는 것이 아니라 데이터를 덜 옮기는 것입니다. 숫자와 연산 사이의 거리를 줄이고 모든 이동을 미리 계획하면 같은 수학이 여러 배 빨리 끝납니다. 고객 제안에서도 병목이 연산인지 메모리 이동인지를 먼저 판별하고, 후자라면 더 큰 GPU를 사기 전에 양자화, 배칭 정책, 전용 칩 같은 데이터 이동을 줄이는 선택지를 비교합니다.
12.6 클라우드 vs 온디바이스 배포
원문: Cloud vs On-device Model Deployment
모델은 만들어진 직후에는 컴퓨터 안의 큰 파일일 뿐이며, 어디에서 실행하느냐가 정해져야 사용자에게 닿습니다. 이 절은 그 위치 선택(클라우드, 온디바이스, 둘의 혼합)을 지연, 개인정보, 모델 크기, 비용, 배포, 오프라인 여섯 축으로 비교합니다. 이 비교는 2026년 8월 글 기준이며, 10.11의 로컬 실행을 배포 전략의 관점에서 다시 보는 절입니다.
12.6.1 왕복 지연(round trip)
**배포(deployment)**는 모델을 실제 사용자가 쓸 수 있는 곳에 두는 일이며, "배포 = 모델 + 모델이 실행되는 장소"로 표현됩니다. 장소는 크게 둘입니다. 데이터센터의 강력한 서버에 모델을 두고 인터넷으로 접근하게 하는 클라우드 배포, 그리고 폰·노트북·자동차·카메라 같은 사용자 기기 안에 모델을 넣는 온디바이스 배포입니다. 기기가 네트워크의 가장자리(사용자 곁)에 있으므로 엣지(Edge) 배포라고도 부르며, 여기서 기기는 스마트워치, 보안 카메라, 스마트 스피커, 공장의 작은 센서까지 포함합니다.
두 방식을 비교하기 전에 질문을 좁혀야 합니다. 모델의 생애에는 학습(대량의 데이터를 반복해 보여 주며 스스로 조정하게 하는 무거운 단계, 수천 대 기계가 몇 주 도는 규모)과 추론(학습이 끝난 모델이 질문 하나에 답 하나를 내는 가벼운 단계)이 있습니다. 비유하면 학습은 몇 년 걸리는 공부이고 추론은 시험장에서 한 문제에 답하는 일이어서, 공부에는 대학이 필요하지만 답안 작성에는 펜 한 자루면 됩니다. 학습은 거의 항상 클라우드에서 하므로, 이 절의 비교 대상은 모두 추론입니다. 곧 "실제 사용자가 질문할 때 모델은 어디에서 도는가"가 질문입니다.
두 방식의 근본 차이는 한 문장으로 줄어듭니다.
- 클라우드 배포에서는 데이터가 모델로 이동합니다. 모델 사본은 데이터센터에 하나이고, 사용자 데이터가 요청마다 그곳으로 갑니다.
- 온디바이스 배포에서는 모델이 데이터로 이동합니다. 모델 사본을 기기마다 한 번 배포하고 나면 데이터는 어디로도 가지 않습니다.
flowchart LR
  subgraph C[클라우드: 데이터가 이동]
    U1[사용자 1] --> M[큰 모델 1개]
    U2[사용자 2] --> M
    U3[사용자 3] --> M
  end
  subgraph D[온디바이스: 모델이 이동]
    D1[사용자 1 + 모델 사본]
    D2[사용자 2 + 모델 사본]
    D3[사용자 3 + 모델 사본]
  end
그림: 클라우드는 하나의 모델로 화살표가 모이고, 온디바이스는 밖으로 나가는 화살표가 없습니다.
속도에서 이 차이가 가장 먼저 드러납니다. 클라우드로 질문을 보내면 데이터가 폰에서 기지국, 여러 케이블(때로 대양 횡단), 데이터센터까지 물리적으로 이동하고, 답이 같은 경로로 돌아옵니다. 모델이 생각을 시작하기도 전에 좋은 연결에서 대략 50~200밀리초가 든다고 원문은 설명합니다. 실제 값은 거리와 망 상태에 따라 달라지는 어림값입니다. 연결이 약하면 훨씬 길어집니다. 온디바이스는 질문이 기기 안의 한 부분에서 다른 부분으로 옮겨 갈 뿐이므로 이 왕복이 없습니다.
채팅 앱에서 200밀리초는 사용자가 알아채지 못합니다. 그러나 자율주행에서는 사정이 다릅니다. 시속 100km 차량은 초속 약 27.8m로 움직이므로 카메라가 아이를 본 뒤 클라우드 응답을 200밀리초 기다리면 약 5.6m를 눈을 감고 달립니다(원문은 약 5m로 서술). 네트워크가 2초 끊기면 55m 넘게 앞을 못 봅니다. 통화 중 소음 제거, 실시간 카메라 효과, 키보드 추천, 얼굴 잠금 해제도 즉각적이어야 하므로 기기에서 돌립니다.
- 판단 규칙 1: 답이 즉각적이어야 하거나 네트워크를 믿을 수 없으면 온디바이스로 갑니다.
고객이 "응답이 느리다"고 말할 때 FDE는 모델 속도보다 먼저 왕복 지연이 전체 시간에서 차지하는 비중과, 그 지연이 사용자 경험이나 안전에 실제로 문제가 되는 업무인지 확인해야 합니다.
12.6.2 데이터의 행방
클라우드 배포에서 사용자의 음성, 사진, 메시지, 의료 보고서는 인터넷을 건너 어떤 회사의 기계에 도착합니다. 그 회사가 암호화하고 빨리 삭제하더라도 데이터가 사용자의 손을 떠났다는 사실은 남습니다. 온디바이스에서는 가로챌 것도, 유출될 것도, 서버에 저장될 것도 없습니다. 사용자가 우리를 믿을 필요조차 없는 것은 애초에 우리가 데이터를 받지 않았기 때문입니다.
병원 앱의 환자 보고서 판독, 은행 앱의 고객 서류 판독, 입력한 모든 글을 보는 키보드, 가족 사진을 보는 사진 앱이 민감한 사례이며, 데이터가 이동할 수 있는 곳을 법으로 제한하는 나라도 많습니다.
여기에 세 번째 선택지가 있습니다. 온프레미스(on-premise) 배포는 회사가 자기 건물 안의 자기 서버에서 모델을 돌리는 방식입니다. 데이터는 기기를 떠나지만 회사 내부망 안에만 머물고 외부 회사에는 닿지 않습니다. 온디바이스의 프라이버시와 클라우드의 성능을 함께 얻는 대신 비싼 하드웨어를 직접 사서 운영해야 하며, 병원·은행·정부 부처가 많이 씁니다. 이는 온디바이스와 다른 개념입니다.
| 방식 | 데이터 경로 | 결과 |
|---|---|---|
| 온디바이스 | 기기 안에 머묾 | 기기를 떠나지 않음 |
| 온프레미스 | 기기 → 회사 자체 서버 | 기기는 떠나지만 회사 안에 머묾 |
| 클라우드 | 기기 → 다른 회사 서버 | 기기와 회사 모두 떠남 |
프라이버시는 예/아니오가 아니라 거리입니다. 데이터가 가는 길이 짧을수록 샐 수 있는 곳이 줄어듭니다.
- 판단 규칙 2: 데이터가 깊이 개인적이거나 법이 이동을 제한하면 온디바이스(또는 온프레미스)로 갑니다.
고객 미팅에서는 "이 데이터가 어느 경계를 넘어도 되는가"를 먼저 묻고, 그 경계가 기기인지 조직인지에 따라 세 방식 중 후보를 좁힙니다.
12.6.3 모델 크기 한계
모델 크기에서는 클라우드가 분명히 앞섭니다. 클라우드 서버는 GPU 같은 특수 칩(12.2 참조) 여러 개와 수백 GB의 빠른 메모리, 배터리 걱정 없는 전원을 갖추어 수천억 파라미터 모델도 돌립니다. **파라미터(parameter)**는 학습 중 모델이 익힌 내부 숫자이며, 많을수록 대체로 아는 것도 추론력도 늘지만 모델 파일이 커지고 실행에 필요한 메모리도 늘어납니다.
폰은 전혀 다른 세계입니다. 배터리가 작고, 메모리는 다른 앱과 나눠 쓰며, 손에서 뜨거워지면 안 됩니다. 폰에서 편하게 도는 모델은 많아야 수십억 파라미터이고 그마저 압축해야 합니다. 원문이 이해를 돕기 위해 든 크기는 큰 클라우드 모델이 수백 GB, 폰에 들어가는 모델이 수백 MB~수 GB로, 격차가 큽니다.
기기에 맞추는 대표 기법은 셋입니다.
- 양자화(Quantization): 모델의 숫자를 낮은 정밀도로 저장합니다. 16비트 대신 4비트를 쓰면 크기가 4분의 1이 되면서 품질 대부분을 유지합니다(10.8 참조). 예컨대 20억 파라미터 모델은 16비트에서 약 4GB, 4비트에서 약 1GB입니다(파라미터 수 × 비트 수 ÷ 8로 계산한 가정 예시).
- 가지치기(Pruning): 기여가 작은 부분을 제거합니다. 열매 없는 가지를 쳐내는 것과 같습니다.
- 증류(Distillation): 작은 모델이 큰 모델의 행동을 따라 하도록 학습시킵니다. 학생이 교수에게 직접 배우는 것과 같습니다(11.4 참조).
flowchart TB
  A[큰 클라우드 모델: 수백 GB] -->|양자화: 숫자당 비트 감소| B[압축 과정]
  A -->|가지치기: 기여 작은 부분 제거| B
  A -->|증류: 작은 복사본 학습| B
  B --> C[작은 온디바이스 모델: 수 GB 이하]
그림: 큰 모델이 압축 과정을 거쳐야 폰에 들어갑니다.
이 기법들은 효과가 크지만 마법은 아닙니다. 압축한 작은 모델은 어려운 추론, 긴 문서, 깊은 세계 지식에서 거대한 클라우드 모델을 따라가지 못합니다. 다만 소형 언어 모델(3.1 참조)이 해마다 좋아지고 폰 칩도 강해져서, 몇 해 전에는 거대 모델이 필요했던 일을 오늘의 작은 모델이 하기도 합니다. 지금 클라우드로 가야 하는 작업이 내일은 기기에서 돌 수 있습니다.
- 판단 규칙 3: 작업이 최고 수준의 지능을 요구하면 클라우드로 갑니다.
고객이 "기기에서 GPT급을 돌리고 싶다"고 하면, 필요한 작업이 좁고 초점이 분명한지(작은 모델로 충분한지)와 어려운 추론이 섞이는지를 먼저 가려야 합니다.
12.6.4 비용 부담 주체
비용은 이 결정을 좌우하는 경우가 많습니다. 클라우드는 서버와 요청마다 비용을 내며, 사용자 열 명은 적게 들고 천만 명은 많이 듭니다. 사용자가 늘수록 비용이 늘고 멈추지 않는 고정 지출입니다. 온디바이스는 초기에 비용이 몰립니다. 모델을 줄이고, 여러 기기에서 돌게 만들고, 곳곳에서 시험하는 엔지니어링 노력이 듭니다. 앱을 배포한 뒤에는 사용자의 기기가 계산을 하므로 답변당 비용이 0이며, 사용자 열 명이든 천만 명이든 같습니다.
| 사용자 수 | 클라우드 비용 | 온디바이스 비용 |
|---|---|---|
| 적음 | 0에 가깝게 시작, 낮음 | 초기 엔지니어링 비용으로 높게 시작 |
| 늘어남 | 사용자마다 증가 | 평평하게 유지 |
두 선이 한 점에서 교차합니다. 교차점 이전에는 클라우드가 싸고, 이후에는 클라우드가 훨씬 비싸지며 계속 오릅니다.
단서가 있습니다. 비용은 사라지지 않고 사용자에게 옮겨 갈 뿐입니다. 사용자는 배터리 소모, 저장 공간, 따뜻해진 폰으로 그 값을 치릅니다. 그러므로 온디바이스는 그럴 가치가 있을 때만 택해야 합니다.
- 판단 규칙 4: 아주 많은 사용자가 단순한 작업을 반복한다면 온디바이스가 큰 비용을 아낍니다.
- 오해 주의: 온디바이스가 항상 싸지는 않습니다. 초기 비용이 크므로 사용자가 충분히 늘기 전까지는 클라우드가 더 쌉니다.
고객의 총비용 비교에서는 월 요청 수 곱하기 요청당 단가와 초기 엔지니어링 비용을 나란히 놓고 교차점이 어느 사용자 규모에서 오는지 추정해야 합니다.
12.6.5 배포 문제
클라우드에서는 월요일 아침에 모델의 오류를 찾으면 모델을 바꾸고 오후에는 전 세계 사용자가 수정본을 씁니다. 사용자는 바뀐 줄도 모릅니다. 그래서 실험이 잦은 팀은 클라우드를 선호합니다.
온디바이스에서는 모델이 사용자가 설치한 앱 안에 있어서 두 문제가 생깁니다.
- 문제 1(내려받기): 모델이 2GB면 앱 자체가 2GB가 되어 아무도 설치하지 않거나, 첫 실행 뒤 별도로 내려받게 되어 사용자가 기다리며 모바일 데이터를 씁니다. 많은 사용자가 그 대기 중에 앱을 떠납니다.
- 문제 2(수정 지연): 새 앱 버전을 내고 기다려야 합니다. 당일 업데이트하는 사용자도, 한 달 뒤 하는 사용자도, 끝내 안 하는 사용자도 있습니다. 결함 있는 옛 모델이 실제 기기에서 오래 돌아도 손쓸 방법이 없습니다.
월요일 수정 후 수정이 닿는 사용자 비율은 원문의 예시 기준으로 클라우드가 월요일 100%이고, 온디바이스는 월요일 0%, 3일 뒤 30%, 2주 뒤 70%, 두 달 뒤 85%, 이후 90%에서 멈춥니다(원문의 예시 곡선이며 실측값이 아닙니다).
| 시점 | 클라우드 | 온디바이스 |
|---|---|---|
| 월요일 | 100% | 0% |
| 3일 뒤 | 100% | 30% |
| 2주 뒤 | 100% | 70% |
| 2달 뒤 | 100% | 85% |
| 이후 | 100% | 90%에서 정체 |
기기 자체도 우리가 통제하지 못합니다. 3년 된 보급형 폰과 새 플래그십 폰은 칩, 메모리, 속도가 다른 별개의 기계이고, 모델은 모두에서 돌아야 하며 제대로 시험하려면 품이 듭니다. 또 기기 안에서 일어난 일이라 무엇이 잘못됐는지 보기도 어렵습니다.
- 판단 규칙 5: 모델을 자주 바꿔야 하거나 큰 내려받기를 감당할 수 없으면 클라우드가 훨씬 안전합니다.
FDE는 고객 팀의 모델 교체 주기를 묻고, 월 단위로 고치는 모델을 앱 배포 주기에 묶어도 되는지, 그리고 기기별 성능을 어떻게 측정할지를 확인해야 합니다.
12.6.6 네트워크가 끊겼을 때
새 나라에 막 도착한 여행자가 심 카드도 없고 공항 와이파이도 안 되는 상태에서 읽을 수 없는 간판에 카메라를 대고 번역을 원하는 순간을 생각해 봅니다. 번역 기능이 클라우드에 있으면 스피너가 돌다가 오류가 납니다. 번역 모델이 기기에 있으면 신호가 0칸이어도 그 자리에서 뜻이 나옵니다. 클라우드 경로는 중간 고리 하나만 끊겨도 전체가 멈추지만, 온디바이스 경로에는 끊어질 고리가 없습니다.
약한 신호의 마을, 지하 주차장, 지하철 터널, 비행기 안에서도 같은 일이 벌어집니다. 가용성은 사소한 문제가 아니며, 어떤 제품은 오프라인에서 동작한다는 것이 곧 제품의 쓸모입니다.
- 판단 규칙 6: 인터넷 없이도 기능이 계속 동작해야 하면 온디바이스여야 합니다.
현장 점검에서 "연결이 끊겨도 업무가 멈추면 안 되는가"를 물어 오프라인 요구가 있는지부터 확인합니다.
12.6.7 하이브리드 접근
실제 제품에서는 하나만 고를 필요가 없습니다. 하이브리드(hybrid) 접근은 기기의 작은 모델이 쉬운 일을 처리하고, 실제로 어려운 작업일 때만 클라우드의 큰 모델을 부르는 방식입니다. 질문이 들어오면 기기 모델이 "내가 처리할 수 있는가"를 판단하여, 가능하면 기기에서 답하고 불가능하면 클라우드로 보냅니다.
flowchart TB
  Q[사용자 질문] --> S[기기의 작은 모델]
  S --> J{처리 가능한가}
  J -->|예| A1[기기에서 답변]
  J -->|아니오| C[클라우드 큰 모델] --> A2[답변]
그림: 대부분은 기기에서 끝나고 어려운 질문만 클라우드로 갑니다.
음성 비서(13.1 참조)가 전형입니다. 깨우기 단어 감지는 기기에서 항상 조용히 돌고, 단어를 듣고 나면 작은 기기 모델이 "타이머 10분", "손전등 켜줘" 같은 단순 명령을 처리하며 인터넷을 쓰지 않습니다. "장마에 관한 시를 써줘"처럼 작은 모델이 잘하지 못하는 요청은 클라우드로 보냅니다. 이 방식은 흔한 경우에 속도와 프라이버시를, 드문 어려운 경우에 완전한 지능을 줍니다. 네트워크가 끊겨도 단순한 일은 기기가 처리하므로 안전한 대비책이 되고, 그래서 진지한 제품 다수가 여기에 이릅니다. 어떤 요청을 어느 모델로 보낼지 정하는 일은 LLM 라우팅과 같은 문제입니다(3.6 참조).
변형으로 **연합 학습(Federated Learning)**이 있습니다. 모델은 클라우드에서 돌지만 학습은 기기에서 일어나는 패턴입니다. 각 기기가 자기 사용자의 데이터로 조금씩 배우고, 작은 학습 결과(업데이트)만 보내며 원본 데이터는 보내지 않습니다. 폰 키보드가 이렇게 개선됩니다. 사용자 데이터는 폰에 남고 업데이트만 클라우드로 올라가므로, 클라우드 모델은 누가 무엇을 입력했는지 보지 않고도 좋아집니다. 앞서 학습은 거의 항상 클라우드에서 한다고 했는데, 연합 학습이 그 예외입니다.
실제 기능이 어디에서 도는지는 이 틀로 판정됩니다.
| 기능 | 실행 위치 | 이유 |
|---|---|---|
| 폰 얼굴 잠금 해제 | 온디바이스 | 즉각적이어야 하고, 오프라인에서 되어야 하며, 얼굴은 개인성이 높은 데이터 |
| 키보드 단어 예측 | 온디바이스 | 키 입력마다 돌므로 네트워크 왕복이 불가능 |
| 통화 소음 제거 | 온디바이스 | 지연 없이 실시간 처리 |
| 간판 오프라인 번역 | 온디바이스 | 필요한 순간에 네트워크가 없는 경우가 많음 |
| 차량 자율주행 | 온디바이스 | 지연이나 끊김이 사고로 이어짐 |
| ChatGPT의 긴 질문 답변 | 클라우드 | 폰에 들어가지 않는 큰 모델 필요 |
| 텍스트로 이미지 생성 | 클라우드 | 작업이 무거워 폰 배터리를 빠르게 소모 |
| 단어로 내 사진 검색 | 온디바이스 또는 하이브리드 | 사진이 사적이고 색인이 이미 폰에 있음 |
| 음성 비서 | 하이브리드 | 깨우기 단어·단순 명령은 기기, 어려운 질문은 클라우드 |
| 병원의 환자 보고서 판독 | 온프레미스 | 데이터가 병원 내부망을 벗어날 수 없음 |
패턴은 분명합니다. 즉각적이거나 사적이거나 오프라인이어야 하는 것은 기기로, 깊은 지능이 필요한 것은 클라우드로 갑니다. 둘 다 필요하면 하이브리드가 됩니다. 아래는 두 방식과 선택 기준의 전체 비교입니다.
| 항목 | 클라우드 | 온디바이스 |
|---|---|---|
| 모델 실행 위치 | 데이터센터 서버 | 사용자 기기 안 |
| 데이터 경로 | 인터넷으로 서버까지 이동 | 기기를 떠나지 않음 |
| 인터넷 필요 | 항상 필요 | 불필요 |
| 속도 | 네트워크 왕복으로 느림 | 왕복 없어 빠름 |
| 모델 크기 | 수천억 파라미터급의 큰 모델 | 많아야 수십억, 압축 필요 |
| 답변 품질 | 가장 강한 모델이라 최고 | 좁은 작업에 충분, 어려운 추론에 약함 |
| 프라이버시 | 데이터가 사용자 손을 떠나 약함 | 데이터가 사용자에게 남아 강함 |
| 우리의 비용 | 요청마다 영구 지불 | 대체로 일회성 엔지니어링 |
| 사용자의 비용 | 인터넷 데이터뿐 | 배터리, 저장 공간, 발열 |
| 모델 갱신 | 서버만 바꾸면 모두에게 즉시 | 앱 업데이트 필요, 지연 많음 |
| 하드웨어 차이 | 기계 한 종류 | 수천 종 기기에서 동작해야 함 |
| 가시성 | 로그로 확인, 빠른 수정 | 기기 안에서 일어난 일은 파악 어려움 |
| 적합한 용도 | 어려운 추론, 긴 문서, 생성, 풍부한 지식 | 즉각적, 사적, 반복적, 오프라인 작업 |
선택 기준을 방식별로 모으면 다음과 같습니다.
- 클라우드: 최강 모델이 필요한 작업, 사용자가 이미 온라인인 웹 환경, 모델을 자주 개선해 즉시 배포해야 할 때, 사용자 수가 적어 서버 비용이 감당될 때, 모델이 기기에 들어갈 수 없을 때, 로그를 보며 품질을 측정하고 고쳐야 할 때
- 온디바이스: 카메라 효과·키보드 추천·차량 반응처럼 즉각적이어야 할 때, 건강 기록·개인 사진·입력 내용처럼 개인성이 높은 데이터일 때, 인터넷 없이 동작해야 할 때, 같은 단순 작업을 하는 사용자가 아주 많아 클라우드 비용이 과중할 때, 작업이 좁고 초점이 분명해 작은 모델로 충분할 때
- 하이브리드: 대부분 요청이 쉽고 일부만 어려울 때, 흔한 경우의 프라이버시와 속도를 챙기면서 드문 경우의 품질도 포기하지 않으려 할 때, 네트워크가 끊겨도 기본 기능이 이어져야 할 때
- 온프레미스: 환자 기록이나 은행 문서처럼 데이터가 법적으로 조직 밖에 나갈 수 없을 때, 큰 모델의 성능은 필요한데 외부 회사에 데이터를 보낼 수 없을 때, 조직이 하드웨어를 구매·운영할 만큼 클 때
고객에게 배포 위치를 권할 때는 여섯 규칙(즉각성, 데이터 경계, 필요한 지능, 사용자 규모, 갱신 빈도, 오프라인)을 순서대로 묻고, 한 가지로 정해지지 않으면 하이브리드를 기본 후보로 삼는 것이 안전합니다. 지금의 경계는 소형 모델과 기기 칩의 발전에 따라 해마다 이동합니다.
12.7 고객이 내일 묻는다면
각 질문에 소리 내어 답해보고, 막히면 표시된 절로 돌아가십시오. 통과 기준은 "내일 고객이 물어도 설명하고 결정할 수 있는가"입니다.
- "모델은 이미 학습해 놨으니 바로 서비스에 붙이면 되죠?" 파일과 서비스 사이에 무엇이 비어 있는지 말해 보십시오. (12.1, 12.1.1)
- "사용자가 몰리면 응답이 느려지는데 GPU를 더 사야 하나요?" 배칭과 복제본 중 무엇을 먼저 확인하고 지연과 처리량은 어떻게 갈립니까? (12.1.2, 12.1.3, 12.1.4)
- "새 버전 모델을 올렸더니 결과가 이상한데 어떻게 알 수 있었을까요?" 무엇을 보고 어떻게 되돌립니까? (12.1.6)
- "70억 파라미터 모델을 24GB GPU에 올릴 수 있나요?" 어떤 계산으로 답하고, 안 들어가면 어떤 선택지가 있습니까? (12.2.4, 12.2.5, 12.2.7)
- "GPU 사양서를 보니 코어 수는 같은데 가격이 두 배 차이 납니다. 무엇을 봐야 하죠?" (12.2.3, 12.2.5)
- "GPU를 샀는데 기대만큼 빠르지 않습니다. 코드 쪽에서 어디를 의심할까요?" 스레드 구성, 분기, 데이터 복사 중 무엇을 묻습니까? (12.3.1, 12.3.2, 12.3.6)
- "커널 안에서 스레드가 서로 다른 데이터를 어떻게 구분하죠? 메모리는 어느 것을 써야 하나요?" (12.3.4, 12.3.5)
- "구글 클라우드에서 TPU를 쓰라는데 GPU와 뭐가 다르고 어디까지 믿을 수 있나요?" (12.4.2, 12.4.4, 12.4.5)
- "70B 모델을 챗봇으로 쓰는데 한 사용자의 응답이 초당 몇 토큰이 한계인가요?" 어떤 두 숫자로 천장을 계산합니까? (12.5.1)
- "Groq 같은 LPU로 바꾸면 모든 게 해결되나요?" 잘 맞는 곳과 맞지 않는 곳을 가르는 기준은 무엇입니까? (12.5.5, 12.5.6)
- "고객 상담 앱의 AI를 폰에서 돌리고 싶은데 괜찮을까요?" 왕복 지연, 모델 크기, 개인정보 중 무엇부터 묻습니까? (12.6.1, 12.6.2, 12.6.3)
- "클라우드 비용이 매달 늘어나는데 온디바이스로 옮기면 공짜인가요?" 누가 무엇을 부담하게 됩니까? (12.6.4, 12.6.5)
- "지하철에서 인터넷이 끊겨도 기능이 돌아야 합니다." 어떤 구조를 권하고 요청은 어떻게 나눕니까? (12.6.6, 12.6.7)